StepAudio 3
StepFuns nya familj av ljudmodeller: realtidssamtal med röst, talsyntes, taligenkänning, ljud- och musikgenerering, tillgängliga via StepFuns API.
- Röstassistent
- Text till tal
- Tal till text
- Röstkloning
- Musik & ljud
 1 / 5
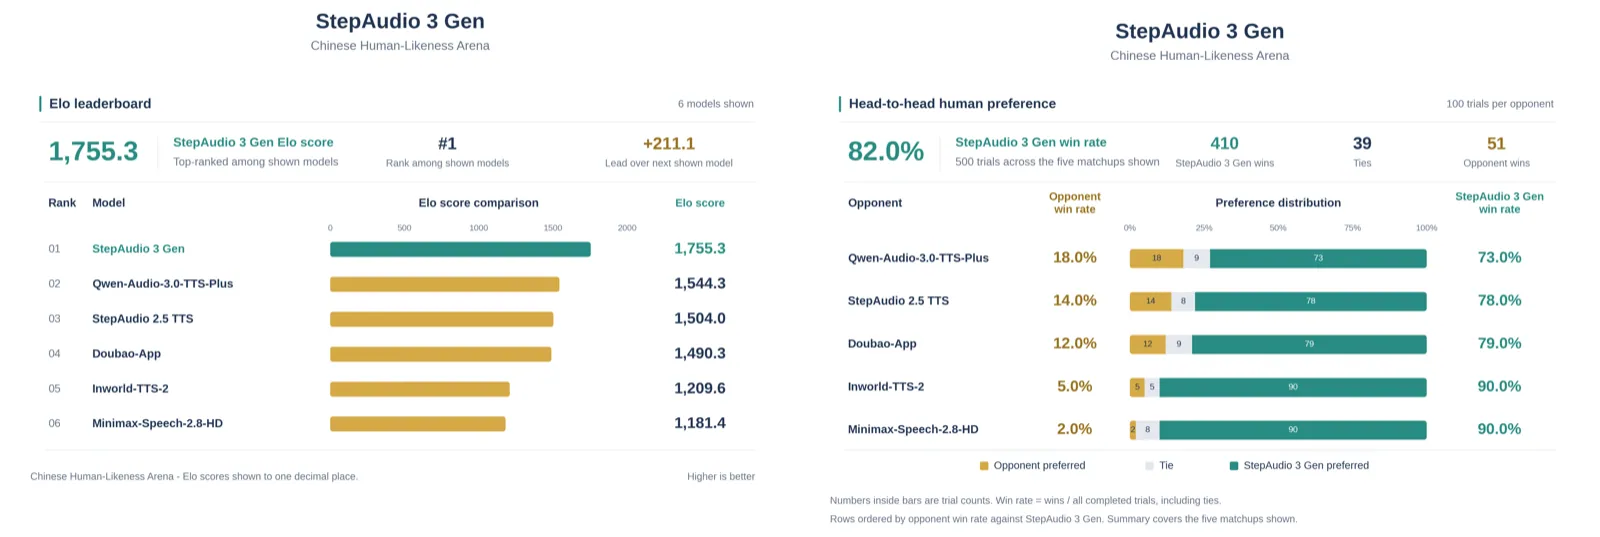
StepFuns jämförelse av hur mänskligt talet låter på kinesiska, där StepAudio 3 Gen leder [3]
Om StepAudio 3[1][2][3][4][5][6][7][8][9][10][11]
StepAudio 3 är StepFuns samlingsnamn för en ny generation ljudmodeller, presenterade i september 2026 på en gemensam sida med fem delar. Flera av dem är än så länge förhandsversioner som är gratis att prova under en begränsad tid via StepFuns API, och som enligt dokumentationen ska ersättas av betalversioner.
StepAudio 3 Realtime är en röstmodell för samtal i realtid där båda parter kan prata samtidigt. Den hör tonläge, känslor och bakgrundsljud, går att avbryta och kan tänka medan den pratar (Think-While-Speaking). Den kan också söka på webben och använda verktyg i bakgrunden utan att samtalet stannar. Enligt den tekniska rapporten får den 90,6 på testet MMSU och 98,9 på Artificial Analysis Full-Duplex Bench.
StepAudio 3 Gen skapar ljud från en beskrivning på vanligt språk: flera röster i samma dialog med känslor, skratt och pauser, men också ljudeffekter, bakgrundsljud, musik och sång, allt i samma ljudspår. StepAudio 3 TTS gör om text till naturligt tal med strömning och röstkloning. StepAudio 3 ASR Max är StepFuns största taligenkänningsmodell hittills, för kinesiska, engelska, dialekter och blandat kinesiska-engelska, och klarar enligt StepFun facktermer, viskningar och brusigt ljud. StepAudio 3 Music gör hela låtar med sång från text och sångtext; den planerar först låtens struktur och genererar sedan ljudet.
StepFun har inte släppt vikterna till StepAudio 3 på Hugging Face. Modellerna nås via API:t, och webbverktyget Voice Studio är aviserat men inte öppnat.
Det viktigaste[3][5][6][7][8][9][10]
- Fem delar: Realtime (röstsamtal), Gen (ljud från beskrivning), TTS (talsyntes), ASR (taligenkänning) och Music (musik).
- Realtime kan tänka medan den pratar och använda verktyg i bakgrunden; enligt StepFun får den 98,9 på Artificial Analysis Full-Duplex Bench.
- Enligt StepFun leder StepAudio 3 Gen en kinesisk jämförelse av hur mänskligt talet låter, med Elo 1 755 före Qwen-Audio-3.0-TTS-Plus.
- Enligt StepFun gör ASR Max 43 % färre fel än Doubao ASR 2.0 på uppgifter som kräver sammanhangsförståelse.
- Pris: talsyntes 0,36 USD per 10 000 tecken, taligenkänning 0,24 USD per ljudtimme; Realtime, Gen och Music är gratis förhandsversioner.
- Inga öppna vikter; modellerna nås via StepFuns API.
Källor
- [1]
- [2] StepAudio 3 Realtime ↗StepFun Officiell sida static.stepfun.comPublicerad okänt datum Läst 25 okt 2026
- [3]
- [4] StepAudio 3 Music ↗StepFun Officiell sida static.stepfun.comPublicerad okänt datum Läst 25 okt 2026
- [6] StepAudio 3 Realtime ↗StepFun (API-plattform) Officiell sida platform.stepfun.aiPublicerad okänt datum Läst 25 okt 2026
- [7] StepAudio 3 TTS ↗StepFun (API-plattform) Officiell sida platform.stepfun.aiPublicerad okänt datum Läst 25 okt 2026
- [8] StepAudio 3 ASR ↗StepFun (API-plattform) Officiell sida platform.stepfun.aiPublicerad okänt datum Läst 25 okt 2026
- [9] StepAudio 3 Gen ↗StepFun (API-plattform) Officiell sida platform.stepfun.aiPublicerad okänt datum Läst 25 okt 2026
- [10] StepAudio 3 Music ↗StepFun (API-plattform) Officiell sida platform.stepfun.aiPublicerad okänt datum Läst 25 okt 2026
- [11] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [5] StepAudio 3 Realtime Technical Report ↗arXiv Forskningsartikel arxiv.orgPublicerad 12 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-20). [11]
Placeringar i topplistor
- Artificial Analysis Speech to TextTranskriberingsläget (StepAudio 3 ASR)#8 · 2,5 %
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från StepFun
- Step 5 Preview sep 2026
- MMPhysVideo 3 apr 2026