Olmo-core 3
Ai2:s öppna programvara för att träna mycket stora AI-modeller av typen mixture of experts, byggd för att räcka ända upp till biljonklassen utan att träningen blir ineffektiv.
- Språkmodell
- Forskning & vetenskap
 1 / 3
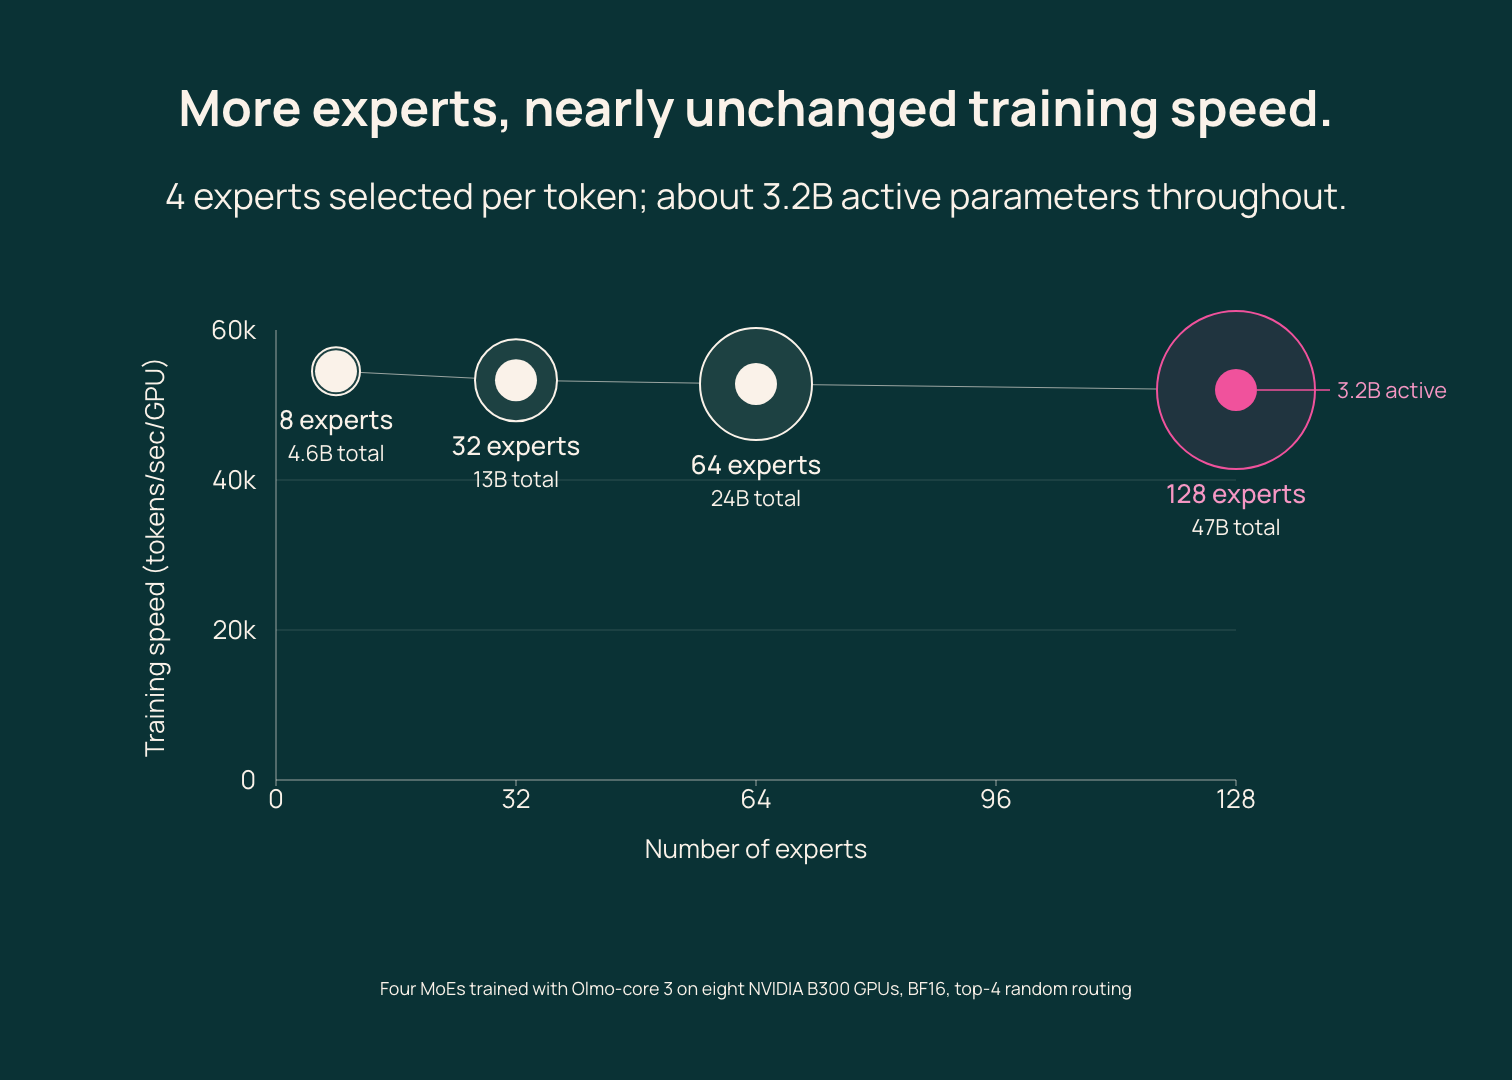
Fler experter men nästan oförändrad träningstakt: från 8 till 128 experter med cirka 3,2B aktiva parametrar [1]
Om Olmo-core 3[1][2][3][4]
Olmo-core 3 är inte en AI-modell utan det öppna ramverk som Ai2 (Allen Institute for AI) använder för att träna sina språkmodeller, släppt i en ny version den 1 oktober 2026. Den stora nyheten är ett omgjort system för att träna MoE-modeller (mixture of experts), där varje bit text bara skickas genom ett fåtal utvalda specialistdelar, så kallade experter, i stället för hela modellen.
Sådana modeller kan bli mycket stora utan att varje steg blir dyrare, men hela modellen måste ändå få plats i grafikkortens minne och data måste skickas runt till rätt experter i ett kluster. När modellerna växer äter de kostnaderna upp en stor del av vinsten. Olmo-core 3 ska lösa det genom att låta experterna ligga kvar på sina grafikkort och skicka data till dem, och genom att dela upp experterna, modellens lager och träningens tillstånd över många grafikkort. Det stöder också det kompaktare talformatet MXFP8, som enligt Ai2 gav cirka 21 % snabbare träning än BF16 i ett test.
I Ai2:s mätningar gick antalet experter från 8 till 128, och modellens totala storlek från 4,6 till 47 miljarder parametrar, medan träningstakten sjönk med under 5 %. På åtta NVIDIA B300-kort tränades samma 47B-modell 2,7 gånger snabbare än med förra versionen. Systemet har testats med en modell på 1,2 biljoner parametrar på 512 grafikkort och i ett kortare test upp till 2,38 biljoner. Ai2 påpekar att de testerna mätte systemets prestanda och inte kvaliteten på en färdigtränad modell.
Olmo-core 3 är grunden för nästa generation Olmo, som enligt Ai2 blir en MoE-modell och deras mest kapabla hittills. Koden ligger öppet på GitHub under Apache 2.0, med en teknisk rapport och en interaktiv genomgång av hur träningen delas upp över grafikkort.
Det viktigaste[1][2]
- Ett öppet träningsramverk, ingen modell: används för att träna stora MoE-modeller.
- Enligt Ai2 gick modellstorleken från 4,6B till 47B parametrar (8 till 128 experter) medan träningstakten sjönk under 5 %.
- Tränade en 47B-modell 2,7 gånger snabbare än förra versionen på åtta NVIDIA B300-kort.
- Testad med en modell på 1,2 biljoner parametrar på 512 grafikkort, och kortvarigt upp till 2,38 biljoner.
- Grunden för nästa generation Olmo, som blir en MoE-modell; koden är öppen under Apache 2.0.
Källor
- [2]
- [3] Gemini 4 Argon, GPT 6.1 Sol, Dots, Claude Sonnet 5.5, Flux 3: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 4 okt 2026 Läst 25 okt 2026
- [4] Gemini 4, GPT 6.1, Plasma conjecture, Napoleon code solved, OpenAI Dots, Claude Sonnet 5.5: AI NEWS ↗AI Search Video youtube.comPublicerad 3 okt 2026 Läst 25 okt 2026
- [1] Introducing Olmo-core 3: Open, scalable training infrastructure for large MoEs ↗Ai2 Officiell sida allenai.orgPublicerad 1 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-03). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Ai2 (Allen Institute for AI)
- AstaBrief 8B 2 okt 2026
- WildDet3D 7 apr 2026