WildDet3D
En öppen modell från Ai2 som hittar föremål i ett vanligt foto och ritar en 3D-låda runt dem med rätt position, storlek och riktning, styrd med text, ett klick eller en ruta.
- 3D
- Bildförståelse
- Robotik
 1 / 6
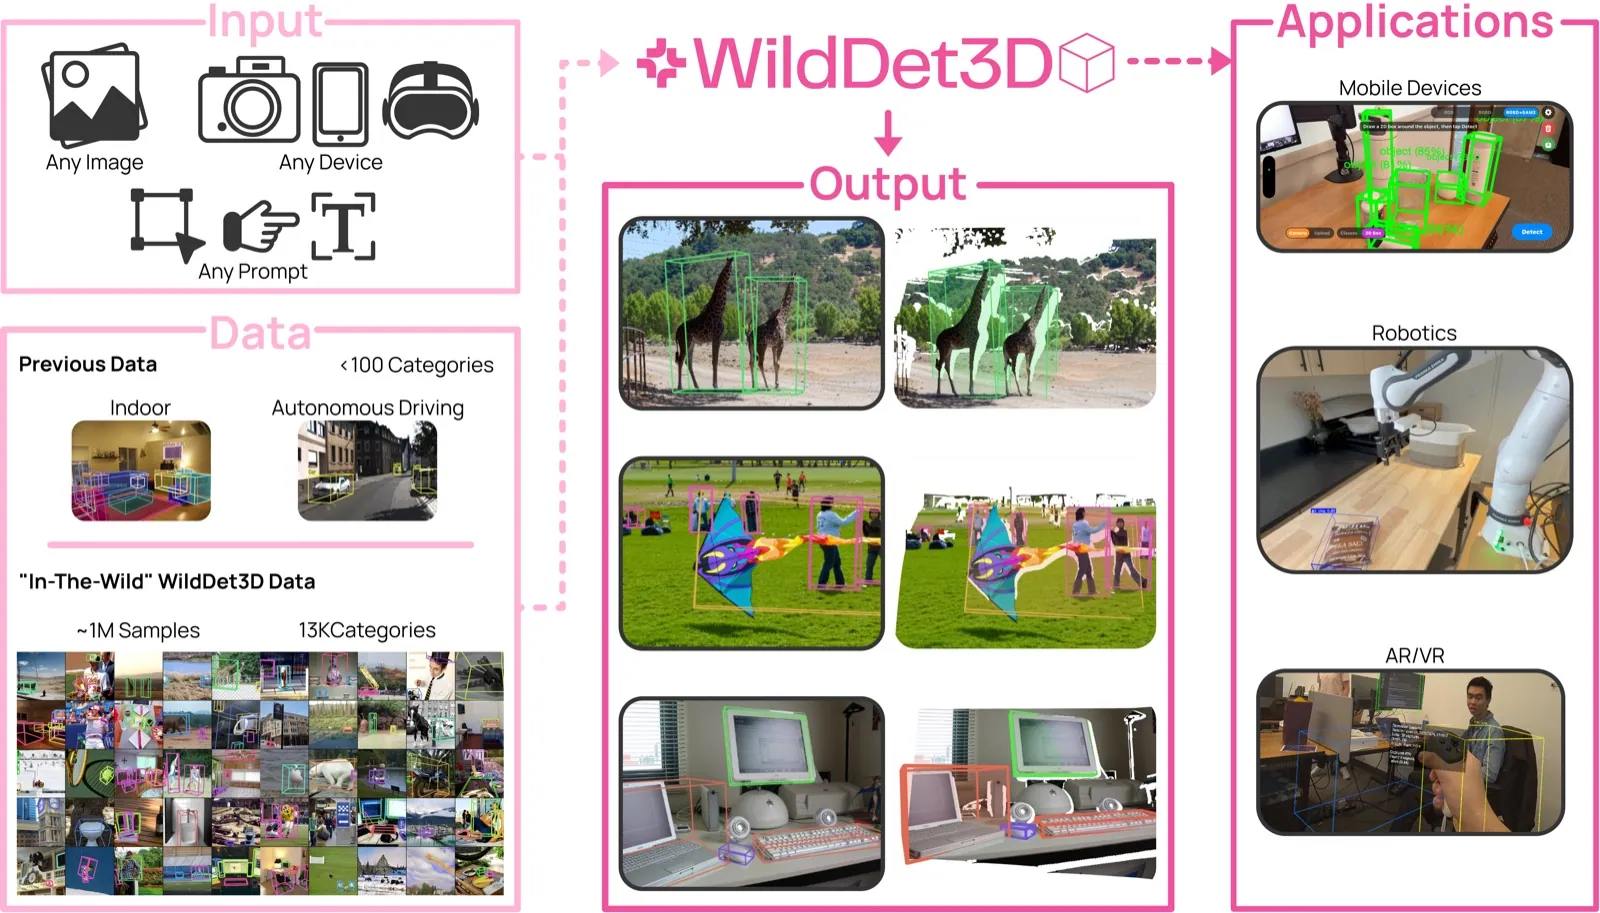
Översikt: en vanlig bild, valfri djupkarta och en prompt ger 3D-lådor runt föremålen [1]
Om WildDet3D[1][2][3][5]
WildDet3D kommer från Ai2 (Allen Institute for AI) tillsammans med University of Washington, Cornell University och UNC-Chapel Hill, och släpptes i april 2026. Den löser en grundläggande uppgift för rumslig förståelse: att utifrån en enda vanlig bild avgöra var föremål befinner sig i 3D, hur stora de är och åt vilket håll de är vända.
Man talar om för modellen vilket föremål man menar på tre sätt: genom att skriva namnet, klicka på det eller dra en ruta runt det i bilden. Modellen svarar med en fullständig 3D-låda i verkliga mått. Om det finns djupinformation, till exempel från LiDAR-sensorn i en iPhone, kan den använda den för att bli mycket träffsäkrare; enligt forskarna ger det i snitt 20,7 punkter bättre resultat. Saknas kameradata kan modellen uppskatta det själv.
Till modellen hör WildDet3D-Data, enligt Ai2 den största öppna datamängden för 3D-detektering hittills: över en miljon bilder, 3,7 miljoner 3D-lådor och 13 500 kategorier i inomhus-, stads- och naturmiljöer, där bara lådor som granskats av människor behållits. Enligt forskarna sätter WildDet3D nya toppresultat på flera tester, bland annat 34,2 AP på Omni3D med textprompter och 40,3 respektive 48,9 på Argoverse 2 och ScanNet utan att ha tränats på dem.
Modellen har cirka 1,2 miljarder parametrar och bygger på bildkodaren från Metas SAM 3. Den finns på Hugging Face under SAM-licensen, med kod på GitHub, en webbdemo och en iPhone-app som visar 3D-lådorna i förstärkt verklighet. Forskarna visar också användning i Meta Quest 3, för att följa föremål i video och för att låta en robotarm greppa saker.
Det viktigaste[1][2][4]
- Ritar 3D-lådor med position, storlek och riktning från ett enda foto; man pekar ut föremål med text, klick eller ruta.
- Djupdata, till exempel från en iPhones LiDAR, ger enligt forskarna i snitt 20,7 punkter bättre resultat.
- Enligt Ai2 34,2 AP på Omni3D med textprompter, 5,8 punkter över det tidigare bästa resultatet.
- Ny öppen datamängd med över 1 miljon bilder, 3,7 miljoner 3D-lådor och 13 500 kategorier.
- Finns som webbdemo och iPhone-app; vikterna under SAM-licensen, som inte förbjuder kommersiell användning men har vissa begränsningar.
Källor
- [1] WildDet3D: Scaling Promptable 3D Detection in the Wild ↗Ai2, University of Washington, Cornell University och UNC-Chapel Hill Officiell sida allenai.github.ioPublicerad okänt datum Läst 25 okt 2026
- [4]
- [5] Claude Opus 4.7, Qwen 3.6, Ernie Image, Happy Oyster, HY World 2.0, Gemini 3.1 TTS: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 19 apr 2026 Läst 25 okt 2026
- [2] Introducing WildDet3D: Open-world 3D detection from a single image ↗Ai2 Officiell sida allenai.orgPublicerad 7 apr 2026 Läst 25 okt 2026
- [3] allenai/WildDet3D ↗Ai2 (Hugging Face) Modellkort huggingface.coPublicerad 4 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-19). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Ai2 (Allen Institute for AI)
- AstaBrief 8B 2 okt 2026
- Olmo-core 3 1 okt 2026