Show-Harness
Ett ramverk från Show Lab vid NUS som låter vanliga bild- och språkmodeller styra robotar genom enkla kommandon som "flytta framåt", "grip" och "släpp".
- Robotik
- Agenter
- Bildförståelse
 1 / 4
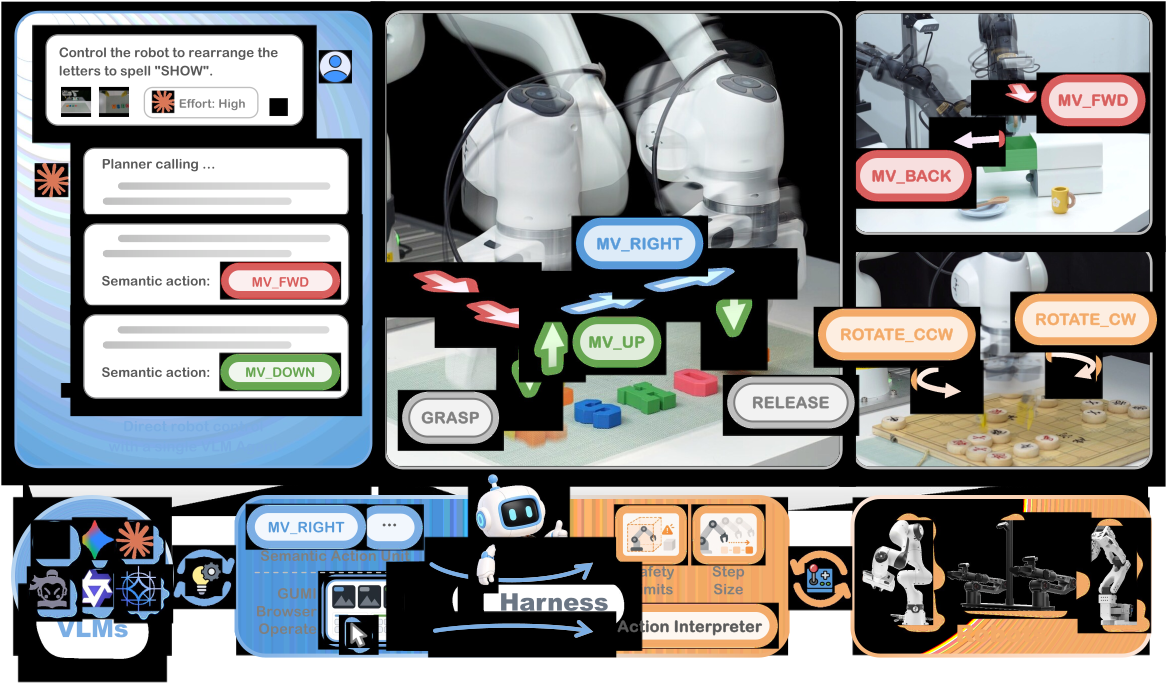
Översikt: en bild- och språkmodell väljer enkla kommandon som en tolk gör om till robotrörelser [1]
Om Show-Harness[1][2][4]
Show-Harness är ett så kallat Embodied Harness: ett skal runt en vision-language-modell (VLM), alltså en AI-modell som förstår både bilder och text, som gör att den kan styra en robotarm direkt. I stället för att modellen räknar ut exakta rörelser väljer den i varje steg ett enkelt kommando, till exempel MV_FWD (flytta framåt), MV_LEFT, GRASP (grip), RELEASE (släpp) eller ROTATE_CW (vrid medurs). En tolk för den aktuella roboten bestämmer sedan hur långt eller hur mycket rörelsen ska vara. Insticksmoduler bygger ihop sammanhanget inför varje steg, till exempel bilder från flera vinklar, en plan i delsteg och robotens egen position.
Projektet innehåller också GUMI (GUI Manipulation Interface), ett gränssnitt i webbläsaren där människor kan samla in demonstrationer med samma kommandon, till exempel med tangentbordet, i stället för med dyr specialutrustning.
Forskarna har testat Show-Harness på en Franka-arm med 7 frihetsgrader, en AgileX-arm med 6, i simulator och på en tvåarmad robot. Både stora stängda modeller (bland annat Gemini 3.1 Pro, GPT-5.6 Sol och Claude Opus 5) och små öppna modeller (Qwen3.5 från 0,8B till 9B och InternVL3.5) användes; de öppna modellerna finjusterades på några GPU-timmar. Enligt teamet klarar systemet 89 % av tio olika uppgifter utan extra träning, mot 57 % för den bästa jämförda metoden, och de stora stängda modellerna lyckas i 86–96 % av fallen. Kod, finjusterade modeller och data är släppta.
Det viktigaste[1]
- Robotstyrningen förenklas till enkla kommandon som flytta, grip, släpp och vrid, som vilken bild- och språkmodell som helst kan välja mellan.
- Enligt teamet 89 % lyckade försök på tio uppgifter utan extra träning, mot 57 % för bästa jämförda metod.
- Enligt teamet lyckas Gemini 3.1 Pro, GPT-5.6 Sol och Claude Opus 5 i 86–96 % av fallen.
- Med GUMI kan man samla in robotdemonstrationer i webbläsaren, till exempel med tangentbordet.
- Små öppna modeller från 2B parametrar och uppåt fungerar; svarstiden är enligt teamet 39 ms för 2B och 79 ms för 9B.
Källor
- [1] Show-Harness ↗Show Lab, National University of Singapore Officiell sida showlab.github.ioPublicerad okänt datum Läst 25 okt 2026
- [2]
- [4] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [3] showlab/Show-Harness-VLMs ↗Show Lab (Hugging Face) Modellkort huggingface.coPublicerad 1 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.