Skild S1
Skild AI:s grundmodell för robotar som lär sig en ny uppgift av en enda videodemonstration, utan extra träning, och klarar uppgifter som tar upp till tio minuter.
- Robotik
 1 / 7
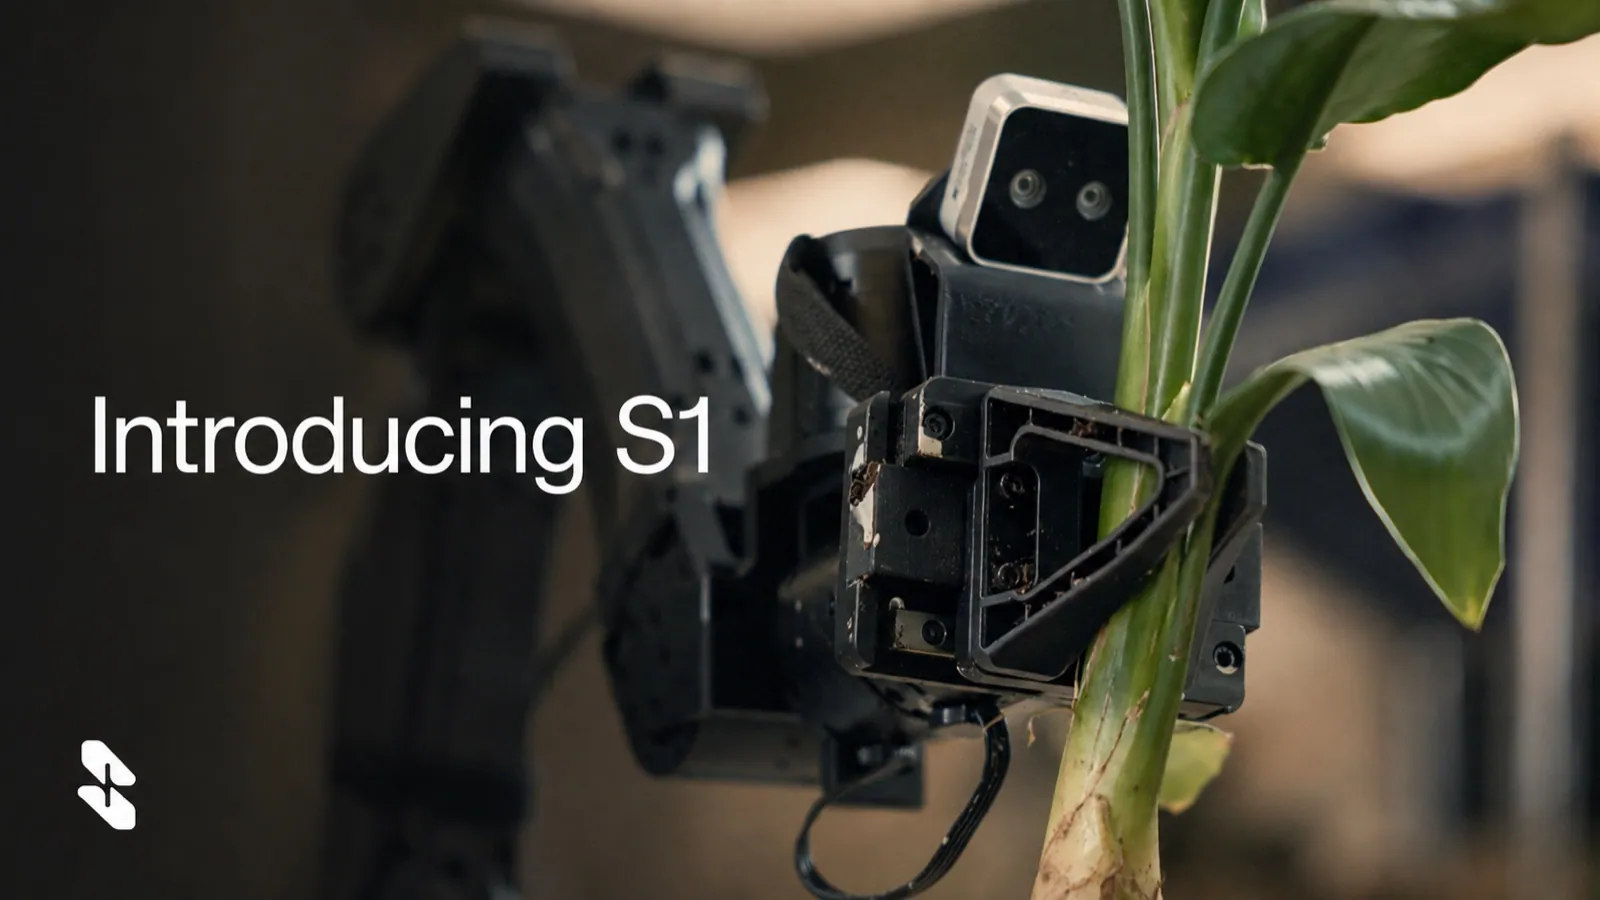
Skild AI:s presentationsbild för S1 [1]
Om Skild S1[1][2][3]
S1 är Skild AI:s flaggskeppsmodell för robotar, presenterad i augusti 2026. Den bygger på inlärning i sammanhanget (in-context learning): i stället för att få en textinstruktion eller tränas om för varje ny uppgift visas roboten en video där uppgiften utförs, och sedan gör den likadant. Enligt Skild kom alla exempel i presentationen från samma modellvikter, utan finjustering för den specifika uppgiften.
Skild visar långa uppgifter som modellen inte sett förut, till exempel att plantera om en växt, vända pannkakor, brygga kaffe och plocka ihop ett kit. Uppgifterna kan pågå i upp till tio minuter och innehålla dussintals steg. I ett exempel tog det enligt Skild elva minuter från att demonstrationen började förberedas till att roboten utförde uppgiften själv.
Skild jämför med en vanlig robotmodell som styrs med text (VLA). På uppgifter som modellerna inte tränats på nådde den textstyrda modellen 9 % och S1 66 % efter 100 000 timmars förträning, ungefär sju gånger bättre. Enligt Skilds uppskattning motsvarar en enda videodemonstration ungefär 380 vanliga träningsdemonstrationer, som skulle ta 50–100 timmars fjärrstyrning att samla in; siffran är interpolerad. Skild lyfter också fram att modellen återhämtar sig från misstag, klarar störningar, kan ersätta saker med sunt förnuft (till exempel en kopp när det saknas vattenkanna) och kan rätta till en demonstration som innehåller fel.
Modellen körs på NVIDIA:s AI-infrastruktur, men Skild ger inga detaljer om arkitektur eller storlek. Enligt Skild används S1 redan av kommersiella partner, och andra kan anmäla sig för tidig åtkomst. Skild har senare byggt vidare på S1 med självspel, se Skild AI physical self-play.
Det viktigaste[1]
- Lär sig en ny uppgift av en enda videodemonstration, utan finjustering.
- Klarar uppgifter som pågår i upp till tio minuter, som att plantera om en växt eller brygga kaffe.
- Enligt Skild når den 66 % på okända uppgifter, mot 9 % för en textstyrd robotmodell, efter 100 000 timmars förträning.
- Enligt Skilds uppskattning är en videodemonstration värd ungefär 380 vanliga träningsdemonstrationer.
- Används enligt Skild redan av kommersiella partner; andra kan anmäla sig för tidig åtkomst.
Källor
- [2]
- [3] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [1] Introducing S1: In-Context Learning for Robotics ↗Skild AI Officiell sida skild.aiPublicerad aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Skild AI
- Skild AI physical self-play (robot soccer) 23 sep 2026