
FixAnything
Använder en förtränad videomodell för att laga fel och artefakter i 3D-renderingar, oavsett om scenen är byggd med Gaussian splats, NeRF, mesh eller glesa punktmoln.
- 3D
- Videogenerering
 1 / 6
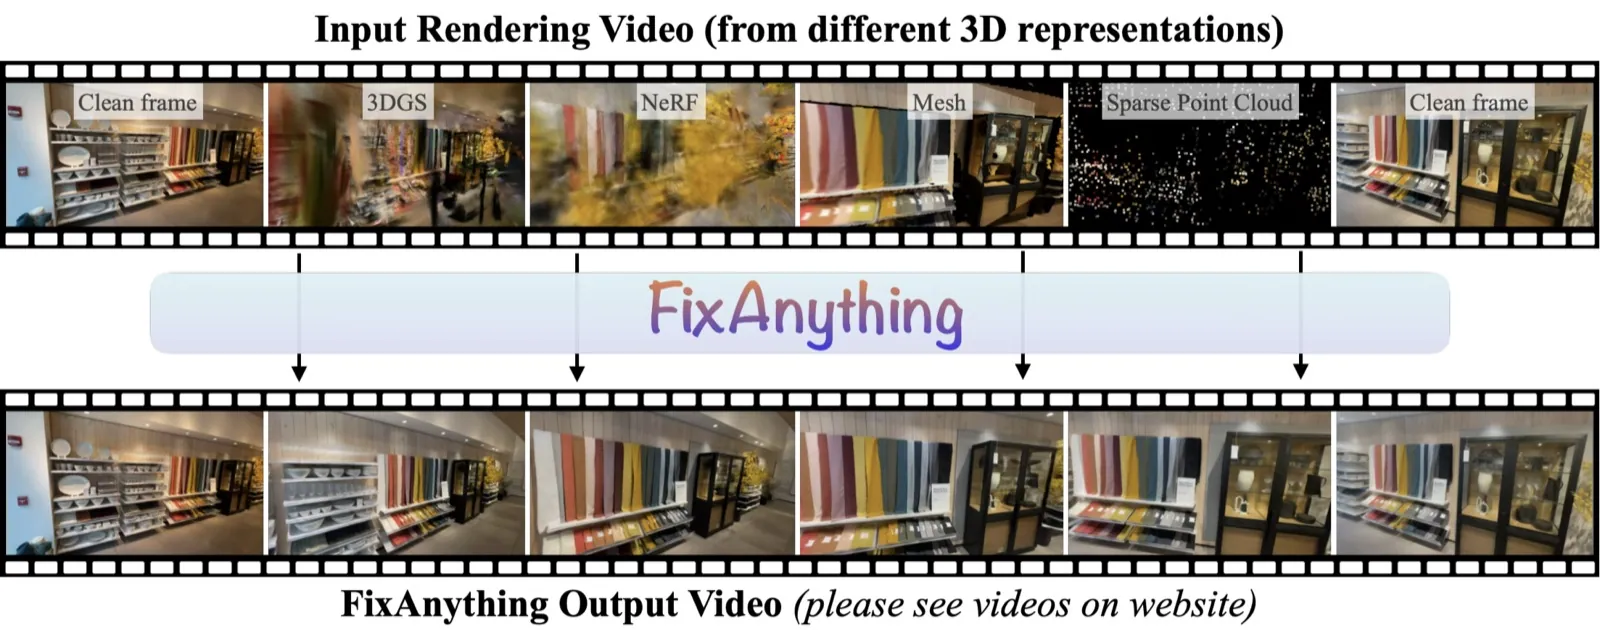
FixAnything lagar artefakter i renderingar från olika slags 3D-representationer [2]
Om FixAnything[1][2][3][5]
När man renderar en 3D-scen från vinklar långt från de foton den byggdes av blir resultatet ofta fullt av artefakter: suddiga partier, hål och flytande skräp. FixAnything lagar sådana renderingar genom att behandla dem som en video som ska översättas till en ren video, med samma kamerarörelse som originalet.
Grunden är videomodellen Wan2.1-I2V-14B, som anpassats med en liten LoRA-modul (under 1 procent av parametrarna). Den trasiga renderingen fungerar som styrsignal för kameran, och en mask talar om vilka bildrutor som är rena foton att lita på och vilka som ska lagas. Enligt forskarna räcker det med ett glest punktmoln och så lite som cirka 20 parade videor för träningen, och samma modell fungerar för 3D Gaussian splats, NeRF, mesh och punktmoln.
I ett andra steg tränas modellen att hålla geometrin konsekvent. Flera förslag skapas per scen och rankas efter hur exakt kamerapositionerna kan återskapas ur resultatet med verktyget COLMAP. Det förbättrade måttet på kameranoggrannhet från 61,1 till 68,3 (AUC@5°), utan extra kostnad när modellen används.
FixAnything kommer från Carnegie Mellon University och har antagits till konferensen ECCV 2026. Kod och LoRA-vikter är släppta under Apache 2.0, samma licens som Wan2.1.
Det viktigaste[1][3]
- En och samma modell lagar renderingsfel från Gaussian splats, NeRF, mesh och glesa punktmoln.
- Bygger på videomodellen Wan2.1-I2V-14B med en liten LoRA-modul; cirka 20 parade videor räcker enligt forskarna.
- Geometrimedveten efterträning förbättrade kameranoggrannheten från 61,1 till 68,3 AUC@5° i forskarnas tester.
- Kod och vikter under Apache 2.0; antagen till ECCV 2026.
Källor
- [1] FixAnything: 3D-Consistent Rendering Refinement via Video Generative Priors ↗Carnegie Mellon University Officiell sida fix-anything.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3]
- [5] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [2] FixAnything: 3D-Consistent Rendering Refinement via Video Generative Priors ↗arXiv Forskningsartikel arxiv.orgPublicerad 24 aug 2026 Läst 25 okt 2026
- [4] kvuong2711/fix-anything ↗Hugging Face (kvuong2711) Modellkort huggingface.coPublicerad 24 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Carnegie Mellon University
- Point2Part 29 sep 2026
- CoDimRecon 28 sep 2026