DeepSeek V4
DeepSeeks fjärde generation öppna språkmodeller, V4-Pro och V4-Flash, som läser en miljon tokens med ett nytt sätt att hantera uppmärksamhet som sparar minne och datorkraft.
- Språkmodell
- Resonemang
- Kod
- Agenter
 1 / 4
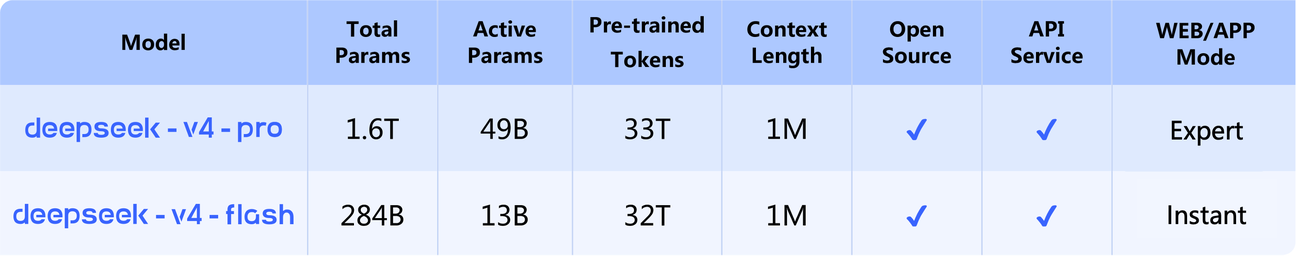
De två V4-modellerna: storlek, träningsdata, kontext och läge i chatten [1]
Om DeepSeek V4[1][2][3][4]
DeepSeek V4 släpptes som förhandsversion den 24 april 2026 i två storlekar. DeepSeek-V4-Pro är en MoE-modell med 1,6 biljoner parametrar, varav 49 miljarder är aktiva per token, och DeepSeek-V4-Flash har 284 miljarder parametrar, varav 13 miljarder aktiva. Båda kan läsa upp till en miljon tokens, och DeepSeek gjorde en miljon tokens till standard i alla sina tjänster. Båda har ett tänkande och ett icke-tänkande läge.
Det nya är framför allt hur modellen håller koll på långa texter. DeepSeek kombinerar två sorters komprimerad uppmärksamhet (Compressed Sparse Attention och Heavily Compressed Attention). Enligt modellkortet behöver V4-Pro vid en miljon tokens bara omkring 27 % av beräkningarna per token och 10 % av minnet för KV-cachen jämfört med DeepSeek-V3.2. Det gör modellerna lämpade för AI-agenter som arbetar med mycket kod och långa arbetsflöden.
Enligt DeepSeek var V4-Pro bäst bland öppna modeller på agentisk programmering och slog alla öppna modeller i matematik och kod. Vikterna släpptes på Hugging Face under MIT-licens. I webbtjänsten kör V4-Pro Expert-läget och V4-Flash Instant-läget. De äldre API-namnen deepseek-chat och deepseek-reasoner pekades om till V4-Flash.
V4-Pro fick en färdig version, V4-Pro-0813, i augusti 2026, och V4-Flash fick en uppdatering 0731. Den 10 september 2026 ersattes V4-Flash av DeepSeek-V4.1-Flash, och från den 14 september skickas även API-anrop till V4-Pro vidare till V4.1-Flash tills V4.1-Pro lanseras.
Det viktigaste[1][2]
- Två storlekar: V4-Pro (1,6T/49B aktiva) och V4-Flash (284B/13B aktiva), båda med 1M tokens kontext.
- Enligt DeepSeek kräver V4-Pro vid 1M tokens ca 27 % av beräkningarna och 10 % av KV-cachen jämfört med V3.2.
- Enligt modellkortet får V4-Pro 80,6 på SWE-bench Verified och 90,1 på GPQA Diamond.
- Öppna vikter under MIT-licens.
Källor
- [2] deepseek-ai/DeepSeek-V4-Pro ↗DeepSeek (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient ↗DeepSeek Officiell sida api-docs.deepseek.comPublicerad 10 sep 2026 Läst 25 okt 2026
- [4] Deepseek V4, Kimi K2.6, MiMo v2.5, GPT 5.5, GPT Images 2, Qwen 3.6, HY3, Vision Banana: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 26 apr 2026 Läst 25 okt 2026
- [1] DeepSeek V4 Preview Release ↗DeepSeek Officiell sida api-docs.deepseek.comPublicerad 24 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-26). Markerad som inaktuell: ersatt av DeepSeek-V4.1-Flash. [4]
Placeringar i topplistor
- WebDev ArenaV4-Flash, High#38 · 1582 ± 9
- Legal Research BenchV4-Flash, version 0731#50 · 30.29% ± 3.19
- MedScribeV4-Flash, version 0731#58 · 80.36% ± 1.97
- LMArena TextV4-Pro#64 · 1458 ± 4
- LegalBenchV4-Pro#89 · 80.32% ± 0.47
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från DeepSeek
- DeepSeek Search & Fetch API 17 okt 2026
- DeepSeek-V4.1-Flash-1017 17 okt 2026
- DeepGEMM-Ascend 30 sep 2026
- DeepSeek-V4.1-Flash 10 sep 2026 · inaktuell
- DeepSeek-V4-Flash-Vision-Exp 21 aug 2026 · inaktuell
- DeepSeek-V4-Pro-0813 13 aug 2026
- DeepSeek Harness aug 2026
- DeepSeek Expert Mode apr 2026