DeepSeek-V4.1-Flash
DeepSeeks första modell i en ny arkitektur: en öppen MoE-modell som läser bilder och en miljon tokens, och som enligt DeepSeek slår den större V4-Pro med bara 8–16 miljarder aktiva parametrar.
- Språkmodell
- Resonemang
- Kod
- Agenter
- Bildförståelse
- Multimodal
 1 / 5
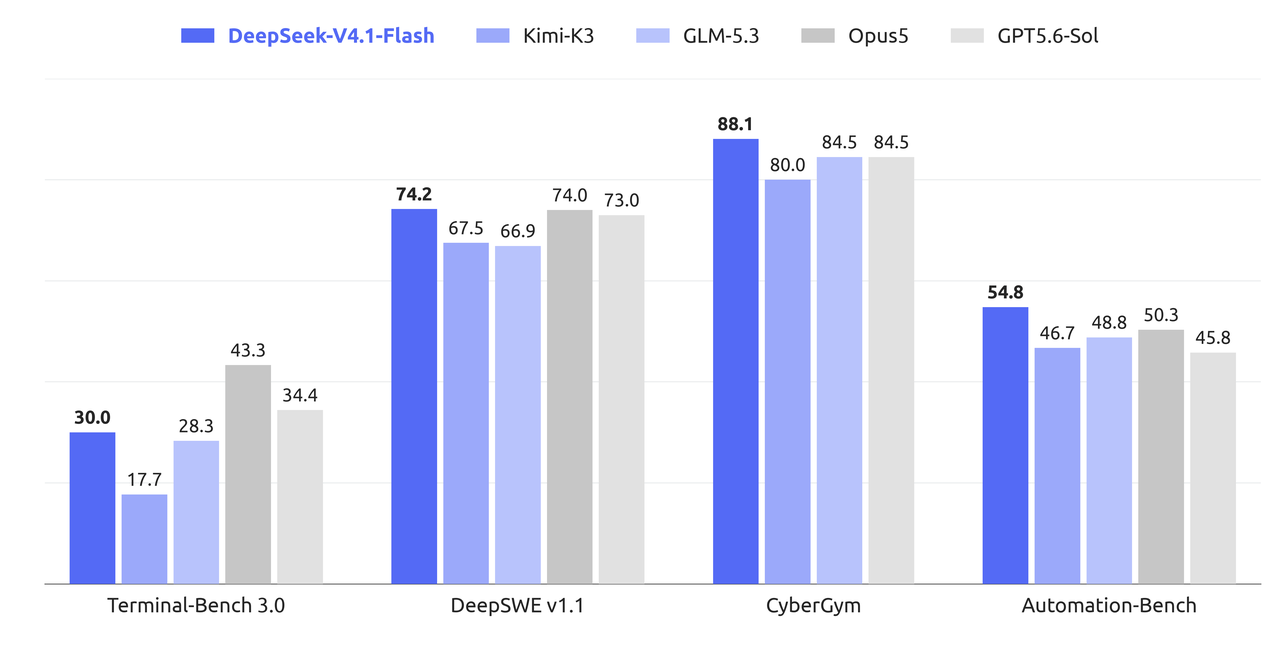
DeepSeeks jämförelse med Kimi K3, GLM-5.3, Opus 5 och GPT-5.6 Sol på agenttester [2]
Om DeepSeek-V4.1-Flash[1][2][3][4]
DeepSeek-V4.1-Flash släpptes den 10 september 2026 och är den minsta modellen i DeepSeeks nya arkitekturfamilj. Det är en MoE-modell med 552 miljarder parametrar i grundstommen, men bara 8 miljarder aktiva parametrar när den läser in text och 16 miljarder när den skriver. Till det kommer ett separat minne (Engram) på 196 miljarder parametrar som slås upp vid behov. Modellen är tränad från grunden på omkring 45 biljoner tokens text och bild, och förstår bilder direkt med en egen bildkodare.
Den största nyheten är en ny uppbyggnad, en kausal kodare–avkodare, och ett omarbetat sätt att minnas långa texter. Enligt DeepSeek behöver modellen bara en fjärdedel så mycket grafikminne och en åttondedel så mycket lagring för sin KV-cache som föregångaren V4-Flash, ungefär 890 byte per token. Den kan läsa upp till en miljon tokens, vilket gör den lämpad för agenter som arbetar igenom stora dokument och kodbaser. Hur mycket modellen ska tänka kan ställas in på en skala från 1 till 100.
Enligt DeepSeek presterar den bättre än tidigare flaggskepp, bland annat DeepSeek-V4-Pro, och är dessutom billigare och snabbare. När den släpptes pensionerades V4-Flash och V4-Flash-Vision-Exp, och från den 14 september skickas även anrop till V4-Pro i API:t vidare till V4.1-Flash tills en V4.1-Pro lanseras. Vikterna finns på Hugging Face under MIT-licens.
Den 17 oktober 2026 släppte DeepSeek en uppdaterad version, DeepSeek-V4.1-Flash-1017, som enligt DeepSeek ger bättre resultat, löser uppgifter snabbare och skriver kortare svar. Den versionen kör nu API-modellen deepseek-flash.
Det viktigaste[1][2]
- Enligt DeepSeek: 74,2 på DeepSWE v1.1, 88,1 på CyberGym och 54,8 på AutomationBench, före Kimi K3, GLM-5.3, Opus 5 och GPT-5.6 Sol i deras diagram.
- På Terminal-Bench 3.0 får den 30,0 enligt DeepSeek, efter Opus 5 (43,3) och GPT-5.6 Sol (34,4).
- KV-cachen är ca 890 byte per token, en fjärdedel av V4-Flash.
- Läser text och bilder, 1M tokens kontext.
- API-pris utanför rusningstid: $0,15 för inmatning och $0,6 för utmatning, enligt DeepSeeks prislista (dubbla priset i rusningstid).
- Öppna vikter under MIT-licens.
Källor
- [1] deepseek-ai/DeepSeek-V4.1-Flash ↗DeepSeek (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real ↗DeepSeek Officiell sida api-docs.deepseek.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [4] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [2] DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient ↗DeepSeek Officiell sida api-docs.deepseek.comPublicerad 10 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Markerad som ersatt av DeepSeek-V4.1-Flash-1017.
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [4]
Placeringar i topplistor
- #7 · 65.43% ± 2.02
- ARC-AGI-3Läge: Max. Bästa med Provider Adapter: 3,3 % (Low)#12 · 0,9 %
- WebDev Arenaversion 20260910, Max#27 · 1619 ± 11
- #27 · 41.35% ± 3.42
- #27 · 85.50% ± 1.92
- LMArena TextVersionen från 10 sep 2026, läge Max#34 · 1476 ± 6
- #56 · 83.28% ± 0.46
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- DeepSeek-V4-Flash-Vision-Exp 21 aug 2026
- DeepSeek V4 24 apr 2026
Mer från DeepSeek
- DeepSeek Search & Fetch API 17 okt 2026
- DeepSeek-V4.1-Flash-1017 17 okt 2026
- DeepGEMM-Ascend 30 sep 2026
- DeepSeek-V4-Flash-Vision-Exp 21 aug 2026 · inaktuell
- DeepSeek-V4-Pro-0813 13 aug 2026
- DeepSeek Harness aug 2026
- DeepSeek V4 24 apr 2026 · inaktuell
- DeepSeek Expert Mode apr 2026