DeepSeek-V4-Flash-Vision-Exp
DeepSeeks första experimentella V4-modell som förstår bilder, byggd på V4-Flash och tränad för agenter som arbetar med både text och bild.
- Språkmodell
- Bildförståelse
- Multimodal
- Agenter
- Kod
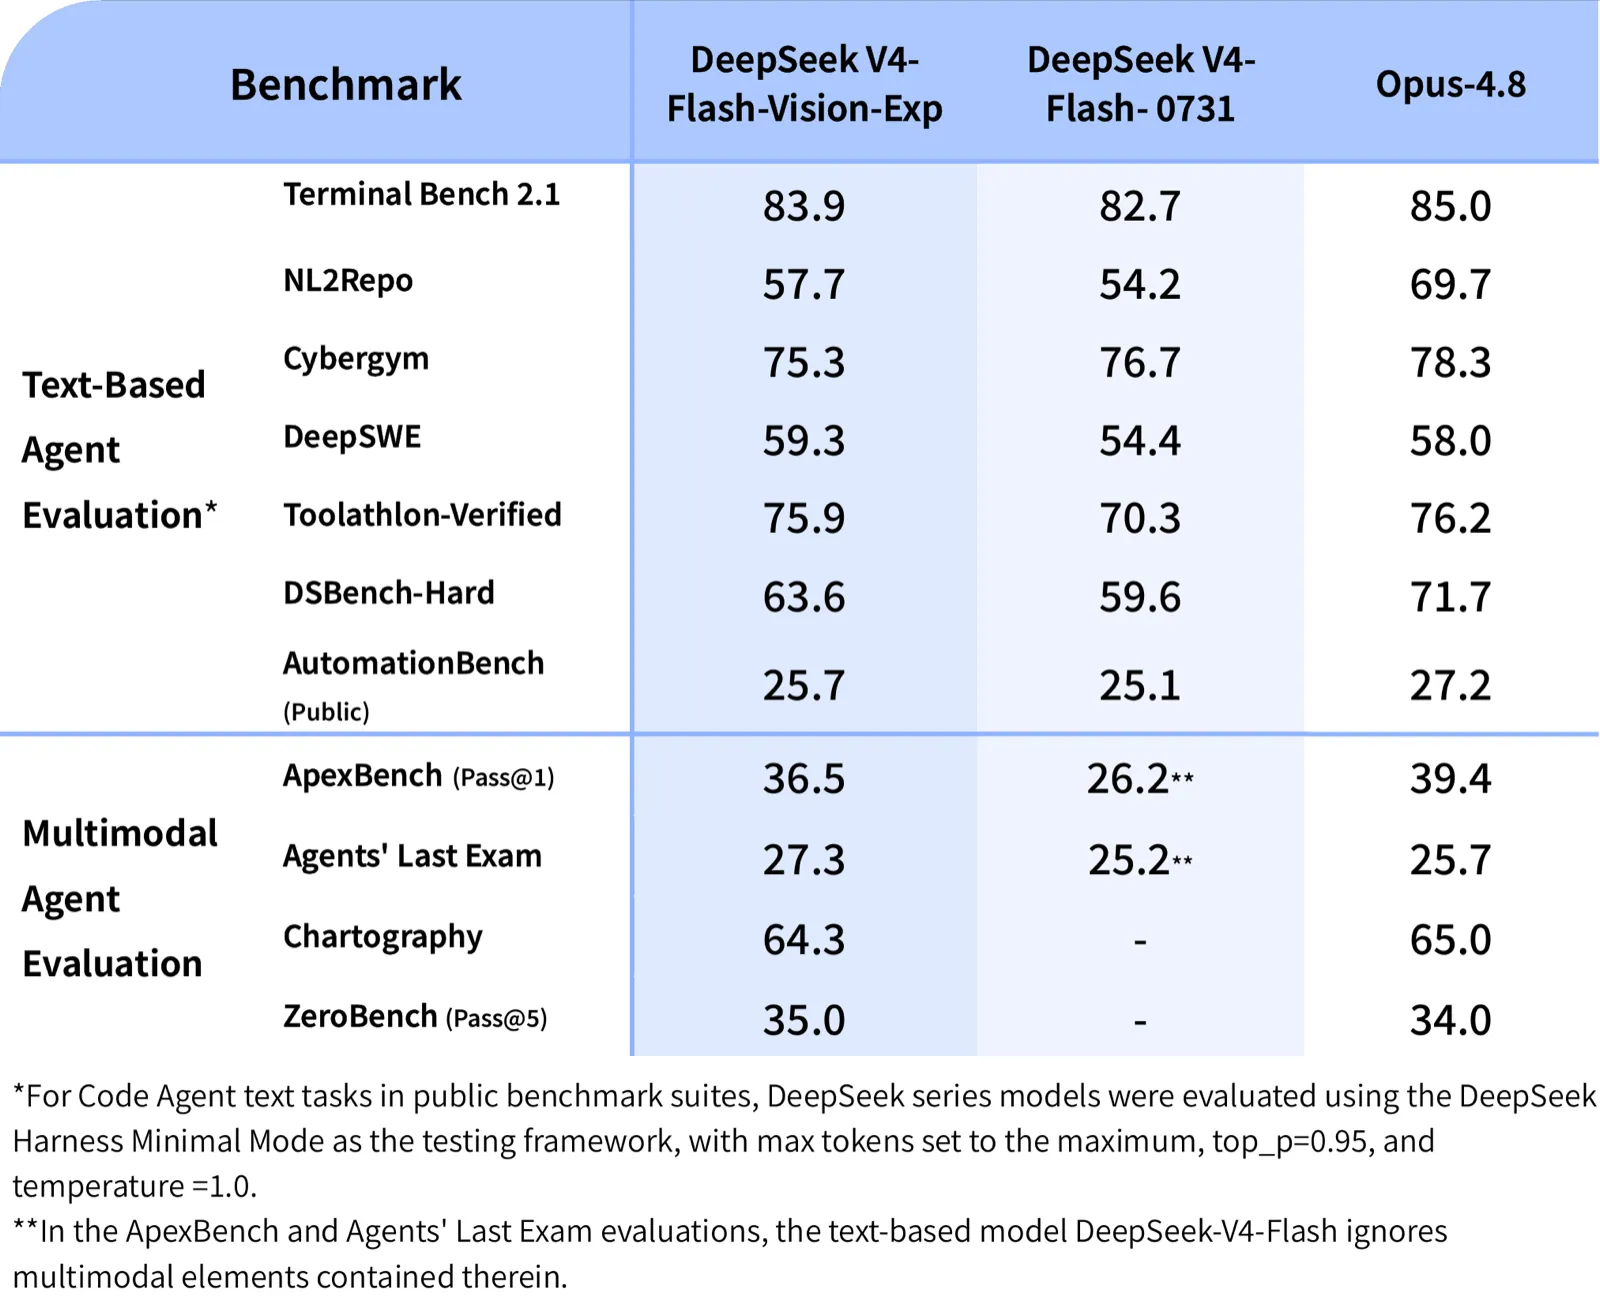
DeepSeeks jämförelse med V4-Flash-0731 och Opus 4.8 på text- och bildagenttester [2]
Om DeepSeek-V4-Flash-Vision-Exp[1][2][3][4]
DeepSeek-V4-Flash-Vision-Exp är den första modellen i DeepSeek-V4-familjen som kan ta emot bilder. Den bygger på V4-Flash, som fick extra bildmoduler och sedan tränades vidare för att förstå bilder. Modellen släpptes i DeepSeeks API den 21 augusti 2026, med öppna vikter på Hugging Face under MIT-licens. Modellfilen är på 305 miljarder parametrar.
Enligt DeepSeek klarar den textuppgifter ungefär lika bra som V4-Flash, men gör ett stort lyft på tester där en agent måste förstå bilder, och hamnar där nära Claude Opus 4.8. I API:t kan man skicka blandad text och bild, och varje bild räknas som högst 384 tokens till V4-Flash-pris.
Modellen var ett experiment. Den 10 september 2026 ersattes den, tillsammans med V4-Flash, av DeepSeek-V4.1-Flash, som kan läsa bilder från grunden. API-namnet deepseek-v4-flash-vision-exp skickas sedan dess vidare till V4.1-Flash.
Det viktigaste[1][2][3]
- Enligt DeepSeek: 36,5 på ApexBench mot 26,2 för V4-Flash-0731 och 39,4 för Opus 4.8.
- Enligt DeepSeek: 27,3 på Agents' Last Exam, före Opus 4.8 (25,7).
- Textförmågan ungefär som V4-Flash, t.ex. 83,9 mot 82,7 på Terminal Bench 2.1.
- Öppna vikter under MIT-licens; ersatt av V4.1-Flash i september 2026.
Källor
- [1] deepseek-ai/DeepSeek-V4-Flash-Vision-Exp ↗DeepSeek (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient ↗DeepSeek Officiell sida api-docs.deepseek.comPublicerad 10 sep 2026 Läst 25 okt 2026
- [4] GPT 6 Astra, Claude Fable 5.1, Qwen 3.8 0902, Gemini 3.8 Flash, Muse Spark 1.3, Atlas: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 6 sep 2026 Läst 25 okt 2026
- [2] DeepSeek-V4-Flash-Vision-Exp Release: Multimodal API Now Live ↗DeepSeek Officiell sida api-docs.deepseek.comPublicerad 21 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-06). Markerad som inaktuell: ersatt av DeepSeek-V4.1-Flash. [4]
Placeringar i topplistor
- Artificial Analysis Intelligence IndexLäge: max#30 · 35
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från DeepSeek
- DeepSeek Search & Fetch API 17 okt 2026
- DeepSeek-V4.1-Flash-1017 17 okt 2026
- DeepGEMM-Ascend 30 sep 2026
- DeepSeek-V4.1-Flash 10 sep 2026 · inaktuell
- DeepSeek-V4-Pro-0813 13 aug 2026
- DeepSeek Harness aug 2026
- DeepSeek V4 24 apr 2026 · inaktuell
- DeepSeek Expert Mode apr 2026