DiffusionOPSD
Ett effektivare sätt att efterträna bildmodeller mot ett betyg, med tydliga positiva och negativa mål under träningen, som enligt forskarna sparar 40–63 procent GPU-tid.
- Bildgenerering
 1 / 3
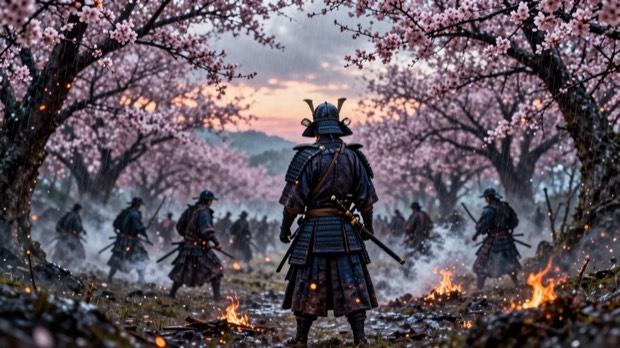
Exempelbild från en modell eftertränad med DiffusionOPSD [1]
Om DiffusionOPSD[1][2][3][5]
DiffusionOPSD (On-Policy Self-Distillation in Diffusion Models) är en metod för att efterträna bildgenererande diffusionsmodeller så att bilderna får högre betyg från bedömningsmodeller, till exempel för estetik eller hur väl bilden följer texten. Problemet med vanlig förstärkningsinlärning här är att betyget bara säger om den färdiga bilden är bra, inte hur modellens mellansteg borde ändras.
DiffusionOPSD gör om betyget till konkreta mål. En fryst kopia av modellen genererar bilder, och utifrån betygets lutning skapas avgränsade positiva och negativa mål för vad modellen borde förutsäga i ett sent steg av avbrusningen. Den tränade modellen anpassas mot målen, och kopian uppdateras sedan så att målen hela tiden bygger på modellens aktuella beteende.
Enligt forskarna gav metoden bäst slutresultat i 19 av 20 jämförbara uppsättningar med Stable Diffusion 3.5 Medium och Z-Image-Turbo och tio bedömningsmodeller, upp till 44 procent bättre än närmaste konkurrent. Jämfört med DiffusionNFT minskade träningstiden på GPU med 40 procent på SD3.5-M och 63 procent på Z-Image-Turbo. Koden och tränade vikter finns under Apache 2.0, och GitHub-sidan beskriver en effektivare andra version av träningsreceptet.
Arbetet leds av ByteDance Seed tillsammans med bland annat National University of Singapore och UC San Diego. GitHub-repot beskriver sig som en extern implementation av algoritmen i artikeln.
Det viktigaste[1][2]
- Gör om ett betyg på den färdiga bilden till tydliga positiva och negativa mål för modellens mellansteg.
- Enligt forskarna bäst i 19 av 20 jämförbara uppsättningar, upp till 44 procent bättre än närmaste konkurrerande metod.
- Enligt forskarna 40 procent mindre GPU-tid än DiffusionNFT på SD3.5-M och 63 procent mindre på Z-Image-Turbo.
- Testad på Stable Diffusion 3.5 Medium och Z-Image-Turbo med tio olika bedömningsmodeller.
- Kod och vikter under Apache 2.0.
Källor
- [1] DiffusionOPSD — On-Policy Self-Distillation in Diffusion Models ↗ByteDance Seed m.fl. Officiell sida diffusionopsd.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] DiffusionOPSD: On-Policy Self-Distillation in Diffusion Models ↗worldbench (GitHub) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] WeiChow/DiffusionOPSD ↗Hugging Face (WeiChow) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [2] On-Policy Self-Distillation in Diffusion Models ↗arXiv Forskningsartikel arxiv.orgPublicerad 25 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från ByteDance (Seed)
- Dreamina Seedance 2.5 31 jul 2026
- Seedream 5.0 Pro 8 jul 2026
- OmniShow 13 apr 2026
- DreamLite 30 mar 2026
- Lucida –