OmniShow
Ett ramverk som skapar realistiska videor av människor som hanterar föremål, styrt av valfri kombination av text, referensbilder, ljud och kroppspose.
- Videogenerering
- Animation & rörelse
- Multimodal
 1 / 5
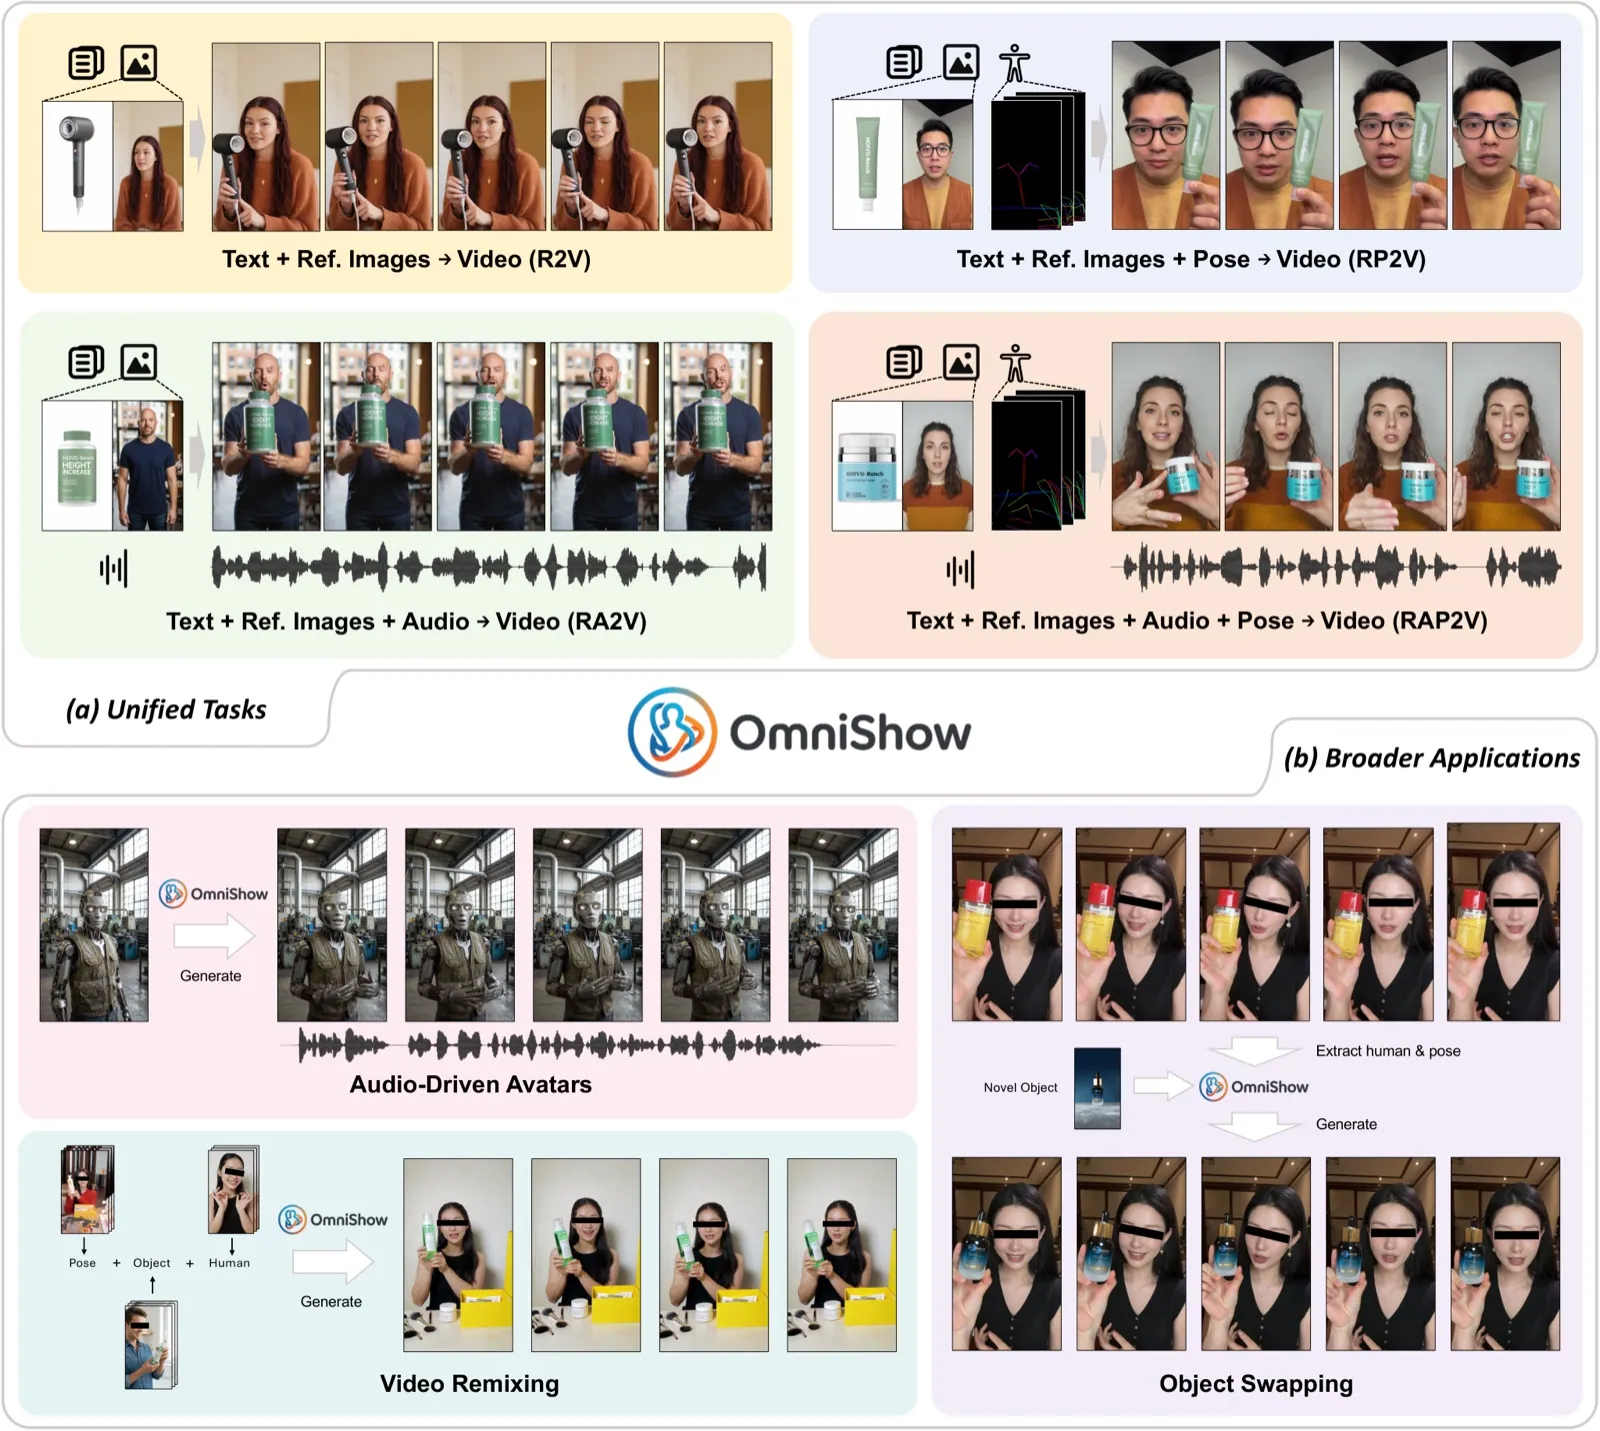
Översikt: OmniShow kombinerar text, referensbilder, ljud och pose för att skapa videor av människor som hanterar föremål [2]
Om OmniShow[1][2][3][4]
OmniShow är ett forskningsprojekt om videogenerering av interaktioner mellan människor och föremål (Human-Object Interaction Video Generation). Man kan mata in text, referensbilder på personen och föremålet, ljud och en kroppspose, i olika kombinationer, och få ut en video där personen till exempel lyfter en mugg, tar på sig en hatt eller visar upp en produkt medan hen pratar.
Modellen hanterar flera uppgifter i ett och samma system: video från referensbilder, från referensbilder plus ljud, från referensbilder plus pose, och från alla fyra signalerna samtidigt. Enligt forskarna ger den mer naturliga rörelser, stabilare grepp och färre fall där händer går igenom föremål, och den kan göra sammanhängande klipp på upp till 10 sekunder. Den kan också animera en person från en bild och ett ljudspår så att hen pratar eller sjunger. På projektsidan jämförs den med bland andra HunyuanCustom, HuMo-17B, VACE och Phantom-14B.
Forskarna har också byggt ett eget test, HOIVG-Bench, som finns på Hugging Face. Tränings- och inferenskoden för en version byggd på Wan-modellerna är släppt under Apache 2.0, men själva de tränade vikterna ingår inte, med hänvisning till interna regler.
Arbetet är ett samarbete mellan ByteDance och The Chinese University of Hong Kong, med medverkan från Monash University och The University of Hong Kong, och har antagits till ICML 2026.
Det viktigaste[1][2][3]
- Skapar videor av människor som interagerar med föremål från text, referensbilder, ljud och pose i valfri kombination.
- Enligt forskarna stabilare grepp och kontakt och färre fall där händer går igenom föremål.
- Kan göra sammanhängande klipp på upp till 10 sekunder och animera pratande eller sjungande personer från en bild och ljud.
- Tränings- och inferenskod för en Wan-baserad version är öppen, men de tränade vikterna är inte släppta.
- Antagen till ICML 2026; testet HOIVG-Bench finns på Hugging Face.
Källor
- [1] OmniShow: Unifying Multimodal Conditions for Human-Object Interaction Video Generation ↗ByteDance och The Chinese University of Hong Kong m.fl. Officiell sida correr-zhou.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3]
- [4] Claude Opus 4.7, Qwen 3.6, Ernie Image, Happy Oyster, HY World 2.0, Gemini 3.1 TTS: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 19 apr 2026 Läst 25 okt 2026
- [2] OmniShow: Unifying Multimodal Conditions for Human-Object Interaction Video Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 13 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-19). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från ByteDance (Seed)
- DiffusionOPSD 25 aug 2026
- Dreamina Seedance 2.5 31 jul 2026
- Seedream 5.0 Pro 8 jul 2026
- DreamLite 30 mar 2026
- Lucida –