Lucida
En metod från ByteDance Seed som gör om ett belamrat rum till kompletta, redigerbara 3D-objekt som kan flyttas runt och användas i simulering.
- 3D
- Bildförståelse
- Robotik
 1 / 3
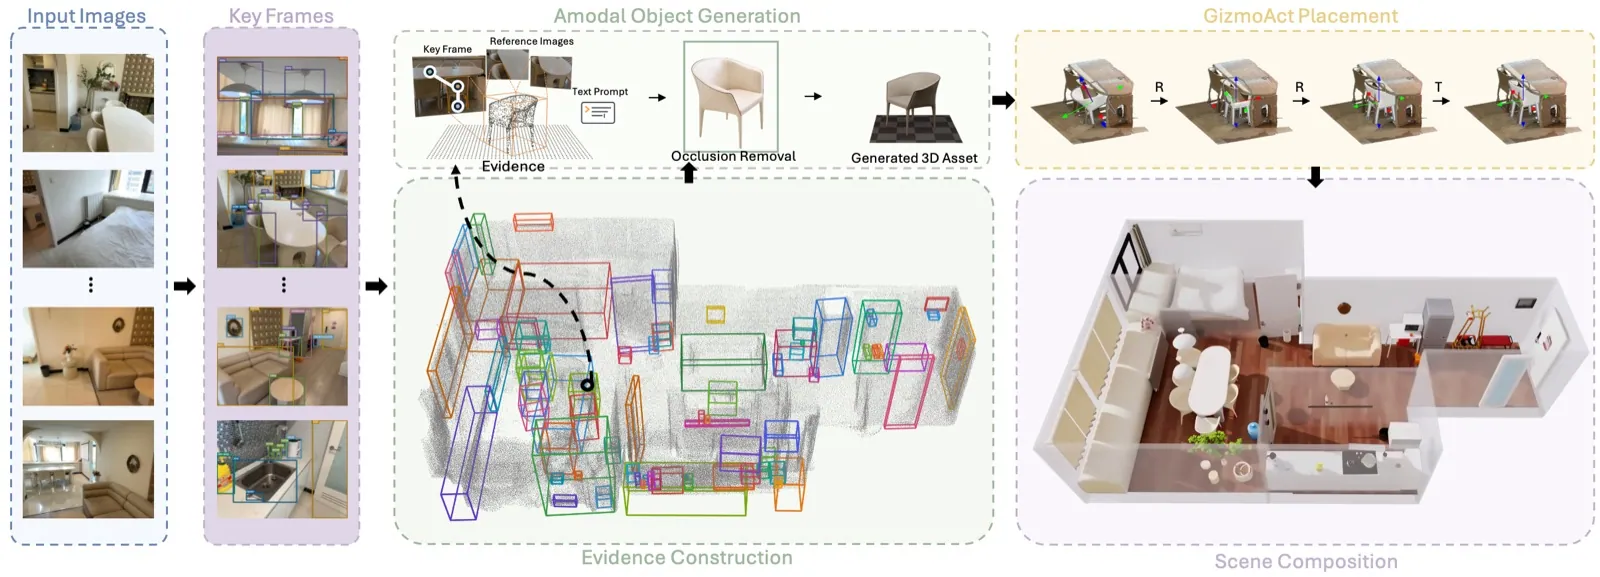
Lucidas tre steg: tolka inspelningen, generera kompletta objekt och placera dem med GizmoAct [1]
Om Lucida[1][2]
Lucida återskapar riktiga inomhusmiljöer, till exempel ett stökigt rum, som en samling hela och separata 3D-objekt placerade som i verkligheten. Varje möbel eller sak blir ett eget redigerbart 3D-nät som kan flyttas och användas i simulering, till exempel för att träna robotar ("real-to-sim").
Metoden arbetar i tre steg. Först tolkas inspelningen: informativa bildrutor väljs ut, samma objekt kopplas ihop mellan olika vyer och en kontrollerad scengraf byggs med masker, delvisa punktmoln och 3D-lådor. Sedan genereras varje objekt: en bild av objektet utan skymmande saker skapas och lyfts till en komplett 3D-modell. Till sist placeras objekten. Där används GizmoAct, där en bild- och språkmodell styr ett 3D-redigeringsprogram i en sluten loop och gör en justering i taget av objektets läge tills det renderade objektet stämmer med inspelningen.
Enligt forskarna förbättrar Lucida 3D-objektdetektion, positionsbestämning av objekt och fullständig scenrekonstruktion på testerna R2S, CA-1M och Aria Digital Twin. Projektsidan har en interaktiv 3D-demo, men ingen kod, modell eller artikellänk publicerades där när detta skrevs, och något exakt publiceringsdatum framgår inte.
Arbetet kommer från ByteDance Seed, med praktikanter från Peking University och Zhejiang University.
Det viktigaste[1]
- Gör om ett rum till separata, kompletta och redigerbara 3D-objekt klara för simulering.
- Tre steg: tolka inspelningen, generera hela objekt och placera dem.
- En bild- och språkmodell justerar varje objekts läge i ett 3D-program tills det stämmer med verkligheten (GizmoAct).
- Enligt forskarna bättre objektdetektion, positionsbestämning och scenrekonstruktion på R2S, CA-1M och Aria Digital Twin.
Källor
- [1] Lucida: Parse, Generate, and Place for Composable Real-to-Sim Scene Modeling ↗ByteDance Seed Officiell sida lucida-r2s.github.ioPublicerad okänt datum Läst 25 okt 2026
- [2] GPT 6 Astra, Claude Fable 5.1, Qwen 3.8 0902, Gemini 3.8 Flash, Muse Spark 1.3, Atlas: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 6 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-06). [2]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från ByteDance (Seed)
- DiffusionOPSD 25 aug 2026
- Dreamina Seedance 2.5 31 jul 2026
- Seedream 5.0 Pro 8 jul 2026
- OmniShow 13 apr 2026
- DreamLite 30 mar 2026