Dreamina Seedance 2.5
ByteDance videomodell som gör 30 sekunder video med ljud i ett svep, kan förlängas i flera omgångar och tar upp till 30 bilder, 10 videoklipp och 10 ljudklipp som referenser.
- Videogenerering
- Multimodal
- Animation & rörelse
 1 / 8
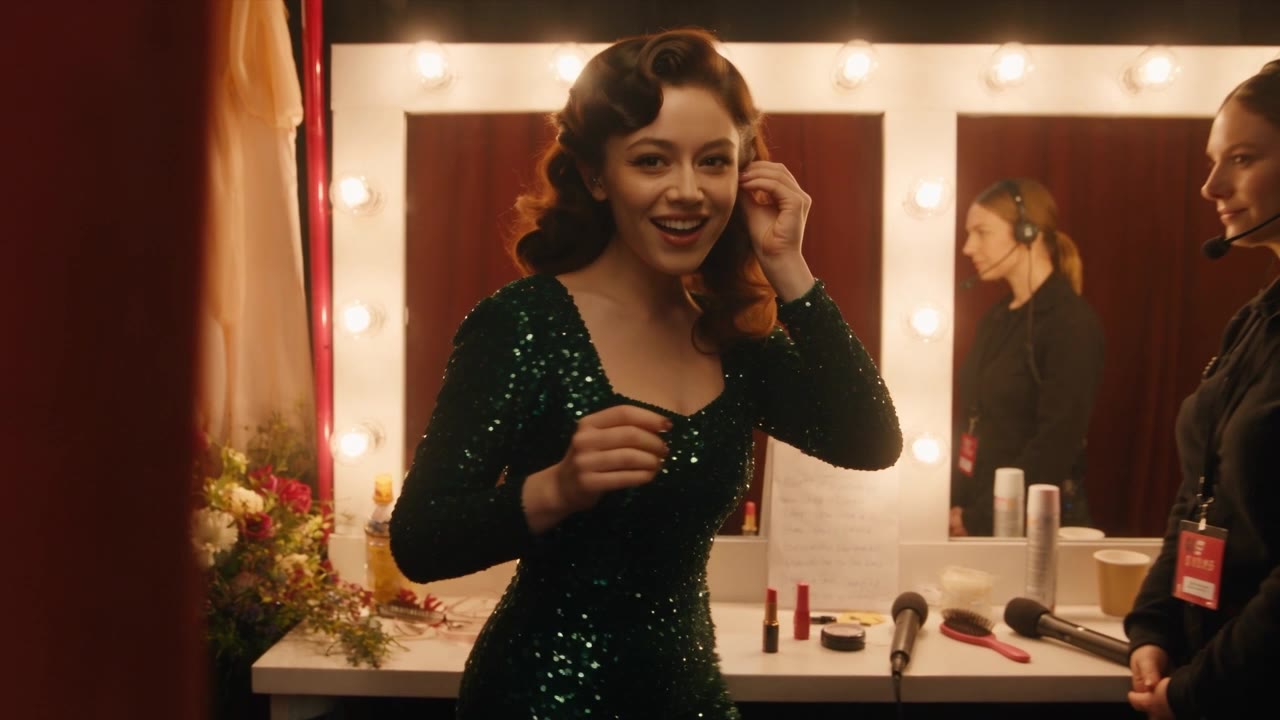
Bild ur tagningen med sångerskan i logen [1]
Om Dreamina Seedance 2.5[1][2]
Seedance 2.5 lanserades av ByteDance Seed den 31 juli 2026 och bygger vidare på Seedance 2.0, som skapar bild och ljud tillsammans. Den största nyheten är längden: ett klipp kan bli 30 sekunder i stället för 15, med flera sammanhängande tagningar som berättar en hel liten historia, och det kan förlängas i flera omgångar så att man får videor på flera minuter där personer, miljö och tempo hålls konsekventa. ByteDance säger också att bild, ljud och rörelser blivit bättre och att den artificiella AI-looken minskat.
Referenserna har byggts ut till upp till 30 bilder, 10 videoklipp och 10 ljudklipp per generering. Modellen kan bland annat följa en enkel 3D-modell utan texturer ("lermodell") för kamerarörelser, positioner och ljus, och hålla isär utseende och röster för många personer i samma scen. Redigering kan styras med tidsstämplar, så att man ändrar en viss person, handling eller kamerarörelse i ett visst avsnitt, och det finns greenscreen-redigering, byte av kameraperspektiv och redigering utifrån referenser. ByteDance nämner också användning inom utbildning, industrisimulering och syntetisk träningsdata för robotar och självkörande bilar.
Modellen rullades först ut i Jimeng AI (Dreamina) och Doubao. Sedan 6 augusti 2026 finns den som Dreamina Seedance 2.5 via BytePlus ModelArk i ett urval av länder (inte USA) och hos tjänster som Higgsfield och Runway. BytePlus beskriver upp till 50 referenser per klipp, C2PA-märkning utöver synliga vattenstämplar och spärrar mot att göra video av riktiga ansikten utan verifiering. ByteDance skriver att fysiken i komplexa rörelser och scener med många personer fortfarande kan bli bättre.
Det viktigaste[1][2]
- 30 sekunder video med ljud i ett svep, och förlängning i flera omgångar till videor på flera minuter.
- Upp till 30 bilder, 10 videoklipp och 10 ljudklipp som referenser; enligt BytePlus upp till 50 referenser per klipp.
- Kan följa en enkel 3D-modell för kameraarbete, positioner och ljus.
- Redigering styrd med tidsstämplar, plus greenscreen och byte av kameraperspektiv.
- Via BytePlus ModelArk sedan 6 augusti 2026, med C2PA-märkning; BytePlus finns inte i USA.
Källor
- [2]
- [1] One-take Creation, Flexible Referencing: Introducing Seedance 2.5 ↗ByteDance Seed Officiell sida seed.bytedance.comPublicerad 31 jul 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan eftersom den finns med i topplistorna. [1]
Placeringar i topplistor
- #3 · 1138 ± 17
- #4 · 1477 ± 7
- #5 · 1158 ± 15
- #7 · 1474 ± 9
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från ByteDance (Seed)
- DiffusionOPSD 25 aug 2026
- Seedream 5.0 Pro 8 jul 2026
- OmniShow 13 apr 2026
- DreamLite 30 mar 2026
- Lucida –