GPT-Live 1
OpenAI:s röstmodell som kan lyssna och prata samtidigt, driver ChatGPT Voice och lämnar över svåra frågor och verktyg till en bakomliggande modell medan samtalet fortsätter.
- Röstassistent
- Tal till text
- Text till tal
- Agenter
 1 / 3
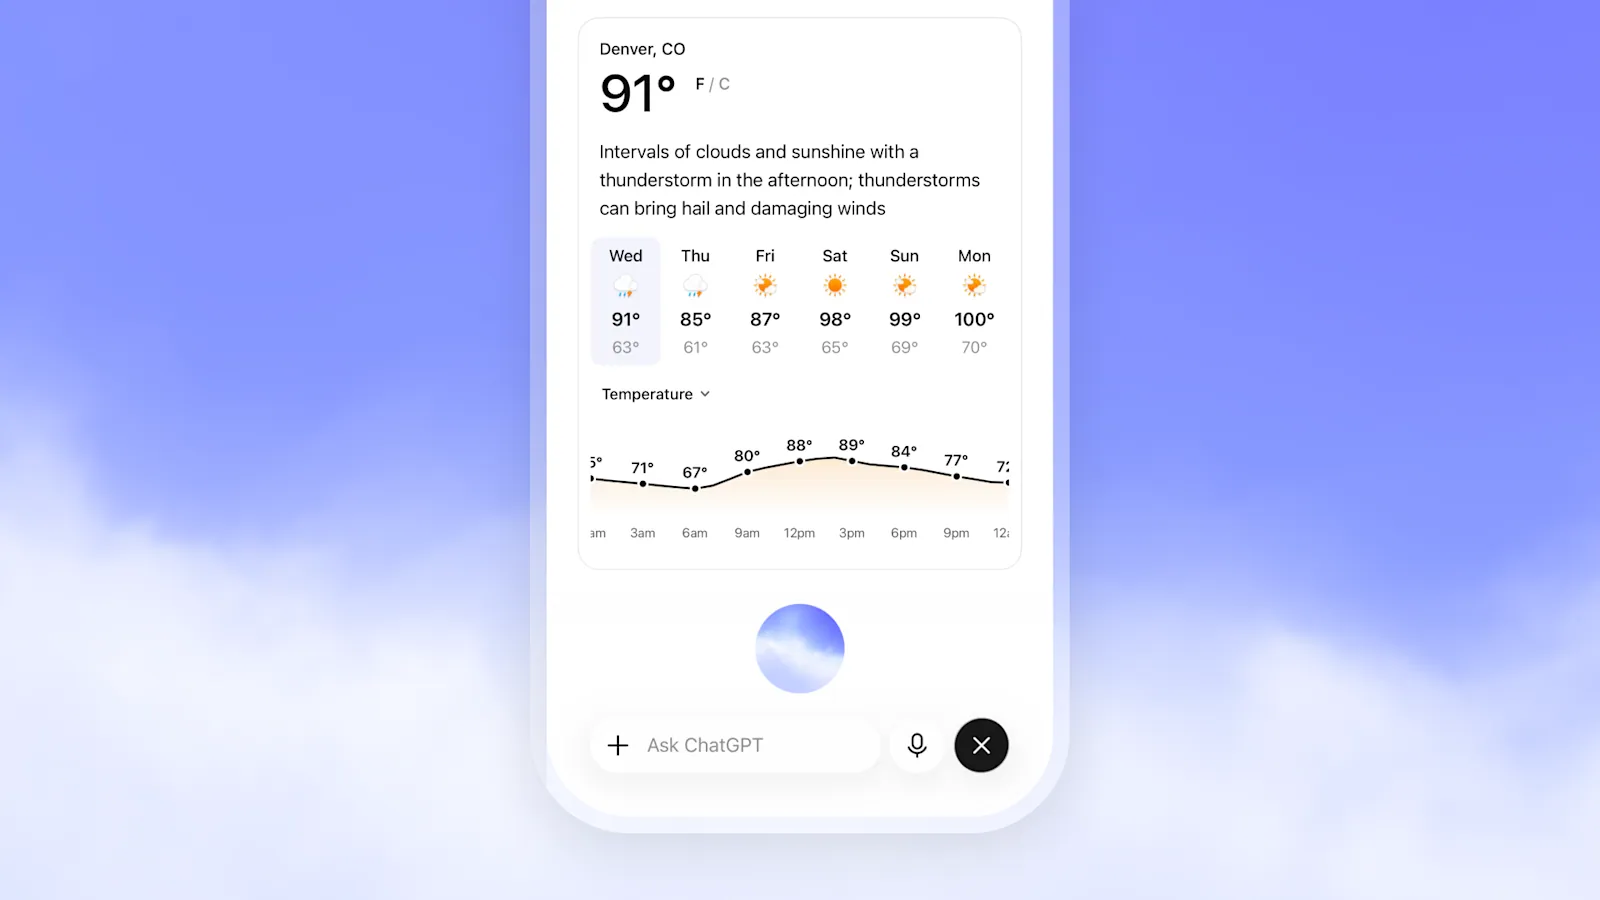
ChatGPT Voice med GPT-Live visar en väderprognos under samtalet [1]
Om GPT-Live 1[1][2][3][4]
GPT-Live är en ny generation röstmodeller från OpenAI som presenterades den 8 juli 2026. Den bygger på en så kallad full duplex-arkitektur: i stället för att vänta på att användaren ska sluta prata bearbetar modellen ljudet hela tiden medan den själv pratar, och fattar flera gånger i sekunden beslut om att tala, lyssna, pausa, avbryta eller använda ett verktyg. Den kan visa att den lyssnar med små ljud som "mhm", vara tyst när användaren tänker och klara avbrott utan att tappa tråden.
GPT-Live sköter själva samtalet och lämnar över tyngre uppgifter, som webbsökning och djupare resonemang, till en annan modell i bakgrunden (först GPT-5.5) och för in svaret i samtalet när det är klart. I ChatGPT ersatte GPT-Live-1 och GPT-Live-1 mini det tidigare Advanced Voice Mode som ChatGPT Voice. Sedan den 31 juli märks ljud från GPT-Live med vattenstämpeln SynthID.
Den 10 september 2026 blev GPT-Live-1 allmänt tillgänglig i API:t. Där kan utvecklare själva välja bakomliggande modell, till exempel GPT-6 Luna för enkla ärenden eller GPT-6 Astra för svårare, eller koppla in en egen agent. Modellen klarar telefoni, ger transkript direkt och kan styras i ton, tempo och stil via systemprompten. Enligt OpenAI förbättrar den resultatet på Full Duplex Bench med 30 procentenheter jämfört med GPT-Realtime-2.1 och hamnar, ihop med GPT-6 Astra, först på rösttestet Tau3. Röstsessionen kostar 0,05 dollar per minut, debiterat per sekund; den bakomliggande modellen betalas separat. I oktober tillkom röster som skapas från en textbeskrivning, nio nya röster på flera språk och en inbyggd koppling till Decisions API.
Det viktigaste[1][2][3]
- Full duplex: lyssnar och pratar samtidigt och klarar avbrott, pauser och bakgrundsljud.
- Lämnar över resonemang och verktyg till en bakomliggande modell medan samtalet fortsätter.
- Driver ChatGPT Voice sedan juli 2026 (GPT-Live-1 och GPT-Live-1 mini).
- Enligt OpenAI 86,2 % på Tau3-rösttestet med GPT-6 Astra i bakgrunden, mot 45,7 % för GPT-Realtime-2.1.
- API-pris 0,05 USD per minut, debiterat per sekund; bakomliggande modell betalas separat.
- Enligt Speak minskade avbrotten mot elever med nästan 80 % jämfört med tidigare turbaserade system.
Källor
- [3] GPT-Live 1 Model ↗OpenAI (API-dokumentation) Officiell sida developers.openai.comPublicerad okänt datum Läst 25 okt 2026
- [4] Changelog ↗OpenAI (API-dokumentation) Officiell sida developers.openai.comPublicerad okänt datum Läst 25 okt 2026
- [2] Build more natural voice experiences with GPT‑Live‑1 in the API ↗OpenAI Officiell sida openai.comPublicerad 10 sep 2026 Läst 25 okt 2026
- [1]
Historik
- 25 okt 2026Tillagd i listan som nyare version/produkt hittad vid genomgången av AI Search-nyheter. [2]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från OpenAI
- Decisions API 22 okt 2026
- Distributed Agents 21 okt 2026
- ChatGPT Intelligent UI 7 okt 2026
- Dots 29 sep 2026
- GPT-6.1 Sol 29 sep 2026
- GPT-6 Luna 22 sep 2026
- GPT-6 Sol 22 sep 2026 · inaktuell
- Astra for Law 17 sep 2026
- ChatGPT for Financial Services 10 sep 2026
- GPT Image 2.5 (Sunburst / Flare) 8 sep 2026
- GPT-6 Astra 3 sep 2026
- Rosalind Workbench 28 aug 2026
- GPT-5.6 Sol Ultrafast 13 aug 2026 · inaktuell
- OpenAI internal math model aug 2026
- GPT-Realtime-2.1 6 jul 2026
- GPT-5.6 Sol 26 jun 2026 · inaktuell
- GPT-5.6 Terra 26 jun 2026
- GPT Image 2 21 apr 2026 · inaktuell
- GPT-Rosalind 16 apr 2026