Ling-3.0-flash-base
En öppen grundmodell från inclusionAI med 124 miljarder parametrar varav bara 5,1 miljarder används åt gången, tänkt som startpunkt för forskare och utvecklare som vill träna vidare själva.
- Språkmodell
- Kod
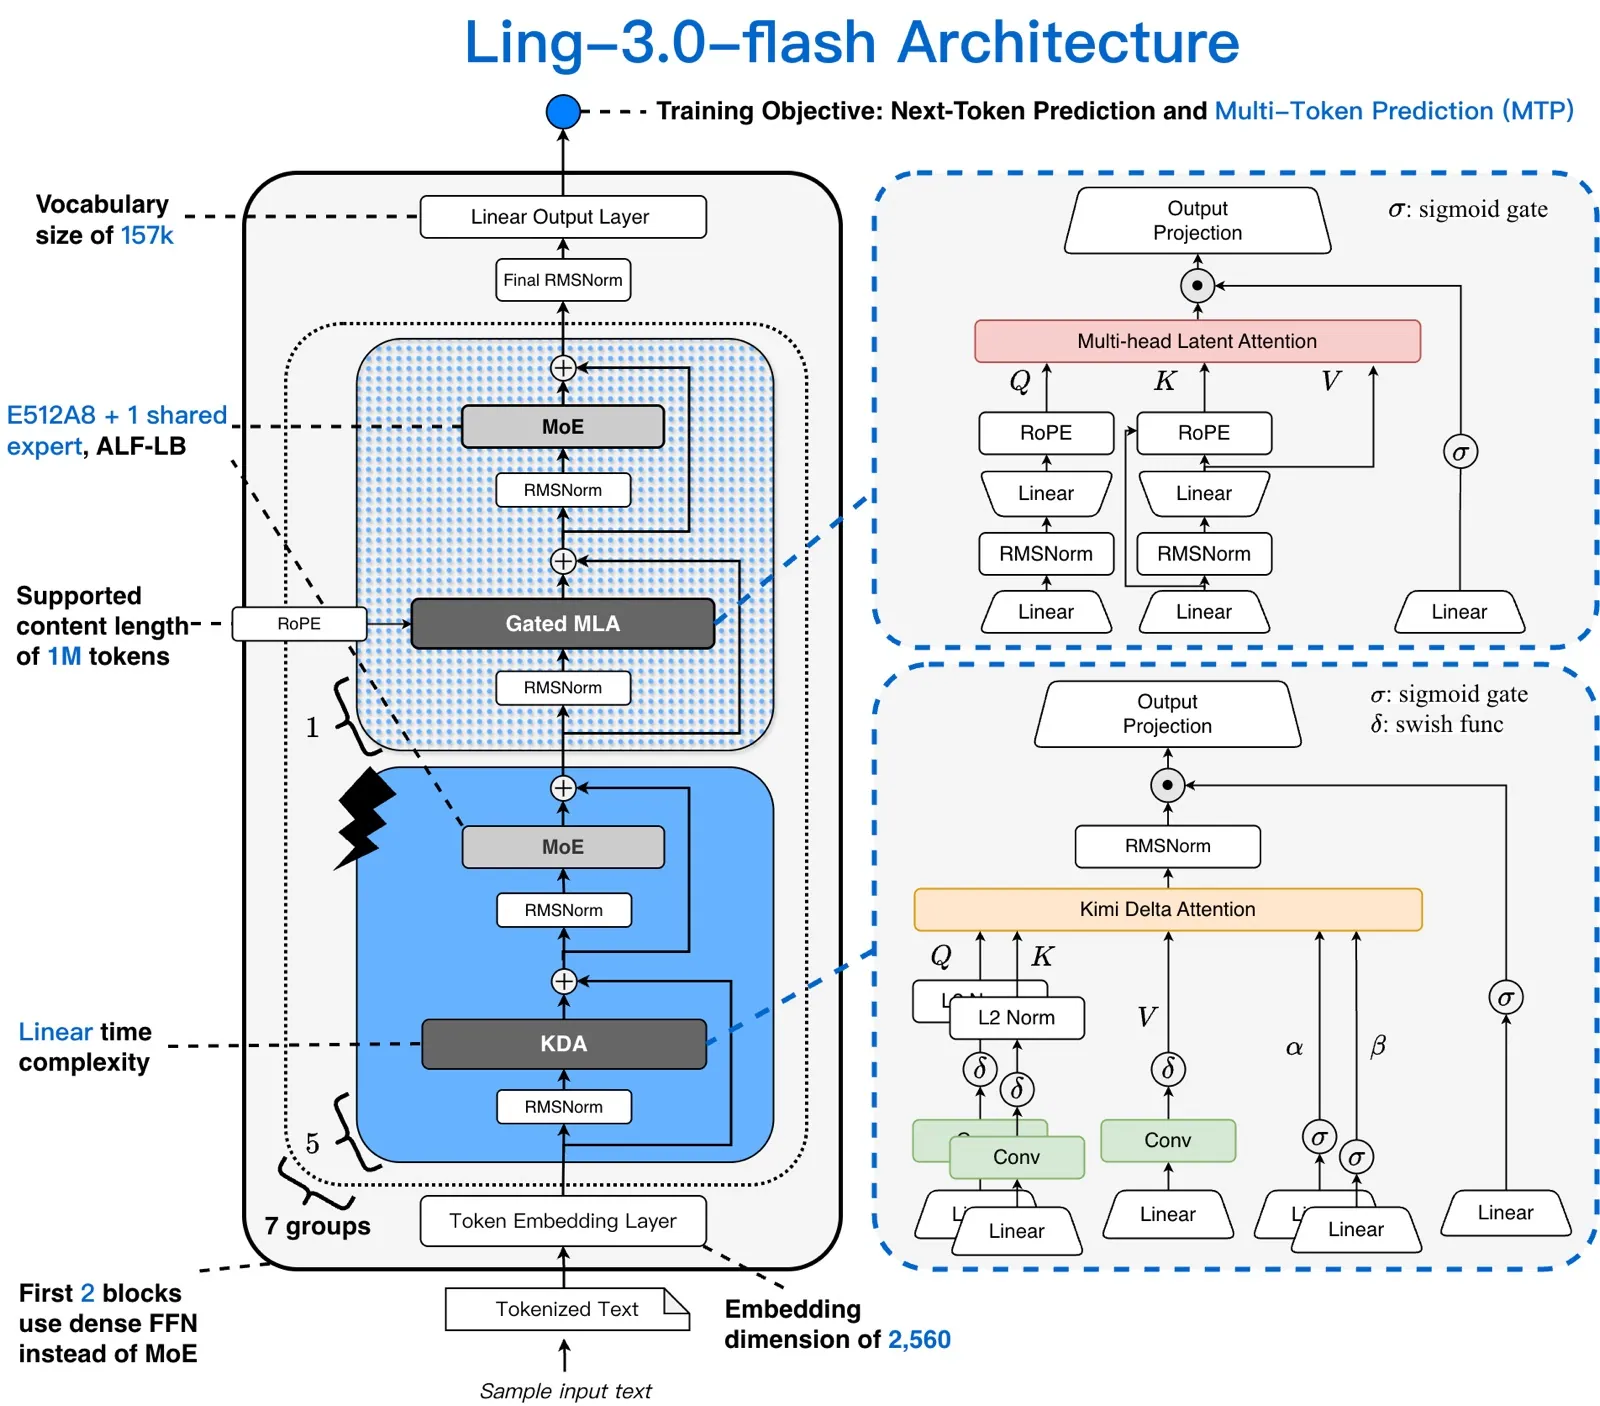
Arkitekturen i Ling-3.0-flash, som bygger på denna grundmodell [2]
Om Ling-3.0-flash-base[1][2][3][4]
Ling-3.0-flash-base är grundmodellen bakom inclusionAI:s språkmodell Ling-3.0-flash. Det är en så kallad basmodell: den har gått igenom den stora förträningen och en mellanträning, men inte den efterträning som gör en modell bra på att chatta och följa instruktioner. inclusionAI släpper den för att andra ska kunna träna vidare, finjustera den för egna områden eller forska på den, och skriver uttryckligen att den inte är tänkt att användas direkt som chattbot.
Modellen är mycket gles: den har 512 experter men aktiverar bara 8 plus en delad expert per token, vilket ger ungefär 5,1 miljarder aktiva parametrar av totalt 124 miljarder. Den blandar linjär uppmärksamhet (Kimi Delta Attention) med gated MLA i förhållandet 5:1 (35 respektive 7 lager), vilket gör den effektiv på långa texter. Konfigurationen tillåter 262 144 tokens (256k). I stället för att sänka inlärningstakten i slutet av träningen slår inclusionAI ihop sparade kontrollpunkter med en metod de kallar WSM, vilket enligt dem gör modellen lättare att träna vidare på.
Tillsammans med den släpptes även tidigare kontrollpunkter från träningen (efter förträning och efter mellanträning) och en mindre syskonmodell, Ling-3.0-tiny-base, som tränats med samma recept så att man kan prova idéer i liten skala först. Enligt inclusionAI:s egna mätningar slår den bland annat Nemotron 3 Super, Step 3.5 Flash och MiMo-V2.5 på flera tester inom kod, matematik och långa texter. Vikterna är öppna under MIT-licens.
I oktober 2026 kom efterföljaren Ling-3.1-flash, som är betydligt större.
Det viktigaste[1]
- Grundmodell utan efterträning, släppt för vidareträning, finjustering och forskning, inte för direkt chattanvändning.
- 124 miljarder parametrar men bara 5,1 miljarder aktiva per token (512 experter, 8 aktiva).
- Blandar linjär och vanlig uppmärksamhet i förhållandet 5:1 för att klara långa texter effektivt.
- Enligt inclusionAI får den bäst resultat i sin jämförelse på bland annat MMLU-Pro (67,74), MATH500 (79,0) och LongBench (52,62).
- Öppna vikter under MIT-licens, tillsammans med kontrollpunkter från olika steg i träningen.
Källor
- [3] inclusionAI/Ling-3.1-flash ↗inclusionAI Modellkort huggingface.coPublicerad 13 okt 2026 Läst 25 okt 2026
- [4] Deepseek Vision, Ornith 1.5, GEN 1.5, Happy Shrimp, SenseNova U1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 23 aug 2026 Läst 25 okt 2026
- [1] inclusionAI/Ling-3.0-flash-base ↗inclusionAI Modellkort huggingface.coPublicerad 11 aug 2026 Läst 25 okt 2026
- [2] inclusionAI/Ling-3.0-flash ↗inclusionAI Modellkort huggingface.coPublicerad 2 aug 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från inclusionAI
- Ling-3.1-flash okt 2026
- Ming-3.0-tts okt 2026
- Ming-Image-0.1-Design 17 sep 2026
- Ling-3.0-flash-VL 4 sep 2026
- LLaDA-Image 4 sep 2026
- Ling-3.0-flash-Sante –