LLaDA-Image
En öppen bildmodell på 6 miljarder parametrar från inclusionAI som både skapar bilder från text och redigerar befintliga bilder efter instruktioner, med en snabbversion som klarar sig på 2–4 steg.
- Bildgenerering
- Bildredigering
 1 / 4
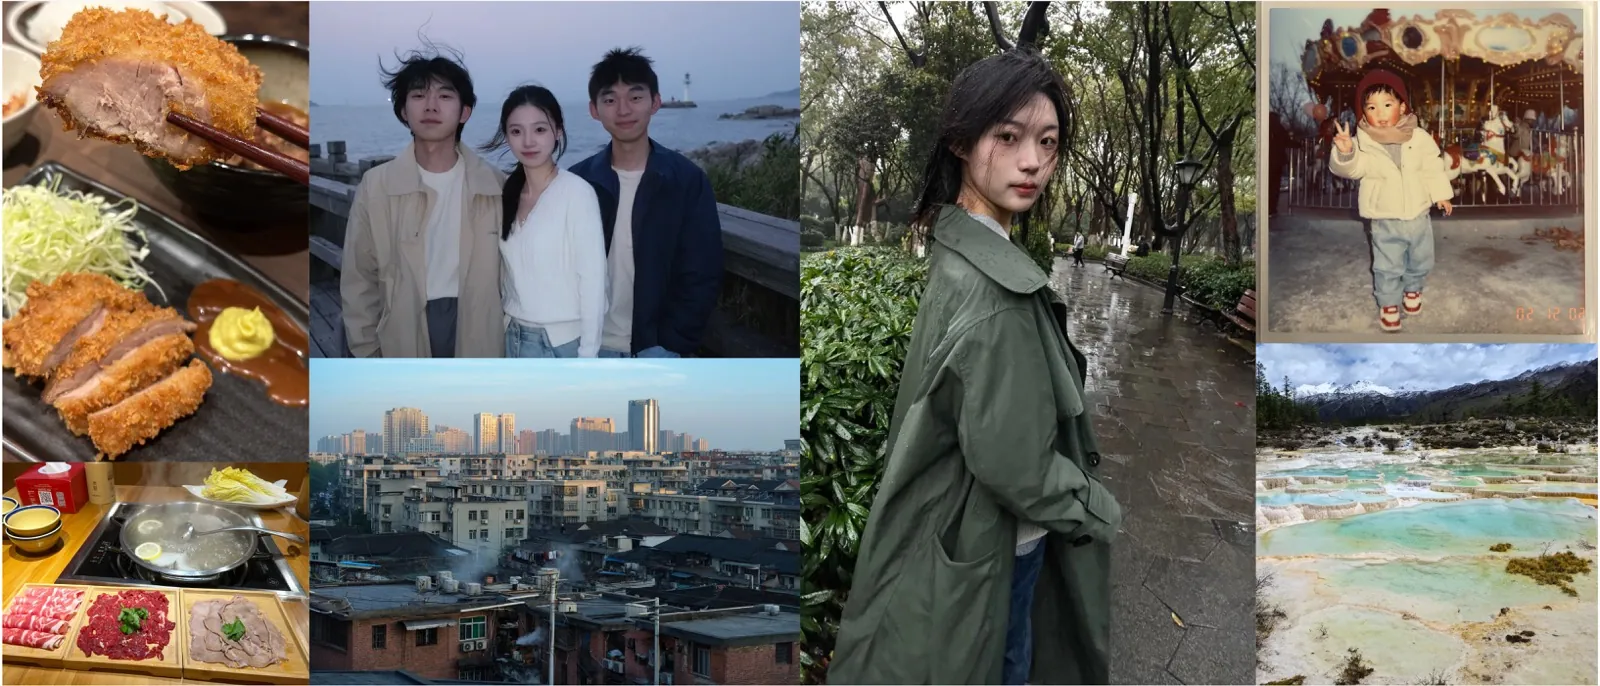
Fotorealistiska bilder med naturligt ljus och detaljer [1]
Om LLaDA-Image[1][2][3][4]
LLaDA-Image är en familj öppna bildmodeller från inclusionAI som gör två saker i samma modell: skapar bilder från en textbeskrivning och redigerar en befintlig bild efter en instruktion, som "gör om den till en akvarellmålning", utan att resten av bilden ändras i onödan. Modellen kan också skriva text i bilder på både engelska och kinesiska, till exempel på affischer.
Kärnan är en diffusionstransformer (DiT) på 6 miljarder parametrar som tränats från grunden. Den styrs av en fryst modul för bild- och språkförståelse byggd på LLaDA2.0-Mini, inclusionAI:s språkmodell som själv fungerar som en diffusionsmodell. Enligt forskarna byggde de först upp en stark känsla för hur bilder ser ut genom att träna enbart på bilder, och lade till parade bild–text-exempel först senare.
Familjen har två varianter. Basmodellen LLaDA-Image är gjord för högsta kvalitet och använder 50 steg per bild. LLaDA-Image-Turbo är destillerad med en metod som kallas Twin-DMD och klarar generering och redigering på 2–4 steg, vilket gör den mycket snabbare. Båda finns även i FP8-format som tar mindre minne.
Enligt inclusionAI får LLaDA-Image 53,53 på engelska och 53,38 på kinesiska på Qwen-Image-Bench, det högsta bland öppna modeller enligt dem. Vikterna och koden för att köra modellen släpptes den 4 september 2026 under Apache 2.0-licens. Forskningsartikeln säger att även träningskoden släpps, men enligt GitHub-sidan är den ännu inte publicerad ("coming soon"). Det finns även stöd för ComfyUI via en tredjepartsutvecklare.
Det viktigaste[1][2]
- En och samma modell skapar bilder från text och redigerar befintliga bilder efter instruktioner.
- Basmodellen använder 50 steg för högsta kvalitet, Turbo-versionen klarar sig på 2–4 steg.
- Skriver text i bilder på engelska och kinesiska, till exempel på affischer.
- Enligt inclusionAI bäst bland öppna modeller på Qwen-Image-Bench: 53,53 (engelska) och 53,38 (kinesiska).
- Öppna vikter under Apache 2.0, även i mindre minneskrävande FP8-versioner. Träningskoden är utlovad men ännu inte släppt.
Källor
- [3] inclusionAI/LLaDA-Image ↗inclusionAI Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [4] GPT 6 Astra, Claude Fable 5.1, Qwen 3.8 0902, Gemini 3.8 Flash, Muse Spark 1.3, Atlas: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 6 sep 2026 Läst 25 okt 2026
- [1] LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes ↗inclusionAI Officiell sida github.comPublicerad 4 sep 2026 Läst 25 okt 2026
- [2] LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes ↗arXiv Forskningsartikel arxiv.orgPublicerad 3 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-06). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från inclusionAI
- Ling-3.1-flash okt 2026
- Ming-3.0-tts okt 2026
- Ming-Image-0.1-Design 17 sep 2026
- Ling-3.0-flash-VL 4 sep 2026
- Ling-3.0-flash-base aug 2026 · inaktuell
- Ling-3.0-flash-Sante –