Ling-3.1-flash
En stor öppen språkmodell från inclusionAI som kan tänka steg för steg, läsa en miljon tokens och enligt skaparna klarar agentuppgifter, kodning, sökning och kontorsarbete i nivå med ledande modeller.
- Språkmodell
- Resonemang
- Agenter
- Kod
- Sök & kunskap
 1 / 4
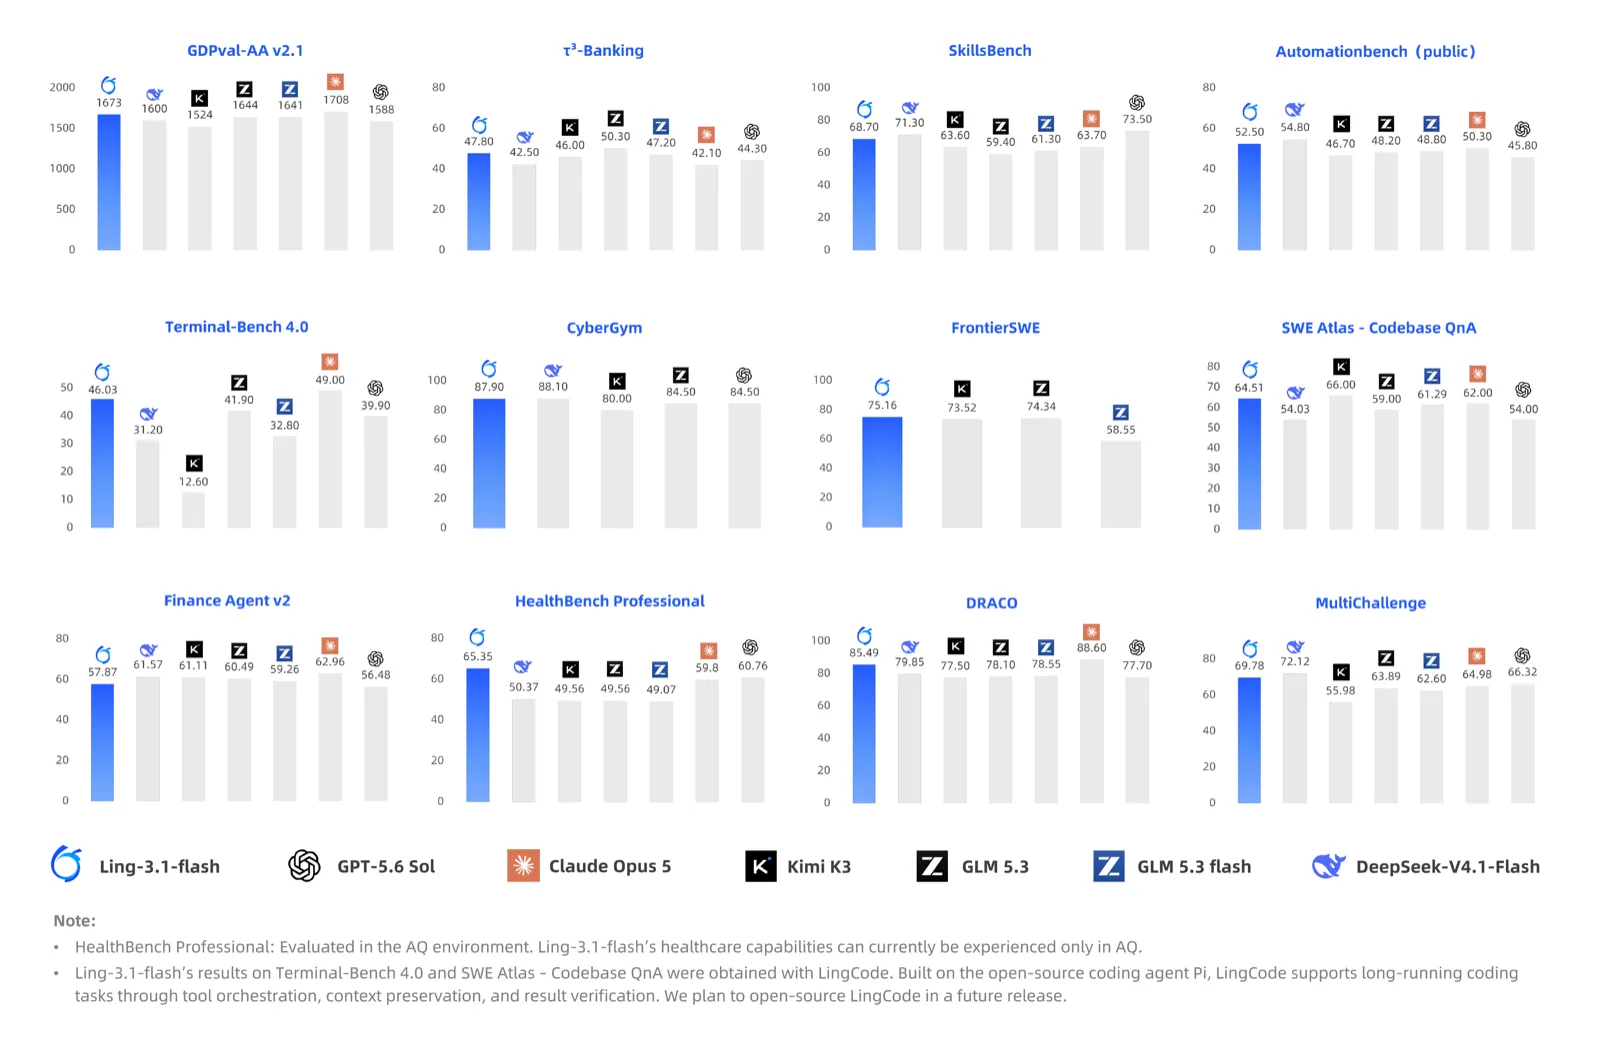
Resultat på tolv tester jämfört med GPT-5.6 Sol, Claude Opus 5, Kimi K3, GLM 5.3 och DeepSeek-V4.1-Flash (inclusionAI:s egna mätningar) [1]
Om Ling-3.1-flash[1][2][3][4][5]
Ling-3.1-flash är inclusionAI:s uppgraderade version av Ling-3.0-flash, en så kallad hybridresonerande modell som kan tänka steg för steg innan den svarar (det går att slå av per förfrågan). Enligt inclusionAI bygger den vidare på Ling-3.0-flash med förbättrad arkitektur och bättre resultat på verkliga uppgifter. Den är också betydligt större: Ling-3.0-flash har 124 miljarder parametrar varav 5,1 miljarder aktiva, medan Ling-3.1-flash har 560 miljarder totalt och 25 miljarder aktiva per token. Den kan läsa upp till en miljon tokens.
Arkitekturen är en mixture-of-experts med 512 experter, där 8 används per token, och den blandar linjär uppmärksamhet (Kimi Delta Attention) med gated MLA i förhållandet 7:1 (63 respektive 9 lager). Ling-3.0-flash använde förhållandet 5:1.
Enligt inclusionAI är modellen bra på generella agentuppgifter, sökning, kontorsarbete och programmering, och presterar starkt på tester som GDPVal-AA V2.1, HealthBench Professional, FrontierSWE och Terminal-Bench 4.0. Den ska också ha blivit bättre inom finans och materialvetenskap. I deras jämförelser ställs den mot bland annat Claude Opus 5, GPT-5.6 Sol, Kimi K3, GLM 5.3 och DeepSeek-V4.1-Flash, och den vinner vissa tester men inte alla. Några resultat är framtagna med LingCode, ett eget agentverktyg för långa kodningsuppgifter byggt på kodagenten Pi, som inclusionAI överväger att släppa som öppen källkod. Vårdresultatet mättes i inclusionAI:s miljö AQ, och enligt dem går modellens vårdförmåga i dagsläget bara att prova där.
Modellen dök upp för anrop via OpenRouter den 2 oktober 2026, och vikterna lades ut öppet under MIT-licens på Hugging Face den 13 oktober. Hos OpenRouter är kontextfönstret 262 144 tokens, alltså mindre än den miljon tokens modellkortet anger, och priset är 0,075 dollar per miljon tokens in och 0,225 dollar per miljon tokens ut. Den är stor: inclusionAI:s rekommenderade upplägg kör den på åtta H200-grafikkort.
Det viktigaste[1][2]
- Uppgraderad efterföljare till Ling-3.0-flash, men betydligt större: 560 miljarder parametrar varav 25 miljarder aktiva per token.
- Kan läsa upp till en miljon tokens och tänka steg för steg, något som går att slå av.
- Enligt inclusionAI får den 75,16 på FrontierSWE och 65,35 på HealthBench Professional, högst i deras jämförelse, och 46,03 på Terminal-Bench 4.0, där bara Claude Opus 5 (49,00) är bättre.
- Enligt inclusionAI fungerar den bra i agentverktyg som Claude Code, Kilo Code, Qwen Code, Hermes Agent och OpenClaw.
- Öppna vikter under MIT-licens.
Källor
- [1] inclusionAI/Ling-3.1-flash ↗inclusionAI Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [2] inclusionAI/Ling-3.0-flash ↗inclusionAI Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [3] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [4]
Historik
Placeringar i topplistor
- Artificial Analysis Intelligence IndexVersionen från 19 okt#15 · 44
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Ling-3.0-flash-base aug 2026
Mer från inclusionAI
- Ming-3.0-tts okt 2026
- Ming-Image-0.1-Design 17 sep 2026
- Ling-3.0-flash-VL 4 sep 2026
- LLaDA-Image 4 sep 2026
- Ling-3.0-flash-base aug 2026 · inaktuell
- Ling-3.0-flash-Sante –