NVIDIA Nemotron 3.5 Lightning
Liten och snabb öppen språkmodell från NVIDIA (30 miljarder parametrar, 3 miljarder aktiva) för specialiserade uppgifter i agentsystem, som kan köras lokalt på RTX-datorer och släpptes ihop med routningsbiblioteket NeMo Switchyard.
- Språkmodell
- Resonemang
- Kod
- Agenter
- Kör lokalt
 1 / 4
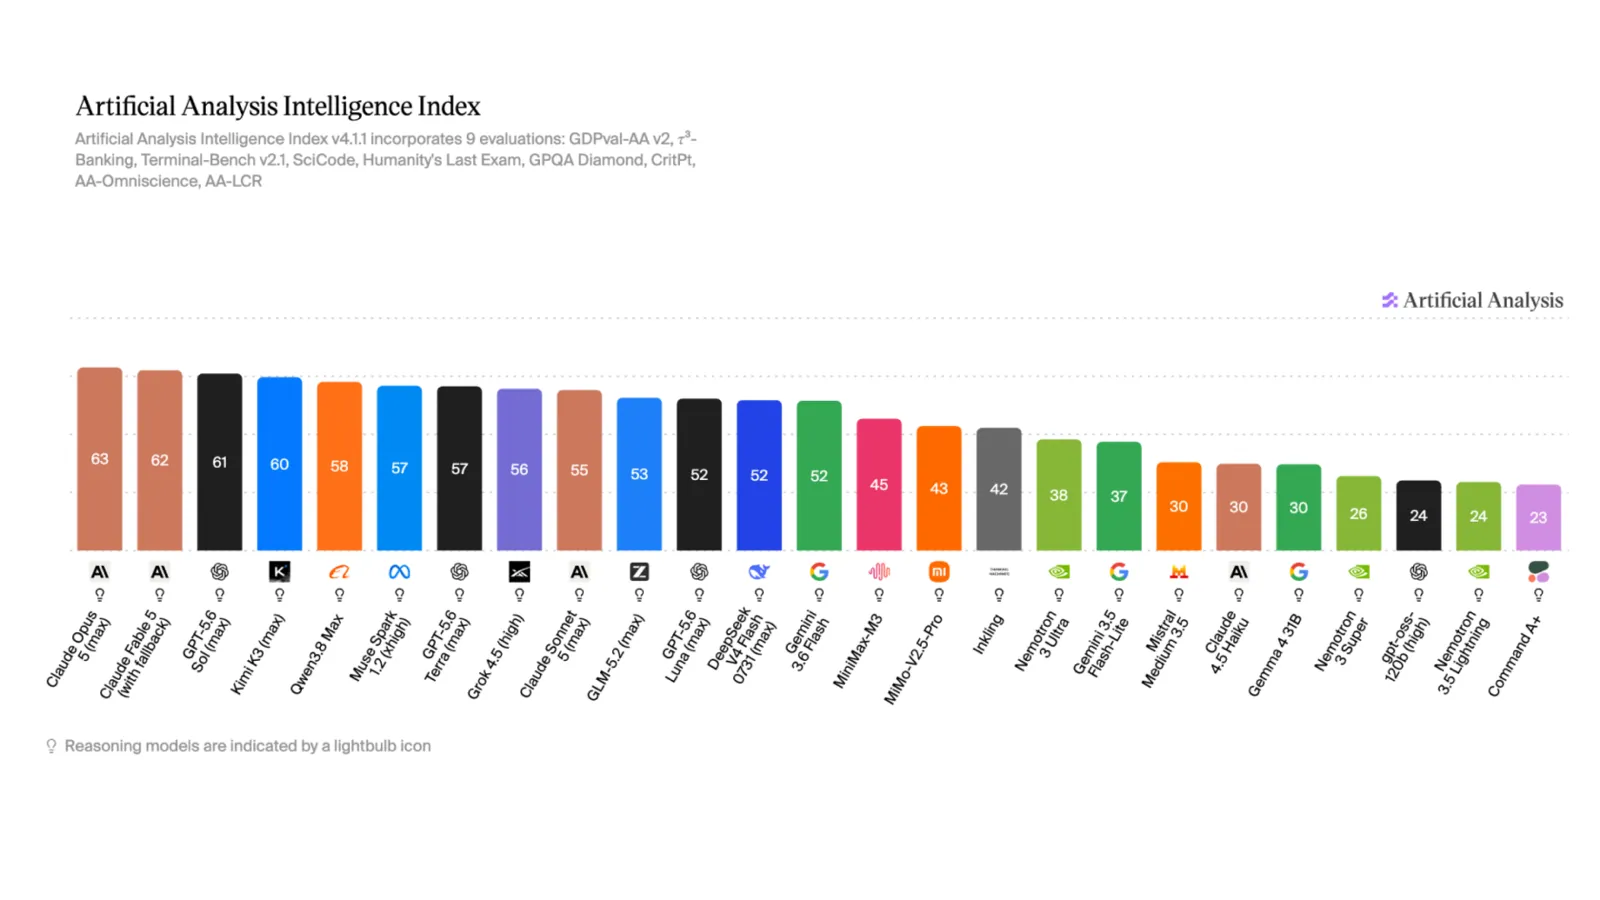
Artificial Analysis Intelligence Index, där Nemotron 3.5 Lightning får 24 poäng [1]
Om NVIDIA Nemotron 3.5 Lightning[1][2][3]
Nemotron 3.5 Lightning är en öppen språkmodell från NVIDIA och efterföljare till Nemotron 3 Nano. Den är tänkt för avgränsade uppgifter i system där flera AI-modeller samarbetar, till exempel kodgranskning, verktygsanvändning, övervakning av säkerhetslarm och frågor om fakturor. Modellen har 30 miljarder parametrar totalt, men bara omkring 3 miljarder används per token, vilket gör den snabb. Arkitekturen är en hybrid av Mamba-2-lager, mixture-of-experts-lager och vanliga attention-lager, med flertokensprediktion, och kontextfönstret är upp till en miljon tokens.
Enligt NVIDIA ger modellen upp till fyra gånger snabbare utdata, vilket gör att agentuppgifter blir klara omkring 30 procent snabbare än med andra modeller i samma klass. Tanken är att företag ska efterträna den på sina egna data, verktyg och arbetsflöden med NVIDIA NeMo. NVIDIA nämner bland andra CrowdStrike, Harvey, CodeRabbit, Lila Sciences och Fastino Labs som användare.
Modellen kan köras på allt från RTX-datorer, DGX Spark, DGX Station och Jetson till datacenter och moln. Vikterna finns på Hugging Face i 4-bitarsformatet NVFP4 och som GGUF för llama.cpp, och den finns i Ollama, på OpenRouter, ModelScope och som NVIDIA NIM. Licensen är OpenMDW-1.1, som tillåter kommersiell användning.
Samtidigt släppte NVIDIA NeMo Switchyard, ett öppet bibliotek som skickar varje steg i ett agentflöde till den lämpligaste modellen, öppen eller stängd, utan att man behöver skriva om sin app. Enligt NVIDIA:s egna tester behåller det nästan toppmodellernas träffsäkerhet till ungefär en tredjedel av kostnaden jämfört med att bara använda Claude Opus 4.8.
Det viktigaste[1][2]
- 30B parametrar men bara cirka 3B aktiva per token, byggd för snabba, specialiserade agentuppgifter.
- Enligt NVIDIA upp till 4 gånger snabbare utdata och cirka 30 % snabbare agentuppgifter än jämförbara modeller.
- Enligt NVIDIA:s modellkort 81,9 på MMLU Pro, 75,4 på GPQA Diamond och 51,6 % på SWE-bench Verified (BF16).
- Kontextfönster på upp till 1 miljon tokens; kan köras lokalt via Ollama och llama.cpp.
- Öppna vikter under OpenMDW-1.1 som tillåter kommersiell användning.
- Släpptes ihop med NeMo Switchyard, som fördelar agentsteg mellan billiga och dyra modeller.
Källor
- [3] Deepseek v4 0813, Qwen 3.8 27B, GLM 5.3, Grok 4.6, LTX 2.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 16 aug 2026 Läst 25 okt 2026
- [1] NVIDIA Nemotron 3.5 Lightning and NeMo Switchyard ↗NVIDIA Officiell sida blogs.nvidia.comPublicerad 11 aug 2026 Läst 25 okt 2026
- [2] nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 ↗NVIDIA (Hugging Face) Modellkort huggingface.coPublicerad 11 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-16). [3]
Placeringar i topplistor
- #82 · 13
- #82 · 2.88% ± 1.16
- #109 · 4.27% ± 0.49
- LMArena TextKomprimerad version (NVFP4)#216 · 1353 ± 5
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från NVIDIA
- NVIDIA Nemotron 3.5 Super VL 15 okt 2026
- StreamRender-H3 okt 2026
- PixelUMM 29 sep 2026
- SoL-Refiner 29 sep 2026
- Lyra 2.0 15 apr 2026
- AVO 25 mar 2026