SoL-Refiner
NVIDIA-modell som skalar upp AI-genererad video i låg upplösning till upp till 4K i ett enda steg, och fungerar med video från flera olika videomodeller.
- Videogenerering
- Bildredigering
 1 / 8
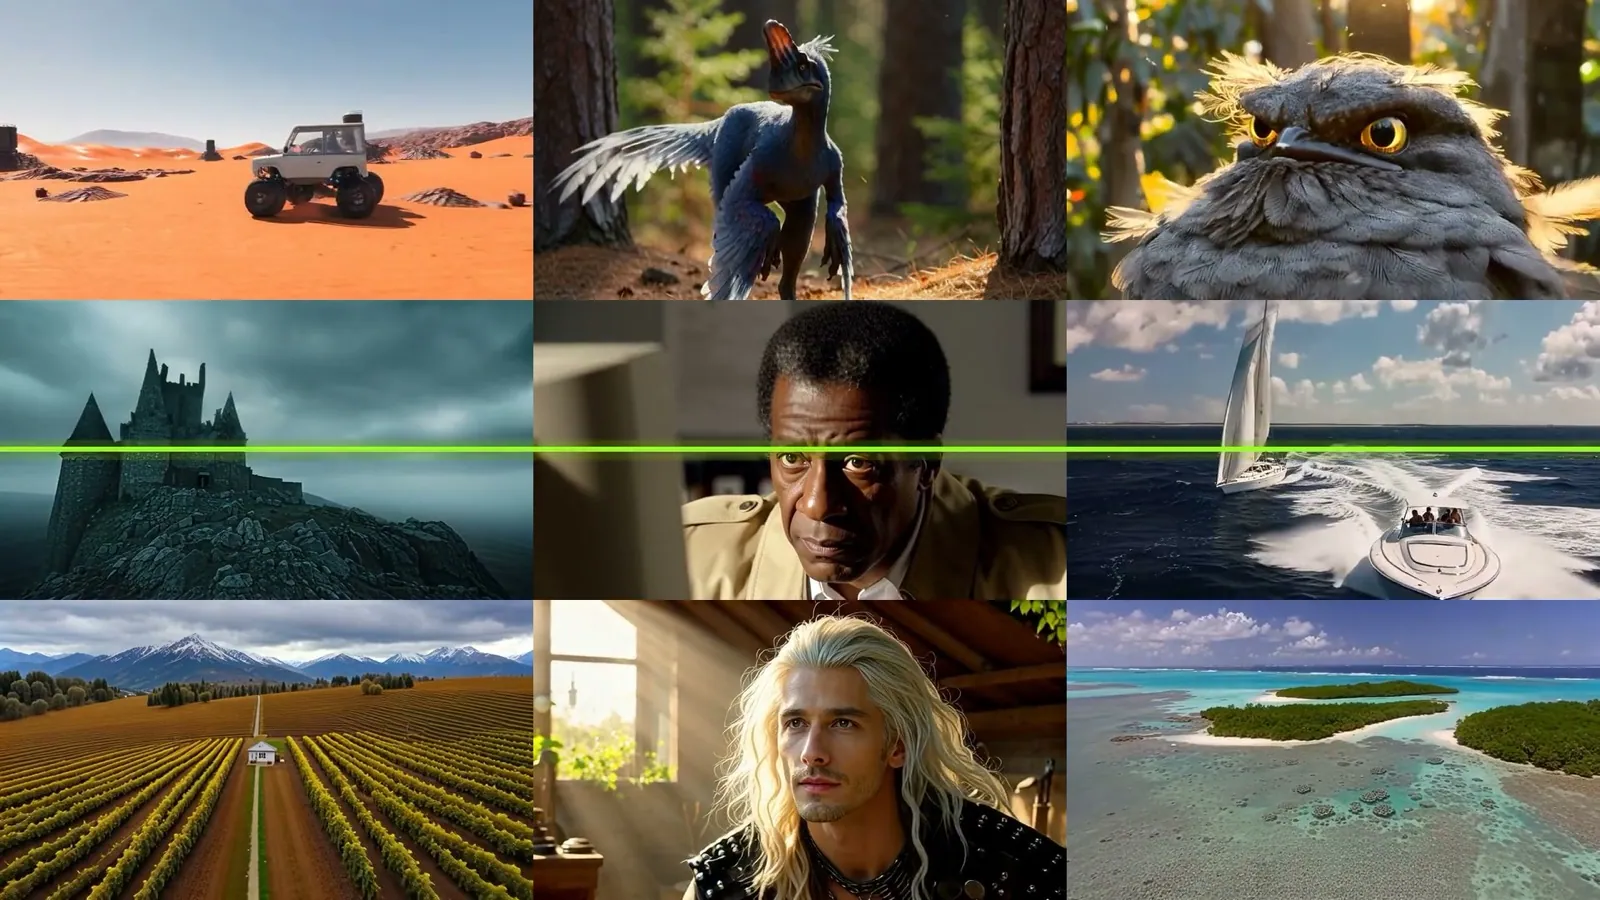
Exempel på förfinade videor från olika videomodeller [1]
Om SoL-Refiner[1][2][3][4][5][6]
Att generera video direkt i hög upplösning är dyrt, eftersom beräkningarna växer snabbt med antalet pixlar och bildrutor. Ett vanligare knep är att först skapa videon i låg upplösning och sedan förfina den, men förfiningen brukar själv kräva flera steg. SoL-Refiner från NVIDIA Research gör förfiningen i ett enda avbrusningssteg direkt i målupplösningen, upp till 4K.
Modellen tränas i tre steg: fortsatt träning i hög upplösning, efterträning med förstärkningsinlärning och till sist destillation ned till ett steg. Den fungerar med video från flera videomodeller, bland annat MiniMax H3, SANA-Video, Cosmos-Nano och WAN. Forskarna har också tagit fram ett eget test, Refiner-Bench, för att jämföra sådana förfinare.
Enligt NVIDIA går hela kedjan avsevärt fortare. För en fem sekunder lång video i 1344 × 768 med MiniMax H3 tar generering direkt i full upplösning 152 sekunder på en GB200-GPU, mot knappt 6 sekunder med låg upplösning plus SoL-Refiner, alltså omkring 27 gånger snabbare. Med WAN blir det enligt projektsidan ungefär 3,5 gånger snabbare. Enligt artikeln slår den alla externa förfinare vid ungefär 2K, och vid 4K förbättrar den båda måtten jämfört med LTX-2.3:s förfinare i tre steg.
Vikterna finns på Hugging Face i tre varianter, byggda på LTX-2.3 respektive LTX-2.5 (den senare anpassad för MiniMax H3). Den största varianten har 19 miljarder parametrar. Projektsidan och modellkorten anger ingen licens.
Det viktigaste[1][2][3]
- Förfinar lågupplöst AI-video till upp till 4K i ett enda steg.
- Fungerar med video från MiniMax H3, SANA-Video, Cosmos-Nano och WAN.
- Enligt NVIDIA omkring 27 gånger snabbare än att generera direkt i full upplösning med MiniMax H3 (5,6 mot 152 sekunder på en GB200).
- Enligt artikeln bättre än alla externa förfinare vid 2K och bättre än LTX-2.3:s förfinare vid 4K.
- Vikterna finns på Hugging Face, men ingen licens anges.
Källor
- [1] SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video ↗NVIDIA Research Officiell sida nvlabs.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3]
- [4] Efficient-Large-Model/SoL-Refiner-LTX-2.3-One-Step ↗NVIDIA (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Gemini 4 Argon, GPT 6.1 Sol, Dots, Claude Sonnet 5.5, Flux 3: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 4 okt 2026 Läst 25 okt 2026
- [6] Gemini 4, GPT 6.1, Plasma conjecture, Napoleon code solved, OpenAI Dots, Claude Sonnet 5.5: AI NEWS ↗AI Search Video youtube.comPublicerad 3 okt 2026 Läst 25 okt 2026
- [2] SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video ↗arXiv Forskningsartikel arxiv.orgPublicerad 29 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-03). [6]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från NVIDIA
- NVIDIA Nemotron 3.5 Super VL 15 okt 2026
- StreamRender-H3 okt 2026
- PixelUMM 29 sep 2026
- NVIDIA Nemotron 3.5 Lightning 11 aug 2026
- Lyra 2.0 15 apr 2026
- AVO 25 mar 2026