PixelUMM
En enda modell från NVIDIA och University of Waterloo som både förstår och skapar bilder och videor direkt i pixlar, utan separata bildkodare.
- Multimodal
- Bildförståelse
- Bildgenerering
- Videogenerering
 1 / 7
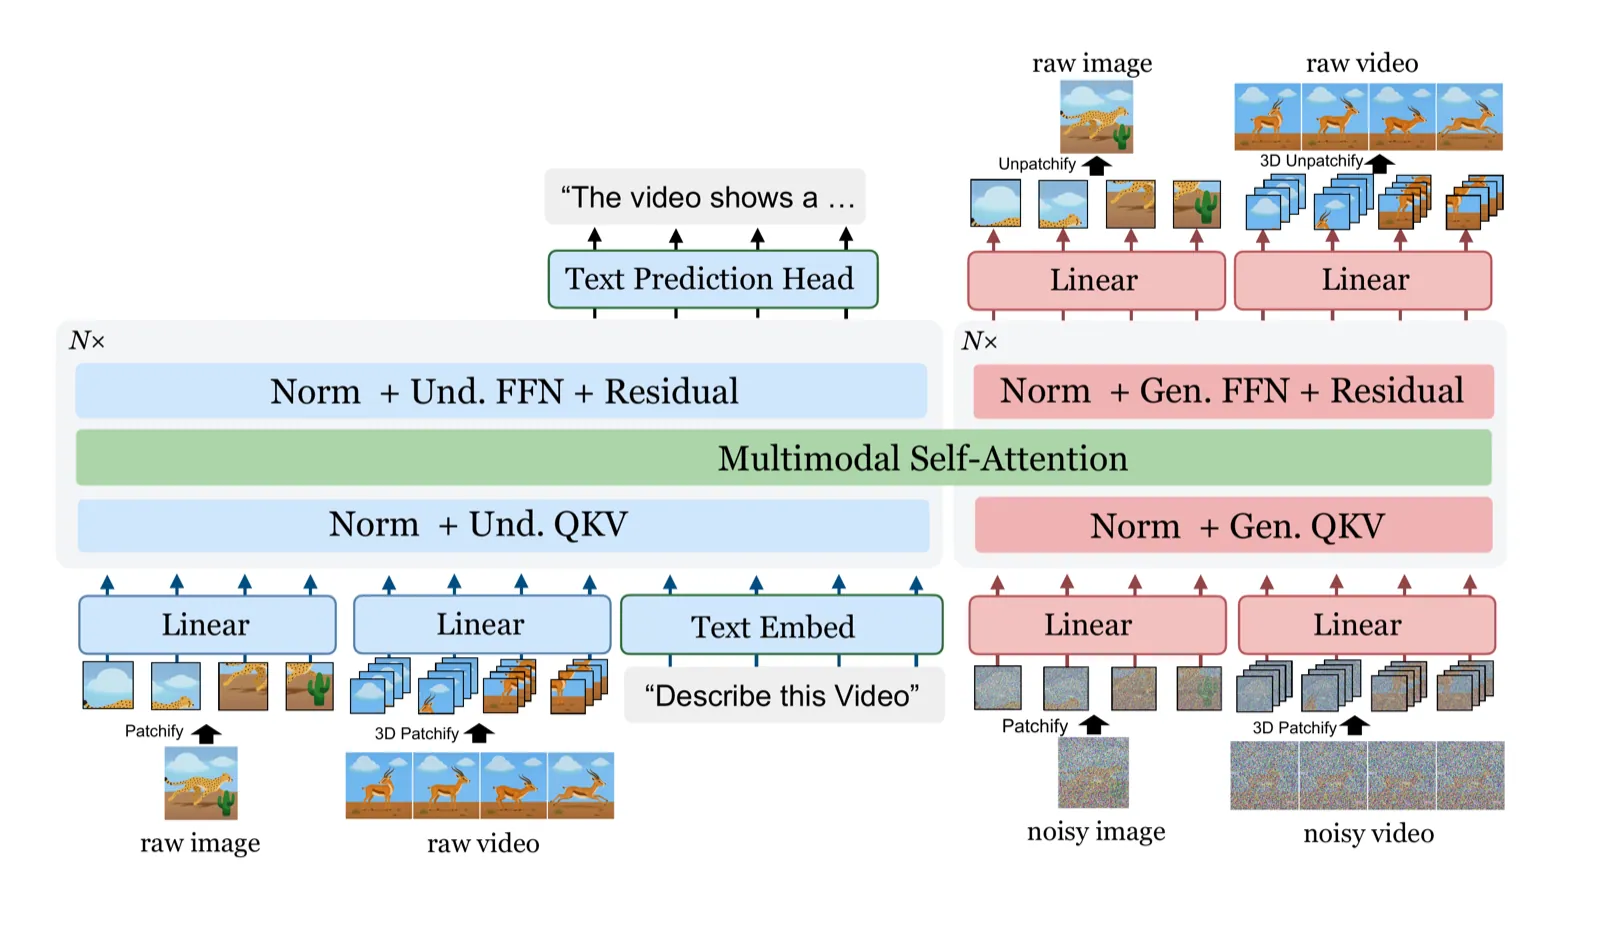
PixelUMM:s arkitektur: förståelse till vänster, generering av bild och video till höger [3]
Om PixelUMM[1][2][3][4][5]
PixelUMM är en så kallad enhetlig multimodal modell: samma modell kan beskriva och svara på frågor om bilder och videor, och kan också generera nya bilder och videor från text eller från en startbild. Det ovanliga är att den arbetar direkt med pixlarna. De flesta liknande system använder separata delar för att komprimera bilder (en VAE) och för att tolka dem (en bildkodare). PixelUMM delar i stället upp bilder i rutor på 16 × 16 pixlar och videor i små block om fyra bildrutor, och skickar dem rakt in i modellen.
Modellen bygger på språkmodellen Qwen3-8B. Inuti finns två uppsättningar experter, en för förståelse och en för generering, som delar på samma uppmärksamhetslager. Vid generering förutsäger modellen rena pixlar och avbrusar videon i 35 steg. Modellkortet anger omkring 15 miljarder parametrar totalt.
Enligt forskarna presterar den i nivå med jämförbara modeller på bild- och videoförståelse, till exempel 90,4 på DocVQA och 70,5 på MVBench, men de påpekar själva att träningsdata skiljer sig så jämförelsen inte visar vilken arkitektur som är bäst. Projektsidan redovisar öppet svagheter: flera liknande saker i samma bild kan smälta ihop eller ändra antal, händer kan få fel antal fingrar, rörelser kan vara fysiskt orimliga och ett svagt rutmönster kan synas i jämna ytor.
Koden är öppen under Apache 2.0, och vikterna finns på Hugging Face under NVIDIA:s icke-kommersiella licens som bara tillåter forskning och utvärdering.
Det viktigaste[1][2][3]
- En modell för både förståelse och generering av bilder och videor.
- Arbetar direkt i pixlar, utan VAE eller separat bildkodare.
- Enligt forskarna i nivå med jämförbara modeller på förståelse, till exempel 90,4 på DocVQA och 70,5 på MVBench.
- Forskarna redovisar själva problem med händer, fysik och flera liknande objekt i samma bild.
- Vikterna får bara användas för icke-kommersiell forskning.
Källor
- [1] PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation ↗NVIDIA och University of Waterloo Officiell sida nv-tlabs.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] nvidia/PixelUMM ↗NVIDIA (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [4] Gemini 4 Argon, GPT 6.1 Sol, Dots, Claude Sonnet 5.5, Flux 3: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 4 okt 2026 Läst 25 okt 2026
- [5] Gemini 4, GPT 6.1, Plasma conjecture, Napoleon code solved, OpenAI Dots, Claude Sonnet 5.5: AI NEWS ↗AI Search Video youtube.comPublicerad 3 okt 2026 Läst 25 okt 2026
- [2] PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 29 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-03). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från NVIDIA
- NVIDIA Nemotron 3.5 Super VL 15 okt 2026
- StreamRender-H3 okt 2026
- SoL-Refiner 29 sep 2026
- NVIDIA Nemotron 3.5 Lightning 11 aug 2026
- Lyra 2.0 15 apr 2026
- AVO 25 mar 2026