GenIA
En metod från Meta och Tübingens universitet som får Metas 3D-modell SAM 3D att skapa kompletta 3D-objekt från foton eller video som stämmer bättre med förlagan, utan att modellen behöver tränas om.
- 3D
- Bildförståelse
 1 / 8
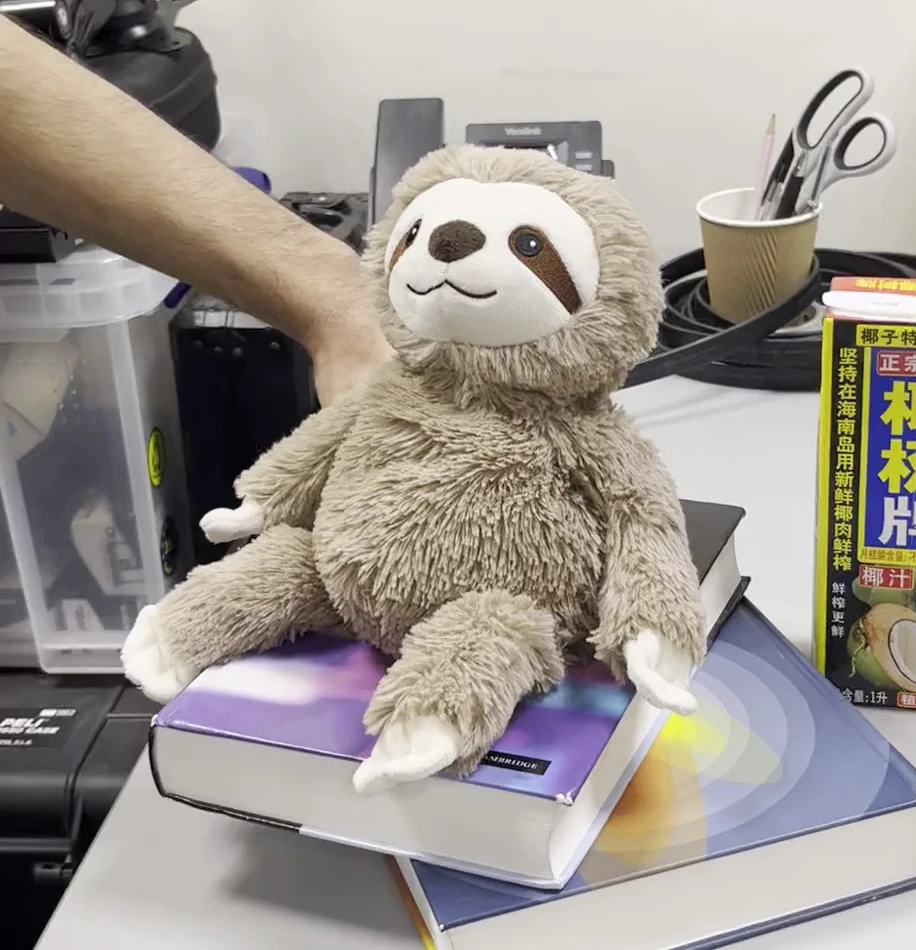
Indata: ett enda foto av ett gosedjur [1]
Om GenIA[1][2][3][4]
GenIA (Generative Reconstruction with Test-Time Input Alignment) är ett forskningsprojekt som gör om en eller flera bilder, eller en vanlig video, till ett komplett 3D-objekt. Generativa 3D-modeller som Metas SAM 3D Objects kan gissa hur ett föremål ser ut även på sidor som inte syns i bilden, men resultatet stämmer ofta inte riktigt med förlagan: formen, färgerna eller objektets position och storlek blir fel.
GenIA löser det genom att styra den färdigtränade SAM 3D-modellen medan den genererar objektet, i stället för att träna om den. Metoden använder geometrin och utseendet i de bilder man faktiskt har som rättesnöre: storlek och position räknas fram ur geometrin, utseendet justeras mot bilderna under själva genereringen, och ett valfritt efterarbete finjusterar färger och placering ytterligare. Det gör att samma modell, som bara tränats på enstaka stillbilder, också klarar flera vyer och rörliga objekt i video. För video hämtas formerna i varje bildruta från Metas modell ActionMesh, och GenIA tar fram ett gemensamt utseende och en stabil placering i rummet.
Enligt forskarna ger GenIA bättre position och 3D-rekonstruktion än tidigare metoder på både syntetiska och verkliga tester, med en bild, flera vyer och video. Projektsidan redovisar också begränsningar: rotationen styrs fortfarande mest av modellens egna antaganden, och i video kan fel i ActionMesh eller i placeringen göra resultatet betydligt sämre.
Arbetet kommer från Tübingen AI Center vid Tübingens universitet och Meta (Reality Labs). Koden finns på GitHub under licensen CC BY-NC 4.0, alltså bara för icke-kommersiellt bruk, och flera av de ingående delarna har egna licenser. Den kräver ett Nvidia-grafikkort.
Det viktigaste[1][2][3]
- Skapar kompletta 3D-objekt från en bild, några bilder eller en video.
- Styr Metas SAM 3D-modell under genereringen så att resultatet stämmer med förlagan, utan omträning.
- Klarar även rörliga objekt i video, med former från Metas ActionMesh.
- Enligt forskarna bättre än tidigare metoder på både syntetiska och verkliga tester.
- Koden är öppen men får inte användas kommersiellt (CC BY-NC 4.0).
Källor
- [1] GenIA: Generative Reconstruction with Test-Time Input Alignment ↗Tübingens universitet och Meta Officiell sida facebookresearch.github.ioPublicerad okänt datum Läst 25 okt 2026
- [4] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [5] New AI enzymes, 700+ math breakthroughs, AI for DNA mutations, room temp semiconductors: AI NEWS ↗AI Search Video youtube.comPublicerad 10 okt 2026 Läst 25 okt 2026
- [2] GenIA: Generative Reconstruction with Test-Time Input Alignment ↗arXiv Forskningsartikel arxiv.orgPublicerad 8 okt 2026 Läst 25 okt 2026
- [3] facebookresearch/GenIA ↗Meta (GitHub) Officiell sida github.comPublicerad 8 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-10-11 och video 2026-10-10). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Meta
- Muse Spark Open 15 okt 2026
- Muse Wonder 12 okt 2026
- Muse Spark 1.3 2 sep 2026
- Muse Voice Transcribe 1 sep 2026
- Muse Glimmer 10 aug 2026
- Muse Code 5 aug 2026
- Muse Spark 1.2 5 aug 2026 · inaktuell
- Muse Image 7 jul 2026
- Muse Spark 8 apr 2026 · inaktuell
- SAM 3.1 27 mar 2026