Muse Glimmer
Metas öppna modell med 30 miljarder parametrar, byggd för AI-agenter som körs lokalt på en vanlig dator med ett grafikkort, under den fria licensen Apache 2.0.
- Språkmodell
- Agenter
- Kod
- Bildförståelse
- Kör lokalt
- Multimodal
 1 / 3
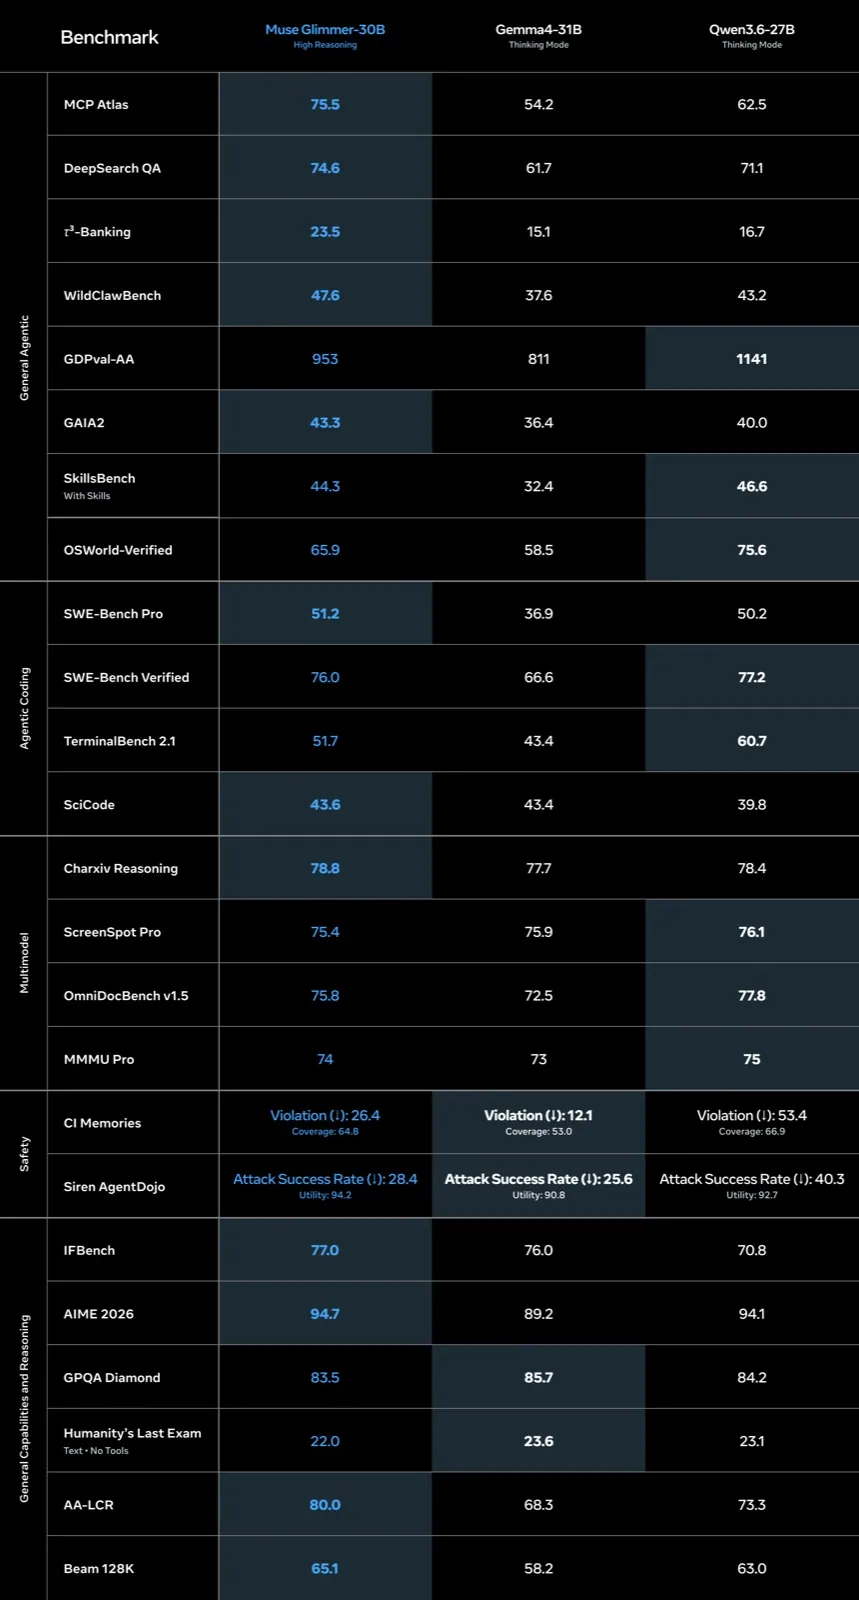
Metas jämförelse av Muse Glimmer med Gemma4-31B och Qwen3.6-27B [1]
Om Muse Glimmer[1][2][3][4]
Muse Glimmer är en språkmodell från Meta Superintelligence Labs med ungefär 30 miljarder parametrar, gjord för agenter som är igång hela tiden på den egna datorn: de planerar i flera steg, anropar verktyg, minns över långa pass och försöker igen när något går fel. Den tar emot text och bilder (till exempel skärmbilder, diagram och dokument) och svarar med text. Den är tränad på data från fler än 100 språk och kan läsa omkring 131 000 tokens åt gången.
Modellen är destillerad från Metas större modell Muse Spark, alltså tränad att efterlikna den. Vikterna är öppna under Apache 2.0, en av de mest tillåtande licenserna, och modellen får användas kommersiellt. I full precision kräver den enligt Meta över 55 GB minne, men komprimerad till ungefär 4 bitar per vikt blir språkmodellen mindre än 20 GB och ryms tillsammans med allt annat på ett grafikkort med 24 eller 32 GB. Meta uppger att komprimeringen nästan inte försämrar resultaten. Med en liten medföljande hjälpmodell (DFlash) som gissar flera ord i förväg blir den enligt Meta 1,5–3,1 gånger snabbare, till exempel cirka 233 tokens per sekund på ett RTX 5090.
I Metas egna jämförelser med Gemma4-31B och Qwen3.6-27B leder Muse Glimmer på flera agenttester, som MCP Atlas och SWE-Bench Pro, men Qwen3.6-27B ligger före på bland annat OSWorld-Verified, Terminal-Bench 2.1 och GDPval-AA. Modellen finns på Hugging Face och kan köras med bland annat Ollama, LM Studio, llama.cpp, MLX, vLLM och ExecuTorch, eller via molntjänster som Together AI, Fireworks och OpenRouter.
Det viktigaste[1][2][3]
- Öppna vikter under Apache 2.0, fritt även för kommersiellt bruk.
- Komprimerad till cirka 4 bitar ryms den på ett grafikkort med 24 eller 32 GB minne, eller på en Mac.
- Enligt Meta 75,5 på MCP Atlas och 51,2 % på SWE-Bench Pro, före Gemma4-31B och Qwen3.6-27B.
- I Metas egen tabell ligger Qwen3.6-27B före på bland annat OSWorld-Verified, Terminal-Bench 2.1 och GDPval-AA.
- Med hjälpmodellen DFlash enligt Meta upp till 3,1 gånger snabbare, cirka 233 tokens per sekund på RTX 5090.
- Destillerad från Metas större modell Muse Spark.
Källor
- [3]
- [4] Deepseek v4 0813, Qwen 3.8 27B, GLM 5.3, Grok 4.6, LTX 2.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 16 aug 2026 Läst 25 okt 2026
- [1] Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device ↗Meta Officiell sida research.meta.aiPublicerad 10 aug 2026 Läst 25 okt 2026
- [2] meta-models/Muse-Glimmer-30B ↗Meta (Hugging Face) Modellkort huggingface.coPublicerad 9 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-16). [4]
Placeringar i topplistor
- Artificial Analysis Intelligence IndexLäge: high#71 · 17
- #120 · 1355 ± 16
- #125 · 1425 ± 10
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Meta
- Muse Spark Open 15 okt 2026
- Muse Wonder 12 okt 2026
- GenIA 8 okt 2026
- Muse Spark 1.3 2 sep 2026
- Muse Voice Transcribe 1 sep 2026
- Muse Code 5 aug 2026
- Muse Spark 1.2 5 aug 2026 · inaktuell
- Muse Image 7 jul 2026
- Muse Spark 8 apr 2026 · inaktuell
- SAM 3.1 27 mar 2026