SAM 3.1
Uppdatering av Metas Segment Anything 3 som hittar, ringar in och följer föremål i bilder och video, nu omkring sju gånger snabbare när många föremål följs samtidigt.
- Bildförståelse
 1 / 2
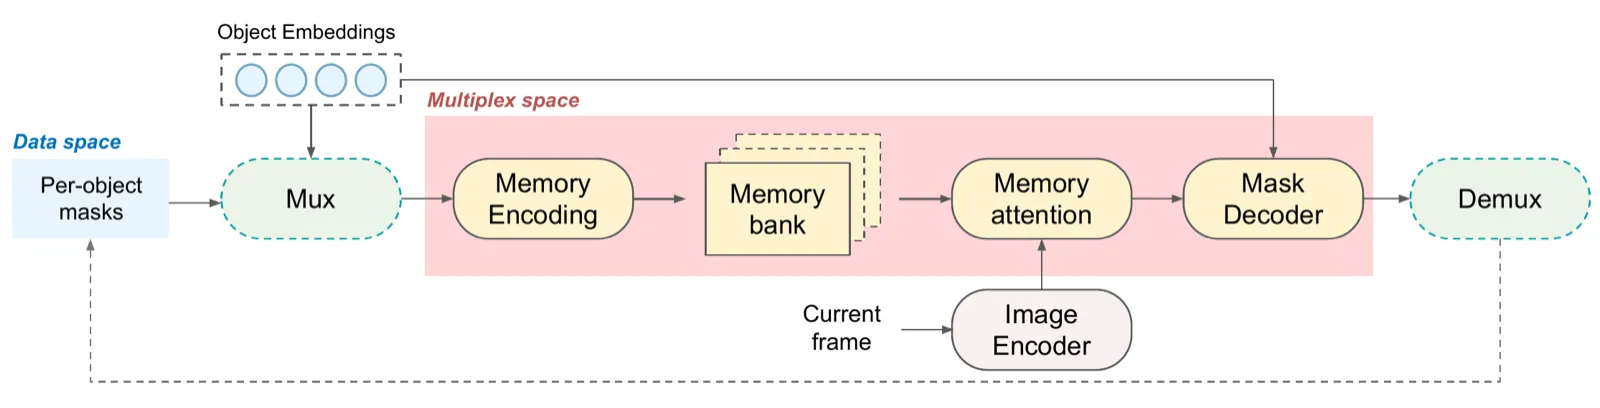
Hur Object Multiplex grupperar föremål för att följa dem tillsammans [2]
Om SAM 3.1[1][2][3][4][5]
SAM 3.1 är en uppdatering av SAM 3 (Segment Anything with Concepts), Metas modell för att hitta och avgränsa föremål i bilder och video. Man skriver en kort fras som "gul skolbuss" eller markerar föremål med rutor och punkter, och modellen returnerar alla träffar med ruta och en pixelexakt mask, och kan följa dem genom en video.
SAM 3.1 släpptes den 27 mars 2026. Den stora nyheten är Object Multiplex: i stället för att följa varje föremål för sig grupperar modellen dem och bearbetar dem tillsammans med delat minne. Enligt Meta blir den då omkring 7 gånger snabbare med 128 föremål på ett H100-grafikkort jämfört med SAM 3 från november 2025, utan att bli sämre. Resultaten på Metas egna videotester är blandade, men den förbättrades på 6 av 7 tester för objektföljning i video, bland annat med 2,0 enheter på MOSEv2.
Vikterna finns på Hugging Face och koden på GitHub under Metas SAM-licens, som tillåter användning, ändring och spridning utan avgift men förbjuder bland annat militär användning. Modellen finns också som sam-3.1 i Meta Model API, där Meta kör den åt användaren för 2,50 dollar per 1 000 bilder och 0,20 dollar per 1 000 videobilder.
Det viktigaste[1][2][4]
- Object Multiplex följer många föremål samtidigt med delat minne.
- Enligt Meta omkring 7 gånger snabbare med 128 föremål på ett H100 jämfört med SAM 3.
- Bättre på 6 av 7 tester för objektföljning i video, enligt Meta.
- Öppna vikter under Metas SAM-licens.
- I Meta Model API: 2,50 dollar per 1 000 bilder och 0,20 dollar per 1 000 videobilder.
Källor
- [1] facebook/sam3.1 ↗Meta (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] facebookresearch/sam3 ↗Meta (GitHub) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] Segment Anything Model (SAM) 3.1 ↗Meta Officiell sida dev.meta.aiPublicerad okänt datum Läst 25 okt 2026
- [5]
- [2] Release Notes: SAM 3.1 ↗Meta (GitHub) Officiell sida github.comPublicerad 27 mar 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan som nyare version/produkt hittad vid genomgången av AI Search-nyheter. [2]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Meta
- Muse Spark Open 15 okt 2026
- Muse Wonder 12 okt 2026
- GenIA 8 okt 2026
- Muse Spark 1.3 2 sep 2026
- Muse Voice Transcribe 1 sep 2026
- Muse Glimmer 10 aug 2026
- Muse Code 5 aug 2026
- Muse Spark 1.2 5 aug 2026 · inaktuell
- Muse Image 7 jul 2026
- Muse Spark 8 apr 2026 · inaktuell