Muse Spark 1.3
Metas senaste Muse Spark-version för kod och agenter, tränad för längre uppgifter, tydligare samarbete med användaren och att stämma av innan viktiga åtgärder.
- Språkmodell
- Kod
- Agenter
- Resonemang
- Bildförståelse
- Multimodal
 1 / 3
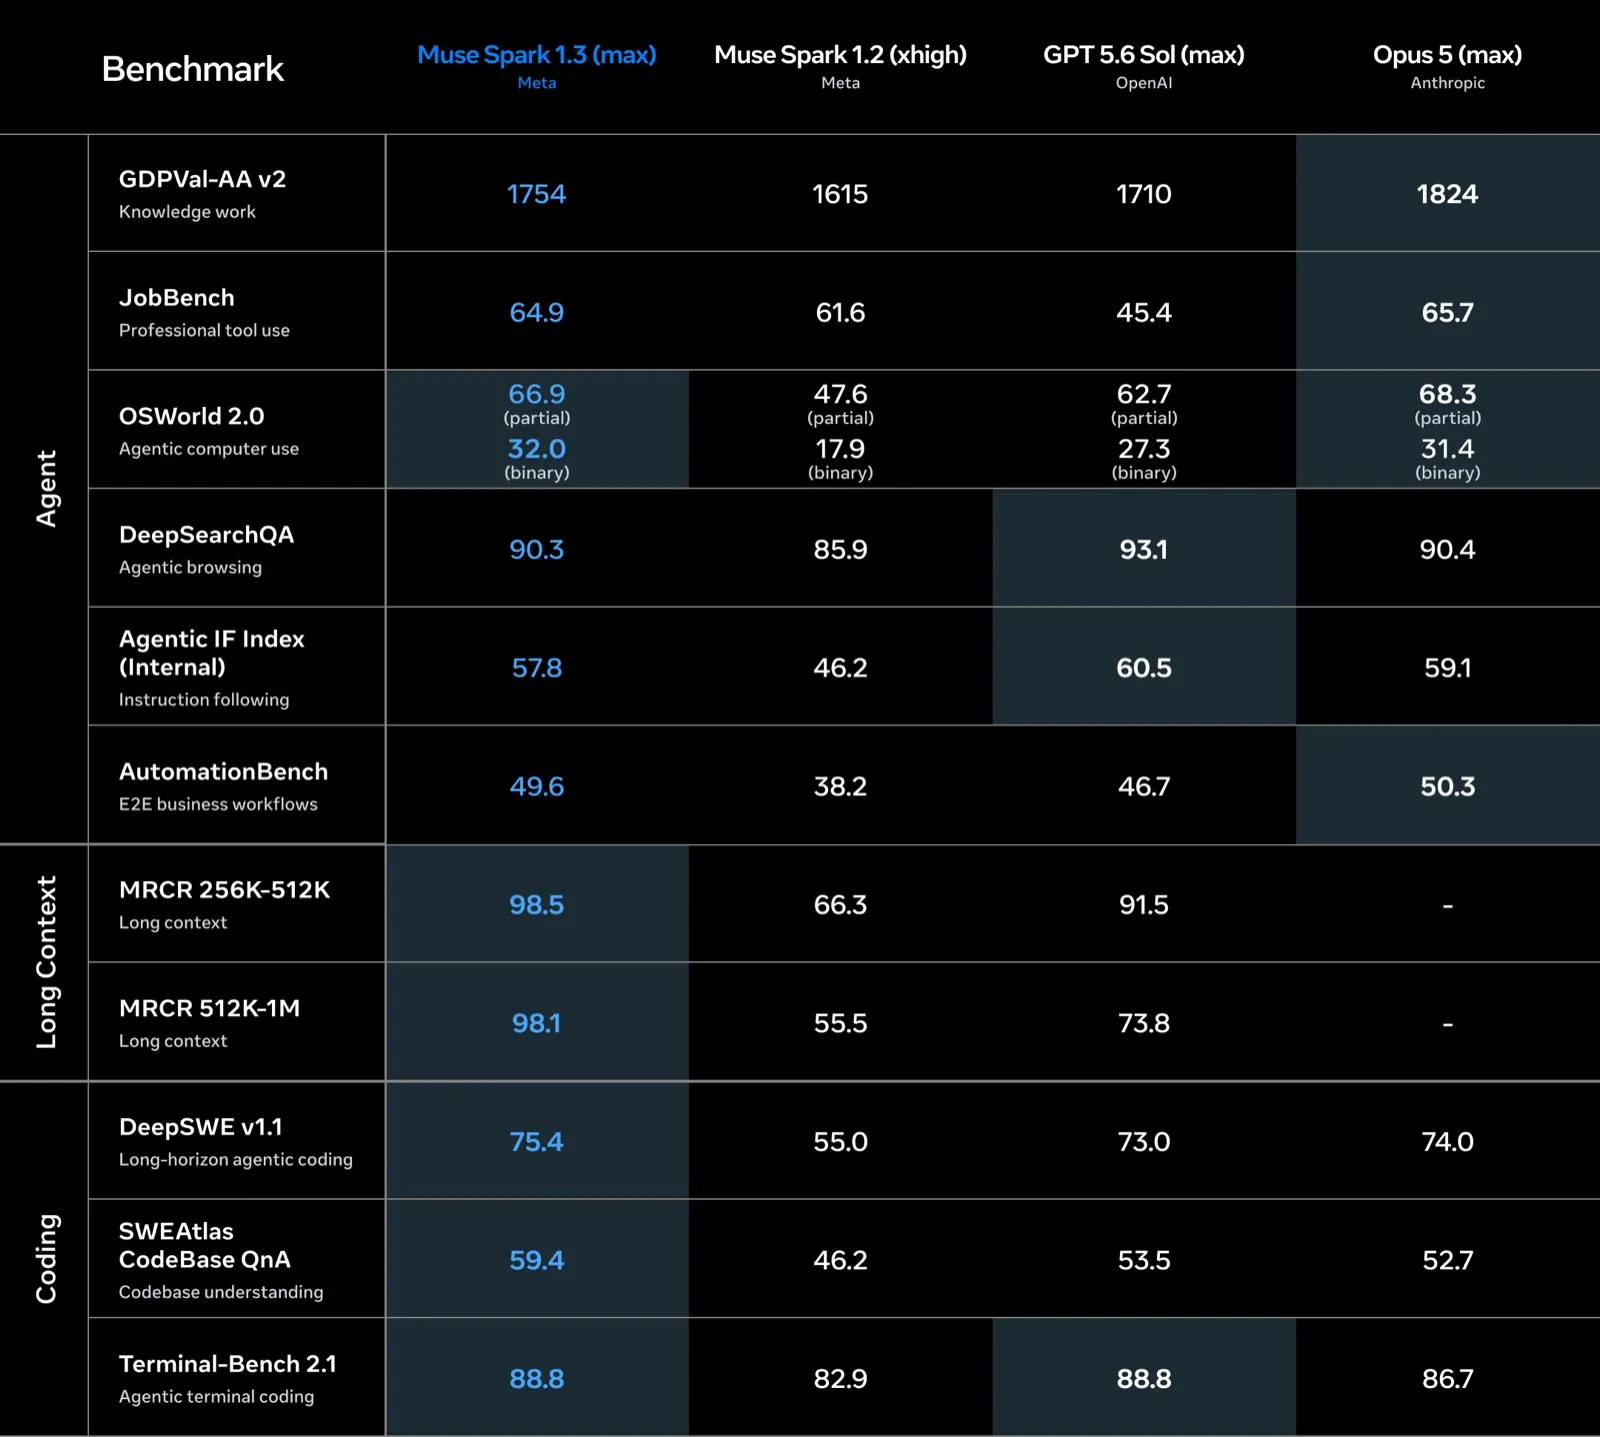
Metas jämförelse av Muse Spark 1.3 med Muse Spark 1.2, GPT 5.6 Sol och Opus 5 [1]
Om Muse Spark 1.3[1][2][3]
Muse Spark 1.3 är Metas uppföljare till Muse Spark 1.2 och bygger på erfarenheterna från hur utvecklare använt Muse Code och Meta Model API. Modellen är tränad för att hålla ihop längre arbetspass och flera uppgifter i samma tråd: den letar själv fram underlag från röriga och motsägelsefulla källor, rättar luckor i sin plan och håller reda på vad den lärt sig. Den ska också samarbeta tydligare, ställa följdfrågor när något är oklart, be om hjälp när den kör fast och fråga innan den gör något som får allvarliga följder. Meta skriver att den har bättre uppfattning om vad den kan och inte kan, i stället för att hitta på resultat.
För programmering är modellen tränad på fler långa kodningsuppgifter. Jämfört med 1.2 tar den färre onödiga steg och är mindre pratig, och i Metas egna jämförelser använde den ungefär 20 % färre verktygsanrop och 25 % färre tokens. Meta lyfter också fram bättre motståndskraft mot manipulerade indata och promptinjektioner. I bloggen visar Meta exempel på yrkesuppgifter som modellen löst, bland annat en rapport om flödessimulering för en flygplansvinge och en presentation i PowerPoint.
Enligt Metas tabell når Muse Spark 1.3 med max resonemang 88,8 % på Terminal-Bench 2.1, lika med GPT 5.6 Sol och före Claude Opus 5 (86,7 %), och 75,4 % på DeepSWE v1.1. Claude Opus 5 ligger före på bland annat GDPval-AA v2, JobBench och OSWorld 2.0. Modellen finns i Muse Code och via Meta Model API med 1 miljon tokens kontext, för 1,25 dollar per miljon tokens in och 4,25 dollar ut (0,10 respektive 0,20 dollar om Meta får använda datan). Meta har inte publicerat modellens storlek.
Det viktigaste[1][2]
- Enligt Meta cirka 20 % färre verktygsanrop och 25 % färre tokens än Muse Spark 1.2 i interna jämförelser.
- Enligt Meta 88,8 % på Terminal-Bench 2.1, lika med GPT 5.6 Sol och före Claude Opus 5 (86,7 %).
- I Metas tabell leder Claude Opus 5 på GDPval-AA v2, JobBench och OSWorld 2.0.
- Tränad att ställa följdfrågor och stämma av innan åtgärder som får allvarliga följder.
- Kontextfönster på 1 miljon tokens; 1,25 dollar per miljon tokens in och 4,25 dollar ut.
Källor
- [2]
- [3] GPT 6 Astra, Claude Fable 5.1, Qwen 3.8 0902, Gemini 3.8 Flash, Muse Spark 1.3, Atlas: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 6 sep 2026 Läst 25 okt 2026
- [1] Introducing Muse Spark 1.3 ↗Meta Officiell sida research.meta.aiPublicerad 2 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-06). [3]
Placeringar i topplistor
- Legal Research BenchMax-läge#1 · 55.29% ± 3.46
- OSWorld 2.0tankenivå max; uppgiftsversion v2.1#2 · 39.25% (delpoäng 69.56%)
- LMArena TextLäge: Max#10 · 1496 ± 5
- WebDev ArenaMax#16 · 1657 ± 8
- Terminal-Bench 4.0Muse Code, tankenivå xhigh#32 · 14.6% ± 2.9
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Muse Spark 1.2 5 aug 2026
Mer från Meta
- Muse Spark Open 15 okt 2026
- Muse Wonder 12 okt 2026
- GenIA 8 okt 2026
- Muse Voice Transcribe 1 sep 2026
- Muse Glimmer 10 aug 2026
- Muse Code 5 aug 2026
- Muse Spark 1.2 5 aug 2026 · inaktuell
- Muse Image 7 jul 2026
- Muse Spark 8 apr 2026 · inaktuell
- SAM 3.1 27 mar 2026