Muse Voice Transcribe
Metas första realtidsmodell för tal till text, som skriver ut tal medan det sägs, håller isär över 20 talare och klarar språkbyten mitt i meningen.
- Tal till text
 1 / 3
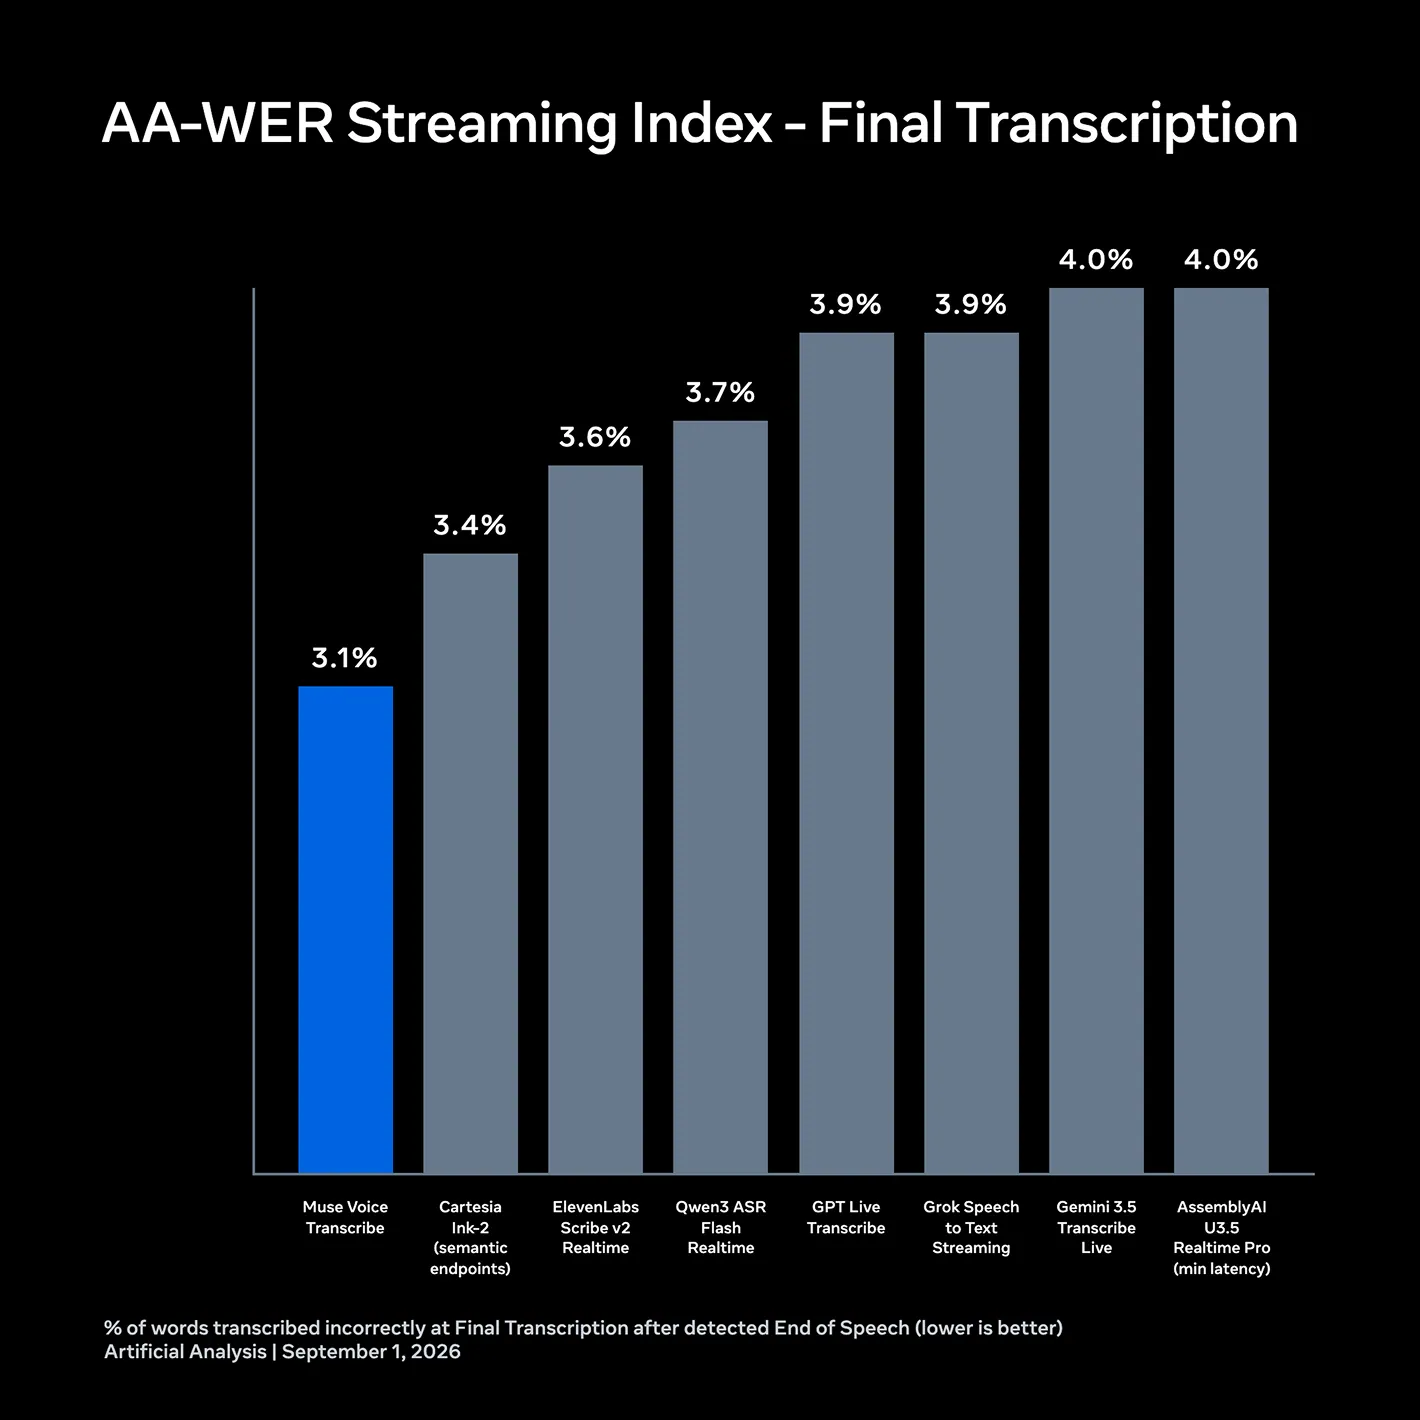
Andel felaktiga ord vid strömmande avskrift, enligt Meta [1]
Ljudexempel
Om Muse Voice Transcribe[1][2][3]
Muse Voice Transcribe lanserades den 1 september 2026 och är enligt Meta den första modellen för realtidsuppfattning av ljud från Meta Superintelligence Labs. Den gör tre saker samtidigt medan någon pratar: skriver ut talet (strömmande taligenkänning), avgör vem som säger vad (diarisering, för mer än 20 talare) och känner av när en talare är klar.
Modellen hör till Muse Spark-familjen. Ljudet delas upp i bitar på 80 millisekunder, och för varje bit bestämmer modellen själv om den ska lyssna vidare eller skriva ut nästa ord. Genom förstärkningsinlärning har den lärt sig att vänta längre på svåra ord och kortare på enkla, vilket Meta kallar adaptiv fördröjning. Den är tränad på över 70 språk, varav 25 är noggrant kontrollerade, hanterar byten mellan språk mitt i en mening och kan få hjälp med egna nyckelord och sammanhang. Den klarar också inspelningar på över en timme.
Enligt Meta låg den först hos Artificial Analysis för strömmande tal till text och på öppna diariseringstester den 1 september 2026, med 3,1 % felaktiga ord och en genomsnittlig diariseringsfelfrekvens på 17,5 %. Modellen ger bara text: den gör inte tal, ger inga tidsstämplar per ord och känner inte av känslor. Den finns som muse-voice-transcribe-1.0 via Meta Model API för 0,18 dollar per timme, och driver röstinmatningen i Meta AI för Mac och i Muse Code.
Det viktigaste[1][2]
- Strömmande tal till text, talaruppdelning för över 20 talare och slutdetektering i en och samma modell.
- Enligt Meta 3,1 % felaktiga ord i strömmande läge, lägst bland de jämförda systemen.
- Tränad på över 70 språk, varav 25 noggrant kontrollerade; klarar språkbyten mitt i meningen.
- Bestämmer själv hur länge den ska lyssna innan den skriver ut ett ord (adaptiv fördröjning).
- 0,18 dollar per timme ljud via Meta Model API.
Källor
- [2]
- [3]
- [1] Introducing Muse Voice Transcribe ↗Meta Officiell sida research.meta.aiPublicerad 1 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan som nyare version/produkt hittad vid genomgången av AI Search-nyheter. [1]
Placeringar i topplistor
- #31 · 6,30 %
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Meta
- Muse Spark Open 15 okt 2026
- Muse Wonder 12 okt 2026
- GenIA 8 okt 2026
- Muse Spark 1.3 2 sep 2026
- Muse Glimmer 10 aug 2026
- Muse Code 5 aug 2026
- Muse Spark 1.2 5 aug 2026 · inaktuell
- Muse Image 7 jul 2026
- Muse Spark 8 apr 2026 · inaktuell
- SAM 3.1 27 mar 2026