Muse Image
Metas bildmodell som tänker innan den ritar: den kan söka på webben, skriva kod och rätta sina egna bilder, och kostar en cent per bild via Metas API.
- Bildgenerering
- Bildredigering
- Agenter
- Multimodal
 1 / 6
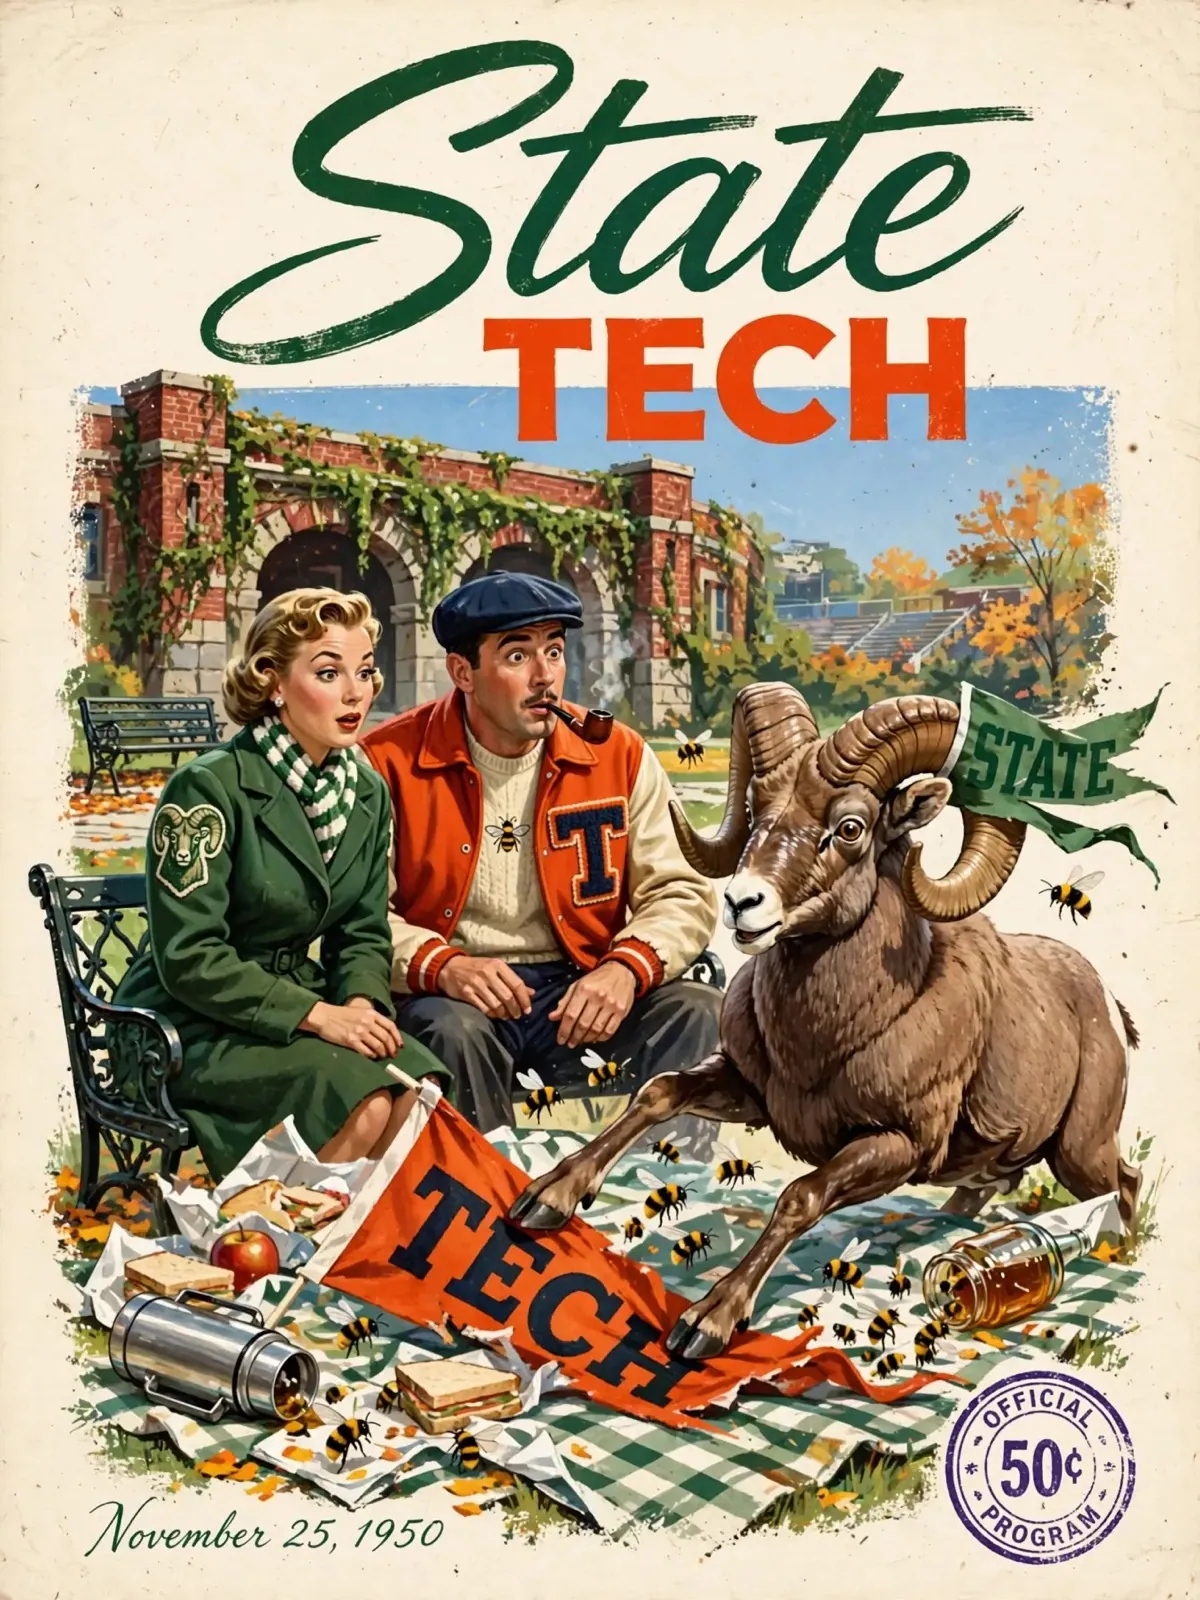
Exempelbild från Meta skapad med Muse Image: ett retroaffischomslag med text [1]
Om Muse Image[1][2][3]
Muse Image är den första bildmodellen från Meta Superintelligence Labs och lanserades den 7 juli 2026, samtidigt som Meta visade en förhandstitt på videomodellen Muse Video. En och samma modell både skapar bilder från text och redigerar befintliga bilder, och den kan kombinera personer, föremål, kläder, stilar och miljöer från flera referensbilder.
Meta beskriver modellen som agentisk. I stället för att göra om en text direkt till en bild planerar den först, söker på webben efter referenser och aktuella fakta, skriver och kör kod när något måste bli exakt (som diagram och QR-koder) och kontrollerar resultatet innan den lämnar ifrån sig bilden. Enligt Meta uppstod förmågan att rätta sina egna bilder under träningen med förstärkningsinlärning, och kvaliteten blir bättre ju mer tid den får att tänka. Vid redigering ska den bara ändra det man ber om och lämna resten orört.
Enligt Meta låg Muse Image tvåa på Arena-topplistorna för text till bild, redigering av en bild och redigering med flera bilder (5 juli 2026). Bilder som skapas i Meta AI-appen och på meta.ai får en osynlig vattenstämpel, Content Seal. Modellen finns i Meta AI-appen, på meta.ai, i Instagram Stories i USA och i WhatsApp i vissa länder. För utvecklare finns den som muse-image-1.0 via Meta Model API för 0,01 dollar per bild, och även via fal, Runway och OpenRouter. Meta har inte publicerat modellens storlek, och vikterna är inte öppna.
Det viktigaste[1][2][3]
- Planerar, söker på webben och kör kod innan den ritar, och rättar sina egna bilder.
- Skapar och redigerar bilder i samma modell, med flera referensbilder.
- Enligt Meta tvåa på Arena för text till bild, bildredigering och redigering med flera bilder (5 juli 2026).
- 0,01 dollar per bild via Meta Model API (muse-image-1.0).
- Bilder från Meta AI får en osynlig vattenstämpel, Content Seal.
Källor
- [2]
- [3]
- [1] Introducing Muse Image and Muse Video ↗Meta Officiell sida ai.meta.comPublicerad 7 jul 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan som nyare version/produkt hittad vid genomgången av AI Search-nyheter. [1]
Placeringar i topplistor
- #8 · 1127 ± 11
- #9 · 1274 ± 5
- #10 · 1398 ± 4
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Meta
- Muse Spark Open 15 okt 2026
- Muse Wonder 12 okt 2026
- GenIA 8 okt 2026
- Muse Spark 1.3 2 sep 2026
- Muse Voice Transcribe 1 sep 2026
- Muse Glimmer 10 aug 2026
- Muse Code 5 aug 2026
- Muse Spark 1.2 5 aug 2026 · inaktuell
- Muse Spark 8 apr 2026 · inaktuell
- SAM 3.1 27 mar 2026