CoInteract
Skapar realistiska videor av en person som hanterar en produkt, utifrån en bild på personen, en bild på produkten och ljud.
- Videogenerering
- Animation & rörelse
 1 / 5
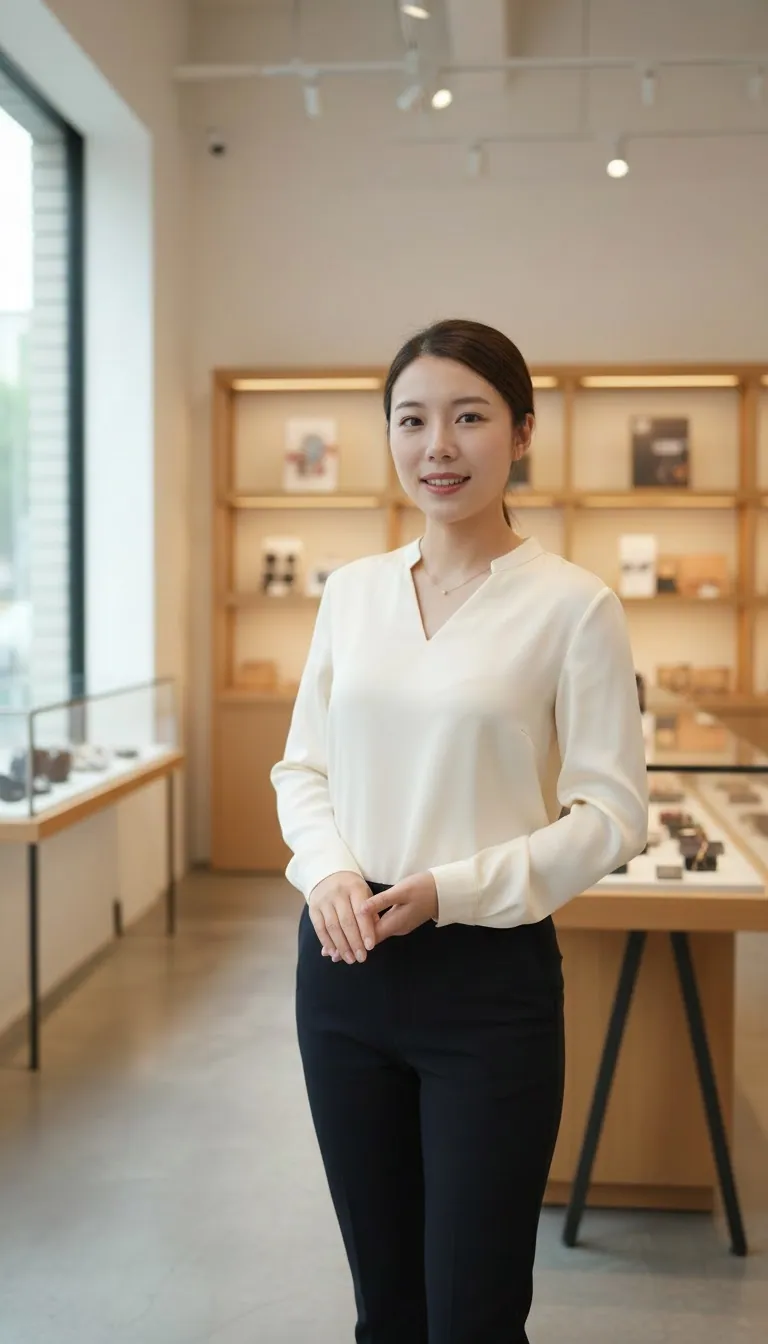
Indata: bild på personen [1]
Om CoInteract[1][2][3][5]
CoInteract är en videomodell för att skapa videor där en människa interagerar med ett föremål, till exempel visar upp en handväska, en bok eller en tekanna. Man ger den en bild på personen, en bild på produkten, ljud och en textbeskrivning. Tanken är användning inom e-handel, reklam och virtuell marknadsföring, där vanliga videomodeller ofta ger händer som går igenom föremål eller föremål som ändrar form.
Modellen genererar två strömmar samtidigt i samma nätverk: själva färgvideon och en ström med rumslig struktur för hur människa och föremål samspelar. Strukturen hjälper till att hålla kontakten mellan händer och föremål trovärdig. Dessutom finns en blandning av experter som är specialiserade på olika delar av kroppen, med separata experter för huvud, händer och resten.
CoInteract bygger på Alibabas videomodell Wan2.2-S2V-14B. Koden och vikterna släpptes 27 april 2026, och i maj kom träningsguide och en version som styrs med kroppspositioner. Projektsidan visar också virtuell provning av kläder som användningsområde.
Arbetet kommer från Tsinghua University och Alibaba Group (Taobao Live Tech).
Det viktigaste[1][3]
- Tar en bild på en person, en bild på en produkt och ljud, och skapar en video där personen hanterar produkten.
- Genererar färgvideo och en struktur för samspelet mellan människa och föremål samtidigt, för trovärdig kontakt mellan händer och föremål.
- Särskilda experter i modellen för huvud, händer och resten av bilden.
- Bygger på Wan2.2-S2V-14B; kod, vikter och träningskod är släppta under Apache 2.0.
- Kan även användas för virtuell provning av kläder.
Källor
- [1] CoInteract: Physically-Consistent Human-Object Interaction Video Synthesis via Spatially-Structured Co-Generation ↗Tsinghua University och Alibaba Group (Taobao Live Tech) Officiell sida xinxiaozhe12345.github.ioPublicerad okänt datum Läst 25 okt 2026
- [4] georgexin/cointeract ↗Hugging Face (georgexin) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Deepseek V4, Kimi K2.6, MiMo v2.5, GPT 5.5, GPT Images 2, Qwen 3.6, HY3, Vision Banana: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 26 apr 2026 Läst 25 okt 2026
- [2] CoInteract: Physically-Consistent Human-Object Interaction Video Synthesis via Spatially-Structured Co-Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 21 apr 2026 Läst 25 okt 2026
- [3] CoInteract: Spatially-Structured Co-Generation for Interactive Human-Object Video Synthesis ↗Xiangyang Luo (GitHub) Officiell sida github.comPublicerad 21 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-26). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –