Qwen3.8-27B
En kompakt öppen modell med 27 miljarder parametrar som förstår text, bilder och video, med fri Apache 2.0-licens och fokus på kod och kontorsarbete.
- Språkmodell
- Resonemang
- Kod
- Agenter
- Bildförståelse
- Multimodal
- Kör lokalt
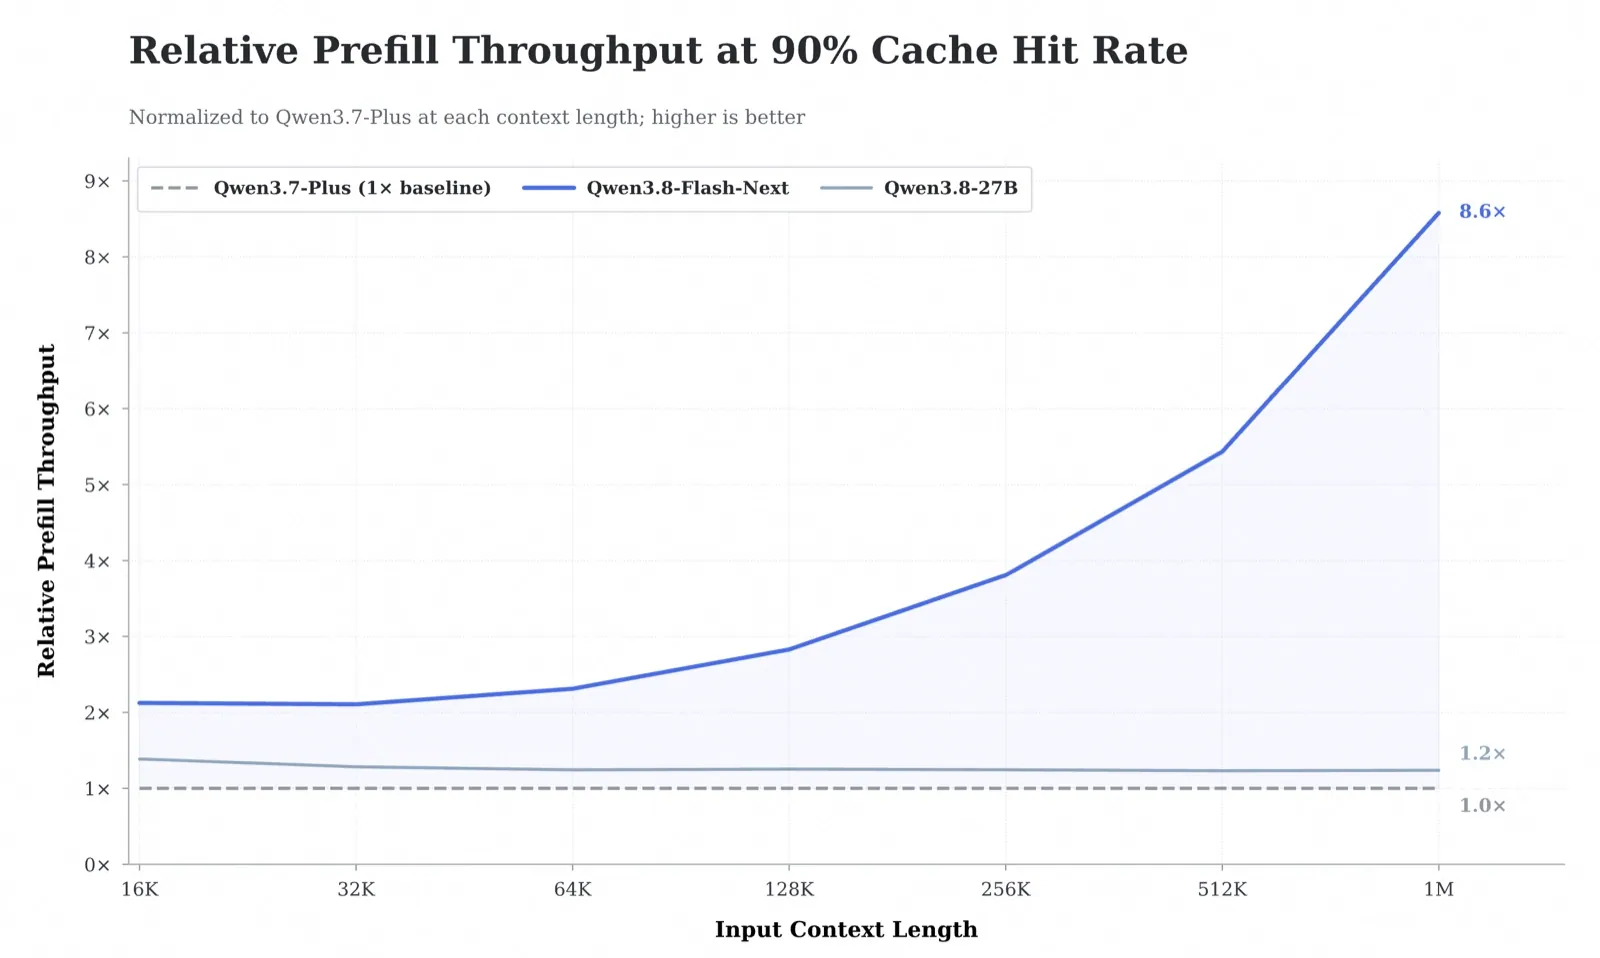
Från Qwen3.8-Flash-Next-lanseringen: relativ hastighet vid långa texter, där Qwen3.8-27B ligger kring 1,2 gånger Qwen3.7-Plus [3]
Om Qwen3.8-27B[1][2][4]
Qwen3.8-27B är den mindre, lättare medlemmen i Alibabas Qwen3.8-familj. Till skillnad från de största Qwen-modellerna är den "tät" (dense), alltså används alla 27 miljarder parametrar hela tiden, och den är byggd för att vara enkel att köra själv. Den är en inbyggd syn- och språkmodell som förstår både bilder och video, från diagram och dokument till videor som är en timme långa.
Enligt Qwen bygger den vidare på Qwen3.6-27B med stora förbättringar inom kodning, kontorsarbete och långa agentuppgifter. Qwen redovisar till exempel 73,0 på Terminal Bench 2.1 (mot 63,4 för Qwen3.6-27B), 61,7 på SWE-bench Pro (mot 53,5) och 84,3 på datoranvändningstestet OSWorld-Verified (mot 63,9). Modellen tänker som standard innan den svarar, men tankeläget kan stängas av per förfrågan, och tänkandets djup kan styras.
Kontextfönstret är 262 144 tokens och kan utökas till en miljon. Vikterna ligger på Hugging Face under Apache 2.0-licensen, som tillåter fri kommersiell användning, och det finns även en FP8-version som tar mindre minne. Modellen finns också som tjänst på QwenCloud med en miljon tokens kontext och inbyggda verktyg, för 0,5 dollar per miljon inmatade tokens och 3 dollar per miljon utmatade.
Det viktigaste[1][2]
- Öppna vikter under Apache 2.0, så den får användas kommersiellt utan särskilda villkor.
- Förstår text, bilder och video i en och samma modell.
- Enligt Qwen: 73,0 på Terminal Bench 2.1 och 61,7 på SWE-bench Pro, klart bättre än Qwen3.6-27B (63,4 och 53,5).
- Enligt Qwen: 84,3 på OSWorld-Verified, där modellen styr en dator själv.
- Tankeläget kan slås av per förfrågan för snabbare svar.
- Via QwenCloud kostar den 0,5 dollar per miljon inmatade och 3 dollar per miljon utmatade tokens.
Källor
- [2] Qwen3.8-27B - QwenCloud ↗QwenCloud (Alibaba) Officiell sida qwencloud.comPublicerad okänt datum Läst 25 okt 2026
- [3] Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost-Efficiency ↗Qwen (Alibaba) Officiell sida qwen.aiPublicerad 26 aug 2026 Läst 25 okt 2026
- [4] Deepseek v4 0813, Qwen 3.8 27B, GLM 5.3, Grok 4.6, LTX 2.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 16 aug 2026 Läst 25 okt 2026
- [1] Qwen/Qwen3.8-27B ↗Qwen (Hugging Face) Modellkort huggingface.coPublicerad 5 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-16). [4]
Placeringar i topplistor
- EuroEval – svenska (generativa modeller)öppna vikter#5 · 1.57 ± 0.21
- GDPval-AA v2.1xhigh#22 · 1419 (1399–1439)
- Artificial Analysis Intelligence IndexLäge: xhigh#32 · 34
- #32 · 1591 ± 6
- #41 · 83.85% ± 1.98
- #44 · 36.06% ± 3.34
- #72 · 82.43% ± 0.47
- #102 · 1437 ± 5
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Qwen3.6-27B 22 apr 2026
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –