Qwen3.8-Flash-Next
En billig och snabb öppen Qwen-modell som förhandsvisar arkitekturen i kommande Qwen4: 125 miljarder parametrar men bara 6 miljarder aktiva per token.
- Språkmodell
- Kod
- Agenter
- Bildförståelse
- Multimodal
 1 / 3
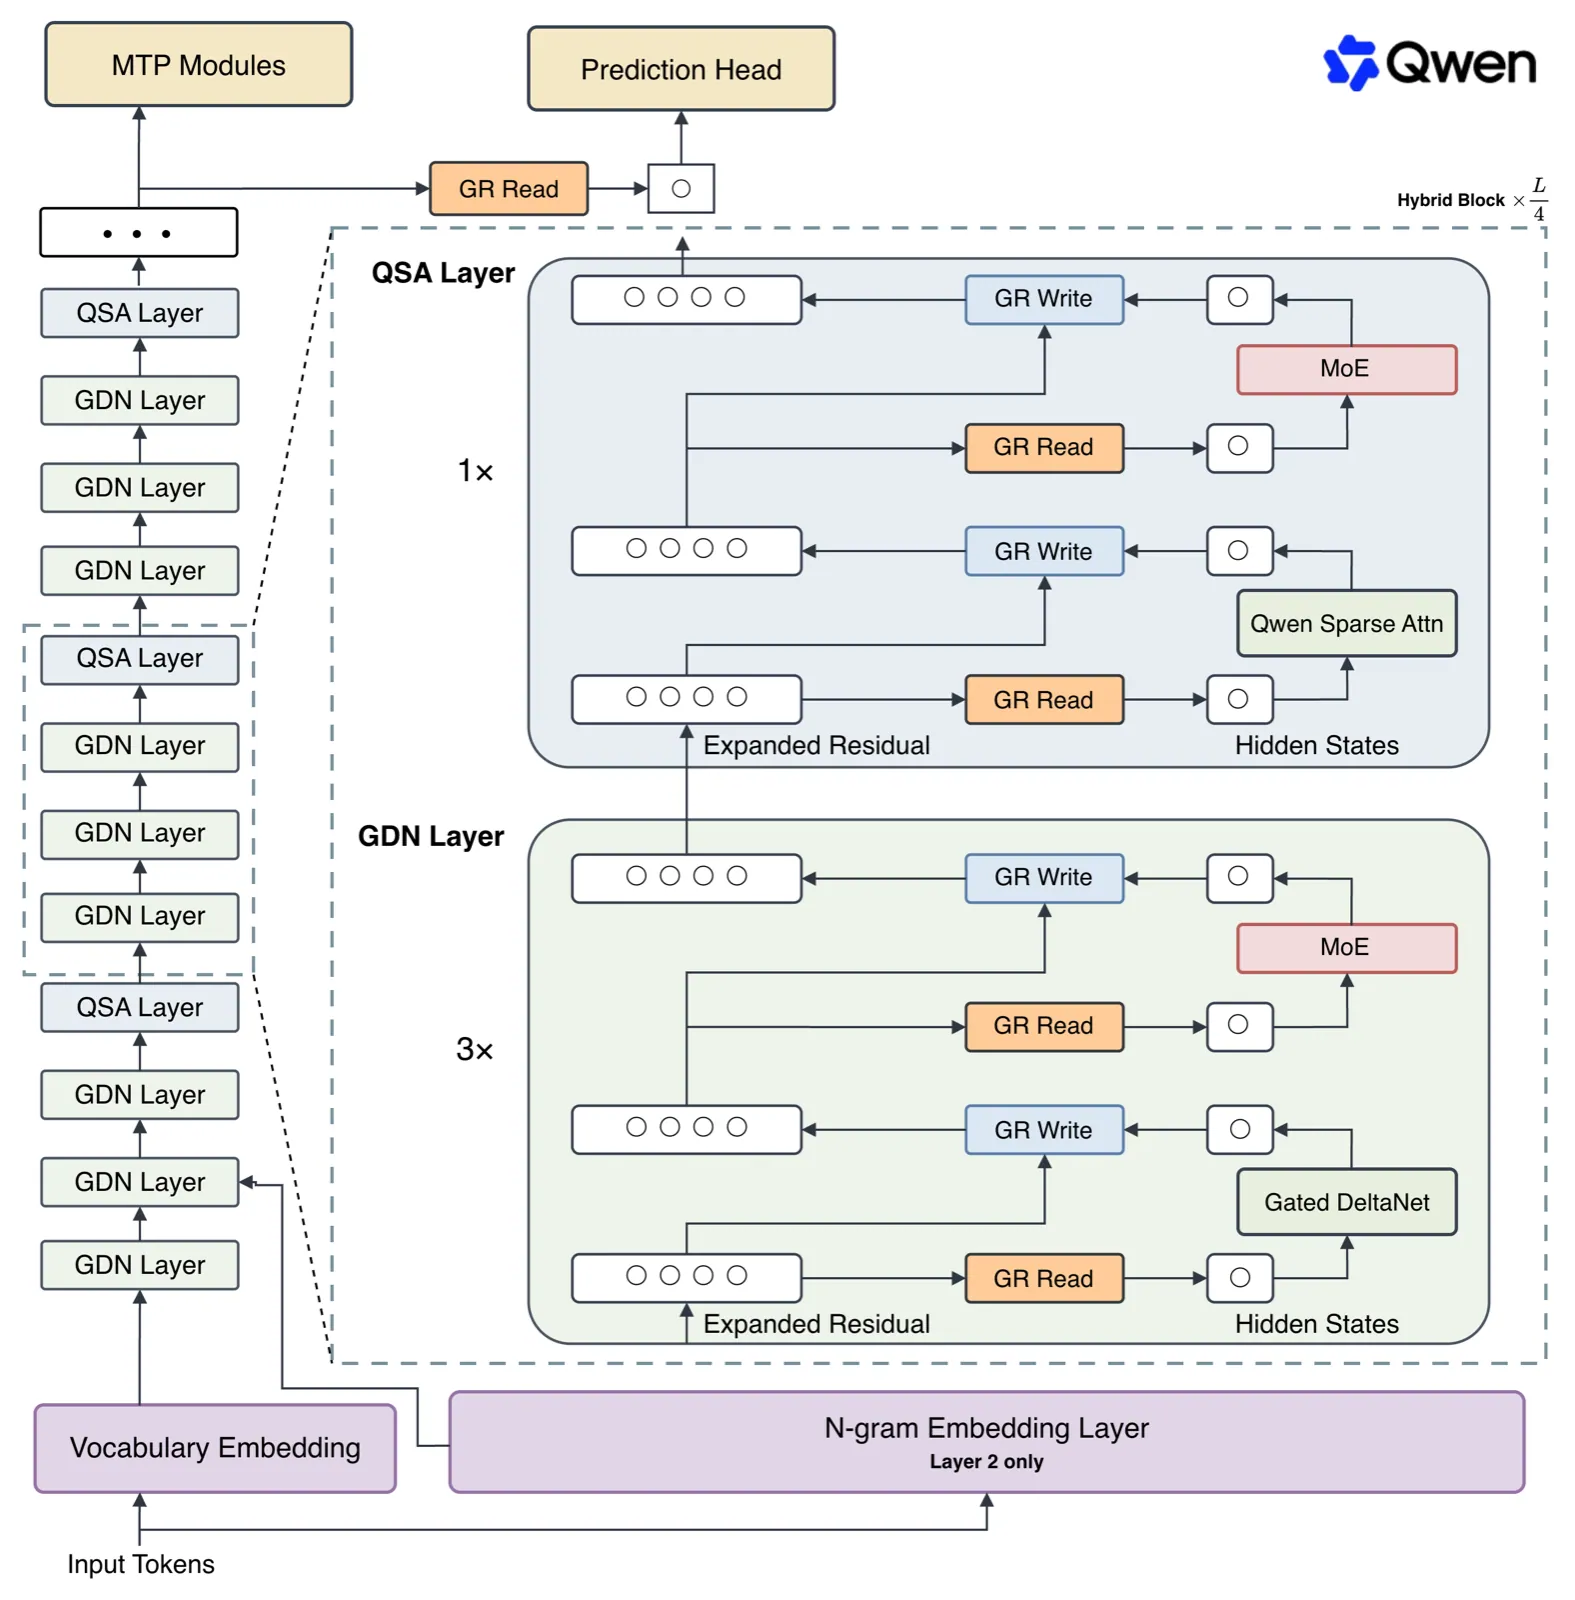
Arkitekturen: Gated DeltaNet, Qwen Sparse Attention, Gated Residual och N-gram Embedding [2]
Om Qwen3.8-Flash-Next[1][2][4]
Qwen3.8-Flash-Next är en multimodal MoE-modell som Alibaba släppt med öppna vikter som en tidig förhandsvisning av arkitekturen i nästa stora generation, Qwen4. Den fyller samma roll som Qwen3-Next gjorde inför Qwen3.5: Qwen släpper de nya byggstenarna tidigt så att andra kan granska dem innan hela Qwen4-familjen byggs på dem.
Nyheterna finns på fyra områden. Uppmärksamheten blandar Gated DeltaNet, som komprimerar historiken, med Qwen Sparse Attention (QSA), som bara tittar på de viktigaste delarna av en lång text och därför blir mycket billigare vid långa sammanhang. Gated Residual delar upp informationsflödet mellan lagren i fyra parallella spår. N-gram Embedding lägger till 51 miljarder extra parametrar som slås upp i en tabell utifrån de senaste orden och nästan inte kostar någon beräkning. Träningen använder optimeraren Muon.
Huvudmodellen har 125 miljarder parametrar, varav 6 miljarder är aktiva per token. Enligt Qwen kostade träningen ungefär en niondel av Qwen3.7-Plus, men modellen är ändå bättre på kod och kontorsuppgifter. Vid en miljon tokens och hög cacheträff ska den läsa in text 8,6 gånger snabbare än Qwen3.7-Plus. Kontextfönstret är 262 144 tokens och kan utökas till en miljon.
Vikterna finns på Hugging Face och ModelScope under Qwen Community License 1.0. Den tillåter kommersiell användning, men företag som säljer AI-modeller som tjänst eller AI-arbetsassistenter (som kodassistenter) måste skaffa en separat licens. Den färdiga produktversionen heter Qwen3.8-Flash på QwenCloud och kostar 0,15 dollar per miljon inmatade och 0,47 dollar per miljon utmatade tokens.
Det viktigaste[1]
- Förhandsvisar arkitekturen som Qwen4 ska byggas på.
- Bara 6 miljarder av 125 miljarder parametrar används per token, vilket gör den billig att köra.
- Enligt Qwen kostade träningen ungefär en niondel av Qwen3.7-Plus, med bättre resultat på kod och kontorsarbete.
- Enligt Qwen: 62,5 på SWE-bench Pro och 73,9 på CoWorkBench, före både Qwen3.8-27B och Qwen3.7-Plus.
- Enligt Qwen läser den in text 8,6 gånger snabbare än Qwen3.7-Plus vid en miljon tokens.
- Som tjänst (Qwen3.8-Flash) kostar den 0,15 dollar per miljon inmatade och 0,47 dollar per miljon utmatade tokens.
Källor
- [3] Qwen3.8-Flash-Next tech report ↗Qwen (GitHub) Forskningsartikel github.comPublicerad okänt datum Läst 25 okt 2026
- [4] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [1] Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost-Efficiency ↗Qwen (Alibaba) Officiell sida qwen.aiPublicerad 26 aug 2026 Läst 25 okt 2026
- [2] Qwen/Qwen3.8-Flash-Next ↗Qwen (Hugging Face) Modellkort huggingface.coPublicerad 24 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [4]
Placeringar i topplistor
- #22 · 1629 ± 8
- #23 · 40
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –