Qwen3.8-Omni-Flash
Alibabas nya allsidiga modell som tar in text, bild, ljud och video och själv planerar och utför uppgifter som att klippa video, sammanfatta möten och skapa musikvideor.
- Multimodal
- Agenter
- Bildförståelse
- Tal till text
- Röstassistent
 1 / 6
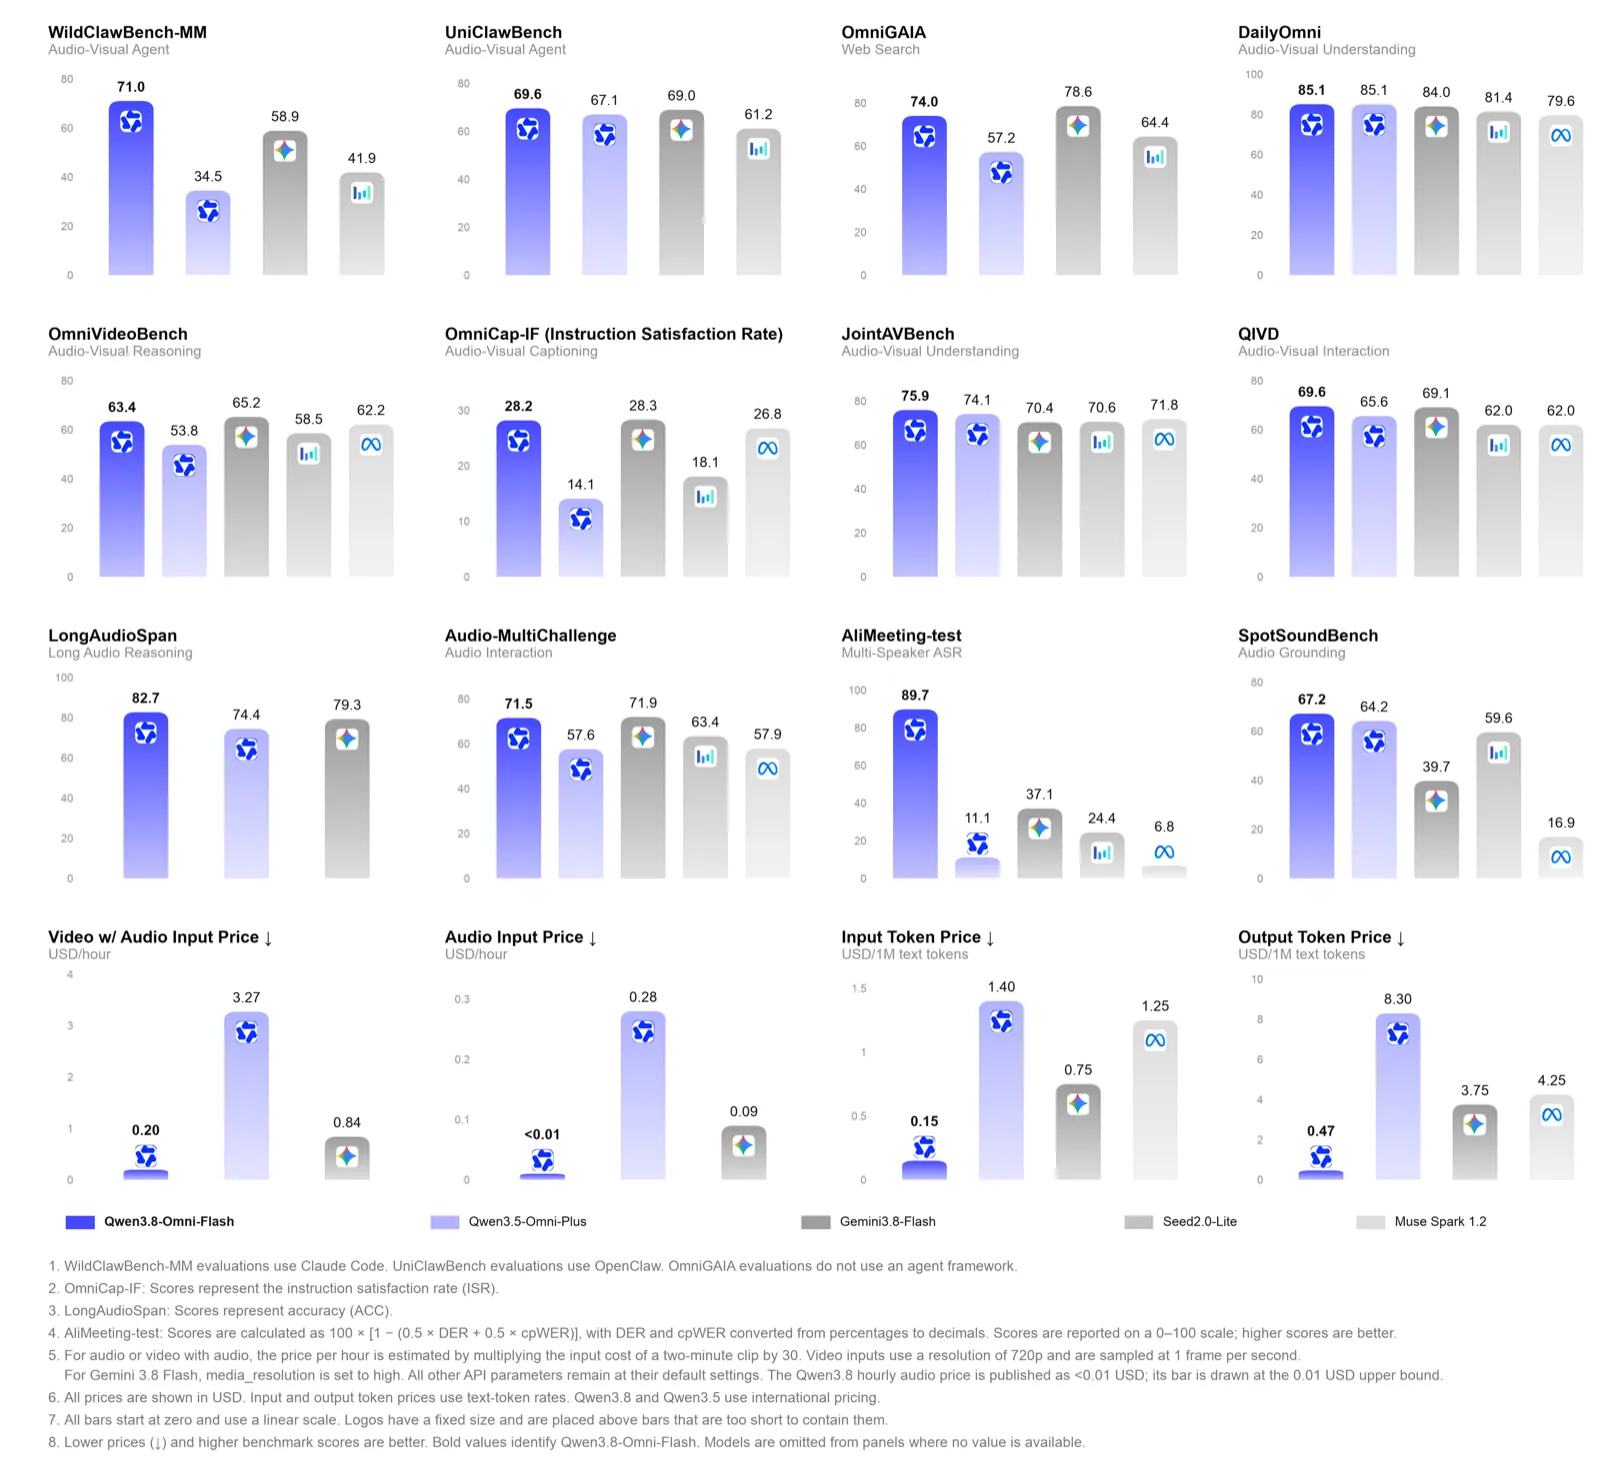
Qwens jämförelse mot Qwen3.5-Omni-Plus, Gemini 3.8 Flash, Seed 2.0 Lite och Muse Spark 1.2, inklusive priser [1]
Om Qwen3.8-Omni-Flash[1][2][3]
Qwen3.8-Omni-Flash är en så kallad omnimodal modell: den förstår text, bilder, ljud och video i en och samma modell och har ett kontextfönster på 1 miljon tokens. Målet med den här versionen är att gå från att bara förstå innehåll till att planera uppgifter, använda verktyg och leverera färdiga resultat, till exempel videoredigering, musikvideor, filmkommentarer, översättning och dubbning av video, mötessammanfattningar och samtal i realtid.
Enligt Qwen förbättras medelresultatet över 29 tester med mer än 25 procent jämfört med Qwen3.5-Omni-Plus, samtidigt som API-priset per timme ljud sjunker med över 98 procent och per timme video med ljud med över 93 procent. Qwen uppger att ljud- och videoförståelsen ligger nära Gemini 3.8 Flash och att den samlade ljudförmågan är bättre. Modellen kan hantera upp till en timme video med ljud och känna igen vem som talar; på mötestestet AliMeeting sjönk felen kraftigt.
För långa videor kan modellen själv välja vilka delar den behöver titta och lyssna på; enligt Qwen höjer det träffsäkerheten på OmniVideoBench från 63,4 till 67,8 och halverar nästan tokenåtgången. Till modellen hör verktygen Qwen-MM-Plugins och den öppna körmiljön Qwen-Live Harness, och en separat variant, Qwen3.8-Omni-Flash-Realtime, är gjord för direktsända samtal med ljud och bild. Modellen används via API och i Qwen Studio; några nedladdningsbara vikter nämns inte.
Det viktigaste[1]
- Tar in text, bild, ljud och video med 1 miljon tokens kontext.
- Enligt Qwen över 25 procent bättre i snitt på 29 tester än Qwen3.5-Omni-Plus.
- Enligt Qwen sjunker priset per timme ljud med över 98 procent och per timme video med över 93 procent.
- Kan själv välja vilka delar av en lång video den tittar på, vilket enligt Qwen ger högre träffsäkerhet med nästan hälften så många tokens.
- Hanterar upp till en timmes möte och kan sedan skriva protokoll, hitta uppgifter och skicka mejl via verktyg.
- Realtidsvarianten Qwen3.8-Omni-Flash-Realtime är gjord för direktsända samtal med ljud och bild.
Källor
- [2]
- [3] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [1] Qwen3.8-Omni-Flash: Omni Senses. Agentic Delivery. ↗Qwen (Alibaba) Officiell sida qwen.aiPublicerad 18 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-20). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Qwen3.5-Omni 29 mar 2026
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –