Qwen3-Embedding
Alibabas öppna familj av embeddingmodeller i tre storlekar (0,6B, 4B och 8B) för sökning och dokumenthämtning på över 100 språk, som ligger i toppen av MTEB:s skandinaviska topplista.
- Sök & kunskap
- Kör lokalt
 1 / 2
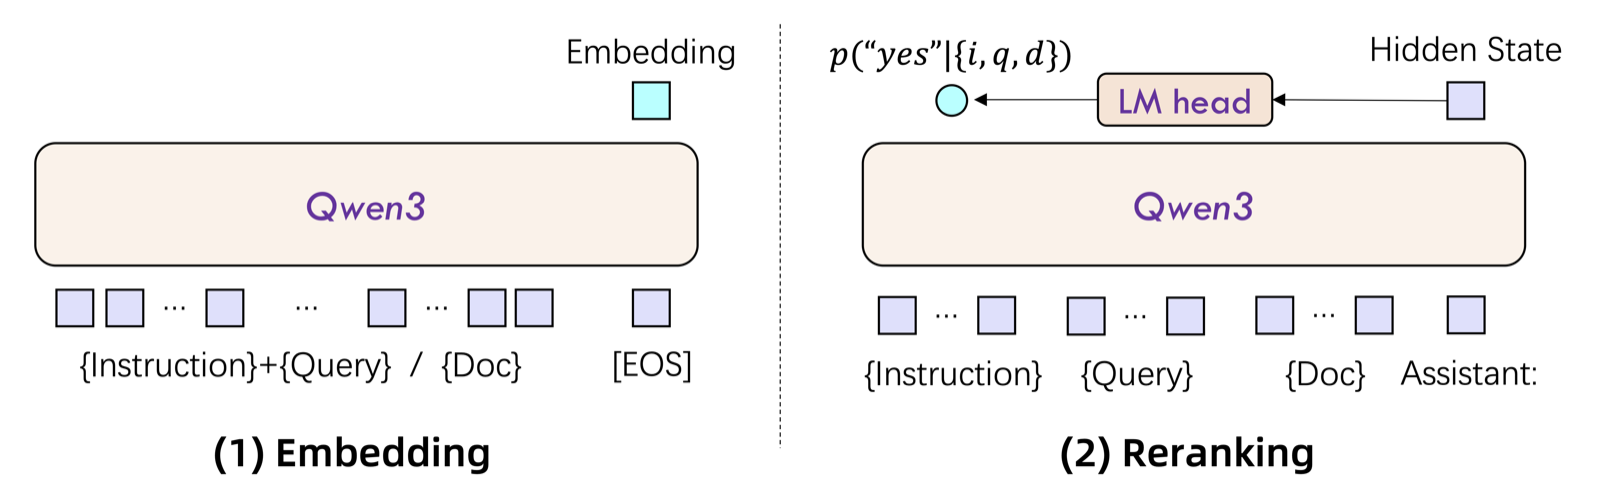
Arkitekturen: embeddingmodell (en text in) och omrankningsmodell (textpar in) [3]
Om Qwen3-Embedding[1][2][3][4]
Qwen3-Embedding är en serie embeddingmodeller från Alibabas Qwen-team, släppt den 5 juni 2025. En embeddingmodell gör om text till en lista med tal så att texter med liknande innehåll hamnar nära varandra. Det är tekniken bakom sökfunktioner som hittar rätt dokument även när orden skiljer sig, och bakom AI-assistenter som slår upp svar i egna dokument. Serien bygger på språkmodellen Qwen3 och finns i tre storlekar: 0,6, 4 och 8 miljarder parametrar. Samtidigt släpptes motsvarande omrankningsmodeller, Qwen3-Reranker, som sorterar en lista sökträffar efter hur väl de matchar frågan.
Modellerna stödjer över 100 språk, inklusive programspråk, och kan läsa 32 000 tokens. Den största ger vektorer med upp till 4 096 dimensioner, men man kan själv välja en mindre storlek (från 32) för att spara lagring. Man kan också ge en instruktion som beskriver uppgiften, vilket enligt Qwen brukar förbättra resultatet med 1–5 %. Träningen skedde i tre steg: förträning på stora mängder svagt märkta textpar som Qwen3 själv genererat, finjustering på högkvalitativ data och till sist sammanslagning av flera modellversioner.
Vid lanseringen låg 8B-modellen etta på MTEB:s flerspråkiga topplista med 70,58 poäng. Den har sedan passerats där, men den 25 oktober 2026 låg Qwen3-Embedding-8B tvåa och 4B femma på MTEB:s skandinaviska topplista, som testar svenska, danska och norska. Alla modeller är öppna under Apache 2.0-licensen och finns på Hugging Face och ModelScope.
Det viktigaste[1][2][4]
- Tre storlekar: 0,6B, 4B och 8B, plus omrankningsmodeller i samma storlekar.
- Över 100 språk inklusive programspråk, 32 000 tokens kontext och valbar vektorstorlek upp till 4 096.
- Vid lanseringen etta på MTEB:s flerspråkiga topplista med 70,58 poäng, enligt Qwen.
- Den 25 oktober 2026 tvåa (8B, 70,43) och femma (4B) på MTEB:s skandinaviska topplista.
- Öppna vikter under Apache 2.0.
Källor
- [4] Scandinavian · MTEB Leaderboard ↗MTEB Topplista mteb-leaderboard.hf.spacePublicerad okänt datum Läst 25 okt 2026
- [1] Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models ↗Qwen (Alibaba) Officiell sida qwenlm.github.ioPublicerad 5 jun 2025 Läst 25 okt 2026
- [3] Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models ↗arXiv (Qwen-teamet) Forskningsartikel arxiv.orgPublicerad 5 jun 2025 Läst 25 okt 2026
- [2] Qwen/Qwen3-Embedding-8B ↗Qwen (Hugging Face) Modellkort huggingface.coPublicerad 3 jun 2025 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan eftersom den finns med i topplistorna. [1]
Placeringar i topplistor
- #2 · 70.43
- MTEB(Multilingual, v2) – Massive Text Embedding BenchmarkQwen/Qwen3-Embedding-8B#4 · 70.58
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Fun-Realtime-ASR –