Wan 2.7
Alibabas videomodell från april 2026 som gör filmklipp med ljud från text, bilder eller referenser och kan redigera befintlig video med vanliga instruktioner.
- Videogenerering
- Multimodal
 1 / 4
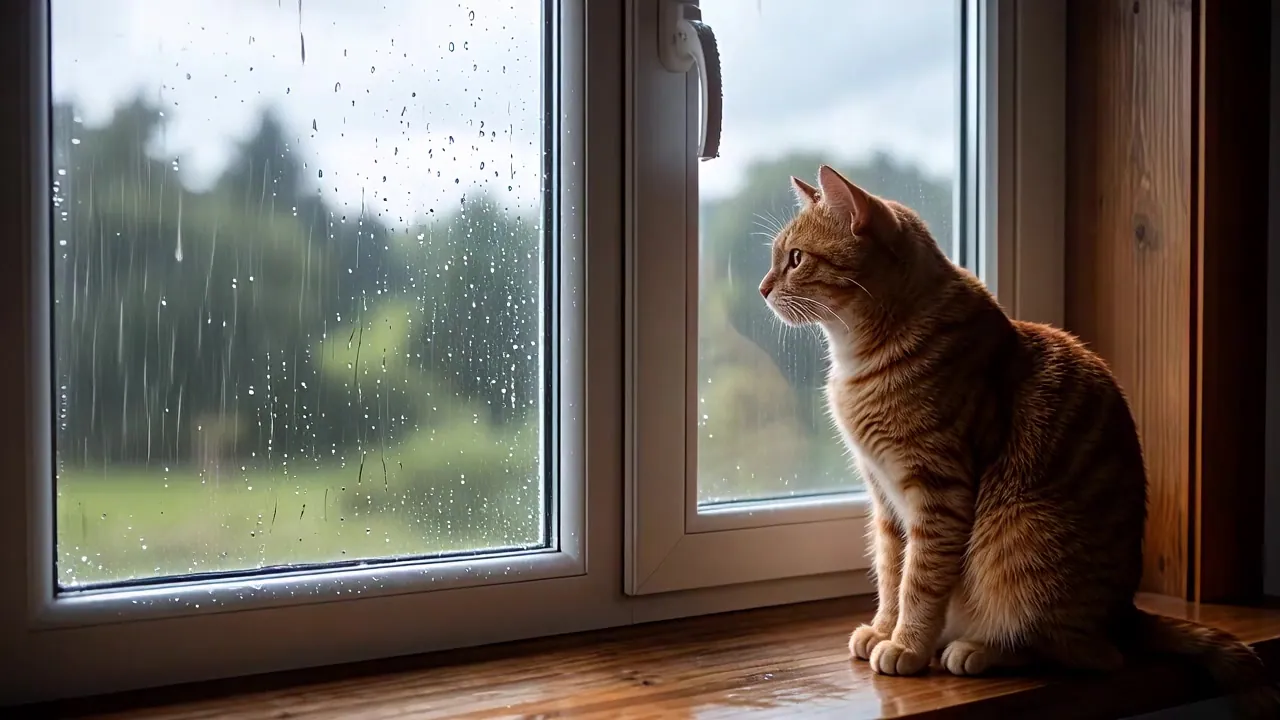
Bildruta ur ett exempel från Replicate: "A cat sitting on a windowsill watching rain fall outside" [2]
Om Wan 2.7[1][3][4][6]
Wan 2.7 är en serie AI-modeller från Alibaba för att skapa och redigera video. Serien består av flera delar: wan2.7-t2v gör video från text, wan2.7-i2v gör video från en bild (första bildruta, första och sista bildruta, förlängning av en befintlig video eller ljudstyrd video), wan2.7-r2v gör video utifrån referensbilder och referensvideor med flera karaktärer, och wan2.7-videoedit redigerar video med textinstruktioner, till exempel för stilbyte eller för att kopiera effekter och kamerarörelser.
Klippen blir 2 till 15 sekunder långa (2 till 10 sekunder för referens- och redigeringsvarianterna) i 720p eller 1080p med 30 bilder per sekund, och ljudet genereras i takt med bilden. Text-till-video-modellen kan också berätta i flera klipp (multi-shot). Enligt Alibabas prislista kostar text-till-video i Peking-regionen 0,6 yuan per sekund i 720p och 1 yuan per sekund i 1080p.
Wan 2.7 används via Alibaba Clouds API och via tjänster som Replicate. Till skillnad från äldre Wan-versioner finns inga vikter att ladda ner; den nyaste Wan-videomodellen på Hugging Face är Wan 2.2. I augusti 2026 kom efterföljaren Wan 3.0, som Alibaba nu rekommenderar för text- och bild-till-video. Wan 2.7:s redigeringsmodell rekommenderas dock fortfarande för att kopiera effekter och kamerarörelser.
Det viktigaste[1][5]
- Fyra delar: text till video, bild till video, referens till video och videoredigering.
- Klipp på 2–15 sekunder i 720p eller 1080p med 30 bilder per sekund och ljud i takt med bilden.
- Kan redigera befintlig video med textinstruktioner och kopiera effekter och kamerarörelser.
- Inga nedladdningsbara vikter; används via API.
- Ersatt av Wan 3.0 i augusti 2026, som klarar upp till 30 sekunder.
Källor
- [1] Video generation and editing - Alibaba Cloud Model Studio ↗Alibaba Cloud Officiell sida alibabacloud.comPublicerad okänt datum Läst 25 okt 2026
- [2] wan-video/wan-2.7-t2v examples ↗Replicate Artikel replicate.comPublicerad okänt datum Läst 25 okt 2026
- [3] Wan-AI ↗Wan-AI (Hugging Face) Officiell sida huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [4] Changelog - Qwen Cloud ↗QwenCloud (Alibaba) Officiell sida qwencloud.comPublicerad okänt datum Läst 25 okt 2026
- [5] Wan AI: Leading AI Video Generation Model ↗Wan (Alibaba) Officiell sida wan.videoPublicerad okänt datum Läst 25 okt 2026
- [6] Gemma 4, Claude Code leak, Qwen 3.6, Wan 2.7, OmniVoice, DreamLite, GLM-5V: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 5 apr 2026 Läst 25 okt 2026
Historik
Placeringar i topplistor
- #11 · 1428 ± 5
- #15 · 1037 ± 15
- #20 · 1337 ± 7
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –