Qwen3.6-35B-A3B
En öppen MoE-modell med 35 miljarder parametrar där bara 3 miljarder används åt gången, som enligt Qwen kodar nästan lika bra som mycket större modeller och också förstår bilder och video.
- Språkmodell
- Kod
- Agenter
- Bildförståelse
- Multimodal
- Kör lokalt
 1 / 2
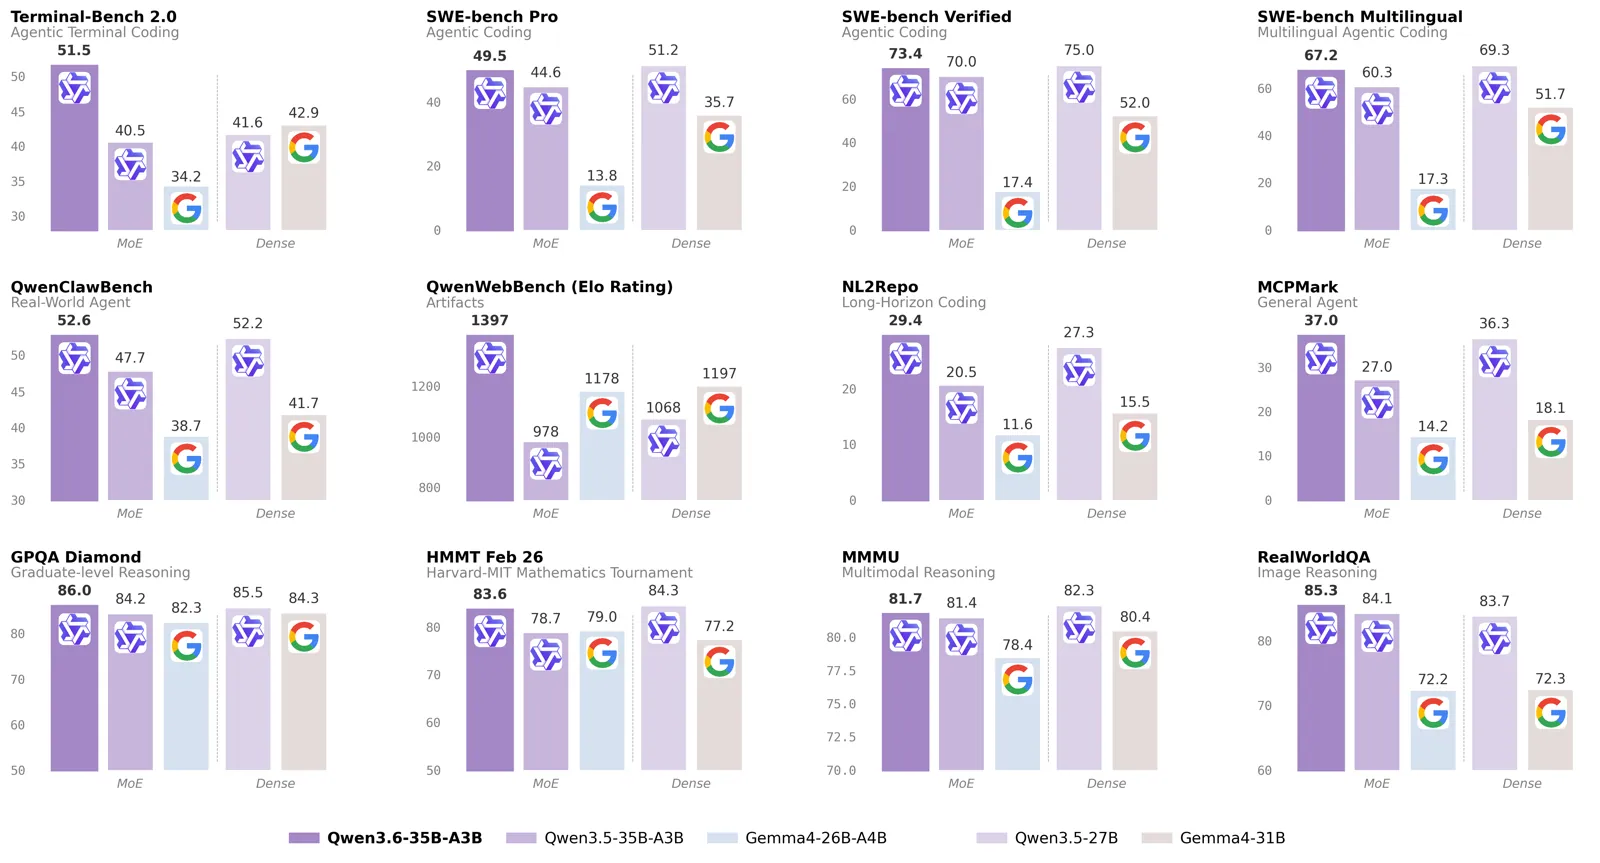
Qwens jämförelse av Qwen3.6-35B-A3B mot modeller i samma storlek [1]
Om Qwen3.6-35B-A3B[1][2][3]
Qwen3.6-35B-A3B släpptes den 15 april 2026 som den första öppna modellen i Qwen3.6-serien. Den är en MoE-modell med 35 miljarder parametrar totalt, men bara 3 miljarder är aktiva per token, vilket gör den snabb och billig att köra. Den förstår bilder och video och kan köras med eller utan resonemang. Kontextfönstret är 262 144 tokens och kan utökas till drygt 1 miljon.
Enligt Qwen är den betydligt bättre än föregångaren Qwen3.5-35B-A3B på agentisk kodning och tävlar med större täta modeller som Qwen3.5-27B och Gemma4-31B. Den får till exempel 73,4 på SWE-bench Verified och 51,5 på Terminal-Bench 2.0. Den har också fått en inställning som sparar resonemang från tidigare turer i ett samtal.
Vikterna finns på Hugging Face och ModelScope under Apache 2.0, och i Alibaba Cloud Model Studio erbjuds den som API-modellen Qwen3.6-Flash.
Det viktigaste[1][2]
- Bara 3B aktiva parametrar av 35B, vilket gör den lätt att köra.
- Enligt Qwen 73,4 på SWE-bench Verified och 51,5 på Terminal-Bench 2.0.
- Förstår bilder och video, med eller utan resonemang.
- Öppna vikter under Apache 2.0; som API heter den Qwen3.6-Flash.
Källor
- [2] Qwen/Qwen3.6-35B-A3B ↗Qwen (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] Claude Opus 4.7, Qwen 3.6, Ernie Image, Happy Oyster, HY World 2.0, Gemini 3.1 TTS: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 19 apr 2026 Läst 25 okt 2026
- [1] Qwen3.6-35B-A3B: Agentic Coding Power, Now Open to All ↗Qwen (Alibaba) Officiell sida qwen.aiPublicerad 15 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-19). [3]
Placeringar i topplistor
- #69 · 18
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3.5-Omni 29 mar 2026 · inaktuell
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –