Qwen3.5-Omni
Qwens omnimodala modell som förstår text, bild, ljud och video och svarar med tal i realtid, i storlekarna Plus, Flash och Light.
- Multimodal
- Tal till text
- Text till tal
- Röstassistent
- Röstkloning
- Bildförståelse
 1 / 4
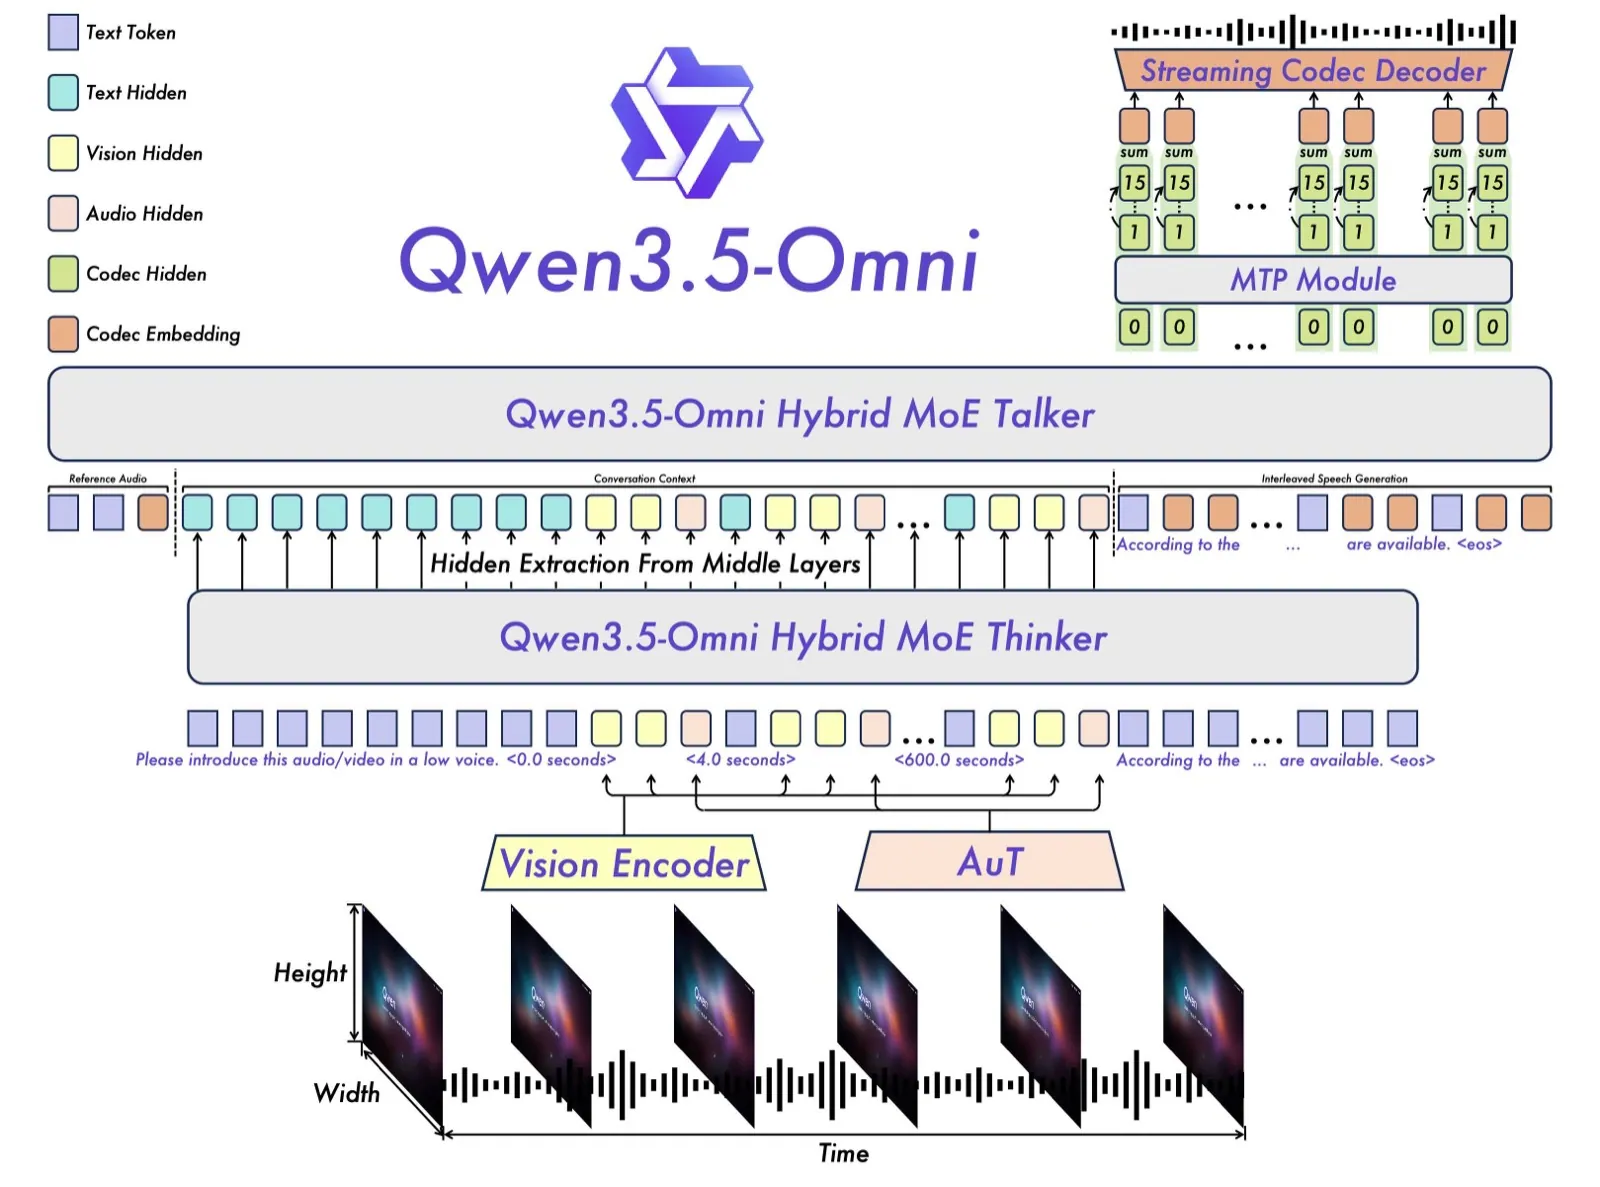
Arkitekturen med Thinker och Talker [1]
Om Qwen3.5-Omni[1][2][3]
Qwen3.5-Omni är Qwen-teamets omnimodala modell från mars 2026. Den förstår text, bilder, ljud och video med ljud och kan svara med både text och tal. Serien finns i tre storlekar, Plus, Flash och Light, och använder en MoE-arkitektur med hybrid uppmärksamhet. Den klarar 256k tokens indata, mer än tio timmar ljud och över 400 sekunder 720p-video med ljud.
Jämfört med Qwen3-Omni har språkstödet byggts ut kraftigt: taligenkänning på 113 språk och dialekter och talsyntes på 36. I realtidsläget kan den skilja mellan avbrott och bakgrundsljud, söka på webben, styra röstvolym, tempo och känsla, och klona en uppladdad röst. Qwen visar också att modellen kan skriva kod utifrån instruktioner i video med ljud, något de kallar Audio-Visual Vibe Coding.
Enligt Qwen når Qwen3.5-Omni-Plus toppresultat på 215 ljud- och videorelaterade deltester och överträffar Gemini-3.1 Pro på allmän ljudförståelse, taligenkänning, översättning och dialog. Modellen nås via Qwens API, inte som öppna vikter. I september 2026 ersattes den av Qwen3.8-Omni-Flash.
Det viktigaste[1]
- Förstår text, bild, ljud och video och svarar med tal i realtid.
- Taligenkänning på 113 språk och dialekter, talsyntes på 36.
- Enligt Qwen bättre än Gemini-3.1 Pro på allmän ljudförståelse.
- Röstkloning, webbsökning och styrning av röstens volym, tempo och känsla i realtidsläget.
Källor
- [2]
- [3] Gemma 4, Claude Code leak, Qwen 3.6, Wan 2.7, OmniVoice, DreamLite, GLM-5V: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 5 apr 2026 Läst 25 okt 2026
- [1] Qwen3.5-Omni: Scaling Up, Toward Native Omni-Modal AGI ↗Qwen (Alibaba) Officiell sida qwen.aiPublicerad 29 mar 2026 Läst 25 okt 2026
Historik
Placeringar i topplistor
- Artificial Analysis Speech to TextPlus-versionen#23 · 3,5 %
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Alibaba (Qwen, Wan, Tongyi)
- Qwen-Image-2.1 (inkl. Turbo) 20 sep 2026
- Qwen3.8-LiveTranslate 18 sep 2026
- Qwen3.8-Omni-Flash 18 sep 2026
- Qwen-Drive-1.0-4B 3 sep 2026
- Qwen3.8-Max-0902 2 sep 2026
- DiffSynth-Music sep 2026
- Qwen-Audio-3.1-TTS-Plus sep 2026
- Qwen3.8-Flash-Next 26 aug 2026
- Wan 3.0 24 aug 2026
- HappyShrimp 1.0 17 aug 2026
- Wan-Animate-2 7 aug 2026
- LongHorizon-Harness 3 aug 2026
- Qwen3.8-Max 3 aug 2026 · inaktuell
- Qwen3.8-2.4T-A95B aug 2026
- Qwen3.8-27B aug 2026
- ClinFusion 28 jul 2026
- Qwen-Image-3.0 (Pro) 21 jul 2026
- HappyHorse 28 apr 2026
- Qwen3.6-27B 22 apr 2026 · inaktuell
- CoInteract 21 apr 2026
- Happy Oyster 16 apr 2026
- Qwen3.6-35B-A3B 15 apr 2026
- Qwen3.6-Plus 1 apr 2026
- Wan 2.7 apr 2026 · inaktuell
- Wan 2.7 Image apr 2026
- Qwen3-Embedding 5 jun 2025
- Fun-Realtime-ASR –