Dream-RSI
En forskningsmetod från Google som låter kodagenter bli bättre på att leta efter lösningar genom att "drömma": nya sökstrategier provas mot redan inspelade experiment innan pengar läggs på nya körningar.
- Agenter
- Kod
- Forskning & vetenskap
 1 / 3
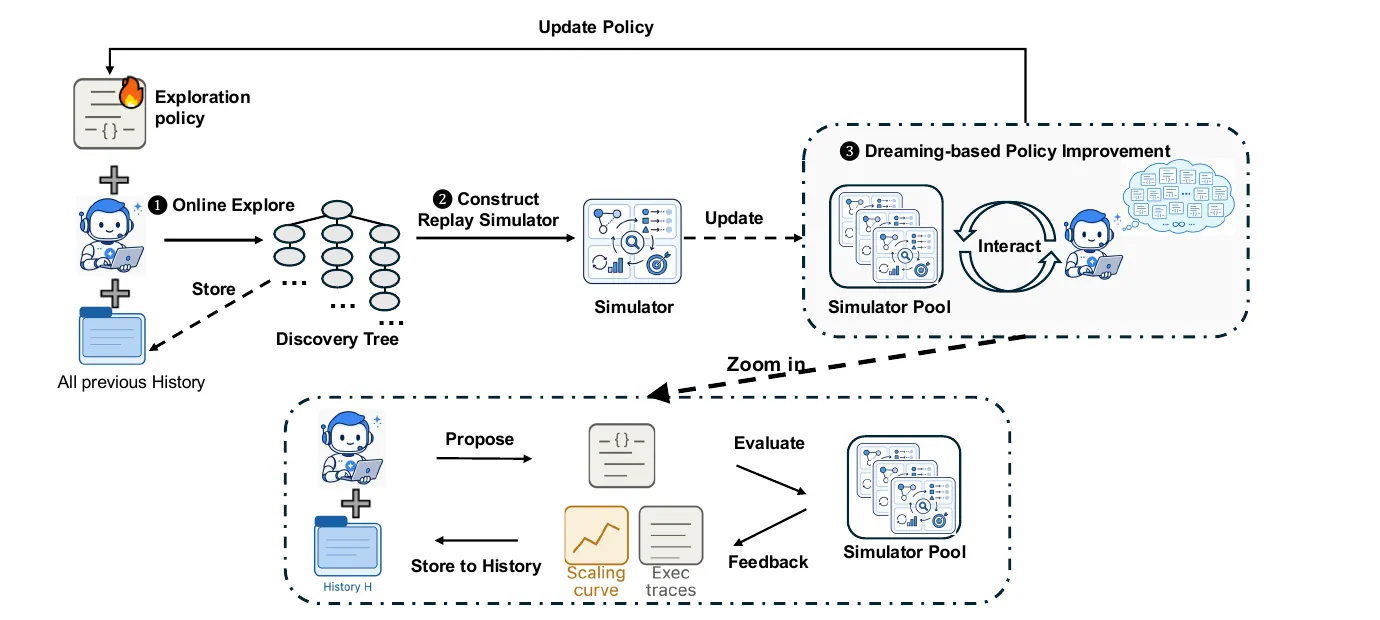
Loopen: utforska på riktigt, spara historiken som simulator, drömma fram en bättre strategi och använda den [1]
Om Dream-RSI[1][2][3][4]
Dream-RSI (Recursive Self-Improvement through Evolving Worlds) handlar om AI-agenter som gör upptäckter genom att skriva och testa kod tusentals gånger, till exempel för att hitta snabbare algoritmer eller GPU-kärnor. Det som avgör hur effektivt det går är agentens sökstrategi: vilka spår den fortsätter på, vad den kör parallellt och när den ger upp en idé. Den strategin är normalt handskriven och ändras aldrig.
Forskarnas poäng är att en avslutad körning redan är ett exakt facit. Den sparar ett träd av alla försök agenten gjorde och vad varje försök gav. En ny sökstrategi kan därför provas genom att gå igenom samma träd i en annan ordning, utan att någon kod behöver köras på nytt. Tusentals varianter av strategin kan "drömmas" och poängsättas på så vis, och bara den bästa används på riktigt. Den nya körningen ger i sin tur ett nytt träd att drömma i, så förbättringen kan upprepas. Eftersom den gamla strategin alltid är en av kandidaterna kan den nya aldrig bli sämre på det inspelade facit.
Metoden har testats på åtta uppgifter inom algoritmutveckling, matematisk optimering och GPU-programmering, med Gemini-modeller som agent. Enligt forskarna når Dream-RSI lika bra eller bättre resultat med mycket mindre beräkning, till exempel 2,43 gånger färre försök på en VGG16-kärna och 162 gånger färre agentanrop än metoden SimpleTES på en Lasso-uppgift.
Arbetet kommer från Google, Google DeepMind, University of Maryland och University of Virginia. Koden släpptes på GitHub i oktober 2026.
Det viktigaste[1][3]
- Förbättrar en kodagents sökstrategi genom att spela upp tidigare experiment i stället för att köra nya.
- Tusentals strategier kan provas mot inspelad historik utan en enda ny kodkörning.
- Enligt forskarna 2,43 gånger färre försök på en VGG16-kärna vid jämförbart resultat och 2,09 gånger högre poäng på ConvDiv vid samma budget.
- Enligt forskarna 162 gånger färre agentanrop än SimpleTES på en Lasso-uppgift.
- Testad på åtta uppgifter inom algoritmer, matematisk optimering och GPU-kärnor.
Källor
- [1] Dream-RSI: Recursive Self-Improvement through Evolving Worlds ↗Google, Google DeepMind, University of Maryland och University of Virginia Officiell sida dream-rsi.comPublicerad okänt datum Läst 25 okt 2026
- [3]
- [4] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [2] Dream-RSI: Recursive Self-Improvement through Evolving Worlds ↗arXiv Forskningsartikel arxiv.orgPublicerad 14 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-20). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Google
- Gemini 4 Argon 13 okt 2026
- EmbeddingGemma 2 6 okt 2026
- AlphaProtein Novo 5 okt 2026
- Nano Banana 2.1 okt 2026
- SynthID Bio 30 sep 2026
- Gemini 3.8 Flash TTS / Flash-Lite TTS 23 sep 2026
- Gemini 3.8 Live 15 sep 2026
- AlphaGenome Atlas 8 sep 2026
- WeatherNext 3 3 sep 2026
- Gemini 3.8 Flash / Flash Cyber 2 sep 2026
- TimesFM-3 31 aug 2026
- Gemini Omni 1.1 Flash 27 aug 2026
- Planetary Prediction Engine 27 aug 2026
- Gemini 3.5 Transcribe 26 aug 2026
- ORBIT 22 aug 2026
- Gemini 3.7 Flash 13 aug 2026 · inaktuell
- WeatherNext Cyclones 6 aug 2026
- Gemini Robotics ER 2 30 jul 2026
- Lyria 3.5 29 jul 2026
- Gemini 3.6 Flash 21 jul 2026 · inaktuell
- Gemini 3.5 Live Translate 9 jun 2026
- Antigravity Agent 19 maj 2026
- Vision Banana 22 apr 2026
- Gemini 3.1 Flash TTS 15 apr 2026 · inaktuell
- Gemma 4 2 apr 2026
- Gemini Embedding 2 10 mar 2026