Nano Banana 2.1
Googles nya modell för att skapa och redigera bilder, byggd på Gemini 3.6 Flash, som enligt Google blivit bättre på redigering, återkommande karaktärer och infografik.
- Bildgenerering
- Bildredigering
- Multimodal
 1 / 4
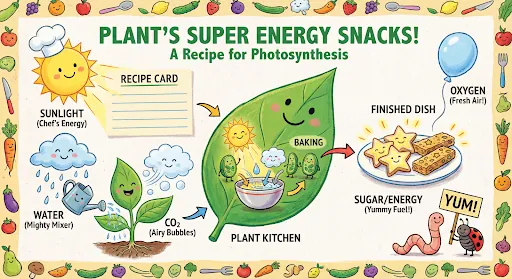
Infografik om fotosyntes från Googles API-dokumentation för bildgenerering, där kodexemplen använder Nano Banana 2.1 (sidan anger inte vilken modell som gjorde bilden) [2]
Om Nano Banana 2.1[1][2][4][5]
Nano Banana 2.1 är Googles bildmodell i Gemini 3-familjen och efterföljare till Nano Banana 2 (Gemini 3.1 Flash Image). Den bygger på Gemini 3.6 Flash, tar emot text och bilder och svarar med bilder och text. Modellkortet publicerades i oktober 2026. Modellen tänker alltid innan den ritar; i API:t kan man välja hur mycket (minimal, medium eller high).
Google lyfter fram exakt bildskapande och redigering i många snabba omtag, tydlig text på affischer och diagram, verklighetskunskap och text på flera språk. Man kan ge upp till 14 referensbilder, varav upp till 5 för att hålla personer konsekventa. Bilder skapas i 1K, 2K eller 4K; den minsta storleken 512 px från Nano Banana 2 finns inte längre. I Googles egna jämförelser, där människor ställer bilder sida vid sida, vinner 2.1 med tänkande över både Nano Banana 2 och Nano Banana Pro i bland annat allmän redigering, karaktärskonsekvens och infografik.
Google skriver själv att modellen fortfarande kan hitta på fakta, att liten text och långa stycken ofta blir suddiga, att karaktärer inte alltid blir helt lika och att den kan blanda ihop höger och vänster. Modellen finns i Gemini-appen, Google AI Studio och Gemini API (modell-id gemini-nano-banana-2.1), AI Mode i Google Sök, Google Ads, Google Flow och Google Stitch. Google har inte publicerat något eget lanseringsinlägg, bara modellkortet och dokumentationen.
Det viktigaste[1][2][3]
- Bygger på Gemini 3.6 Flash och ersätter Nano Banana 2 (Gemini 3.1 Flash Image).
- Enligt Googles människobedömningar får 2.1 med tänkande 1050 Elo i allmän bildpreferens, mot 990 för Nano Banana 2 och 935 för Nano Banana Pro.
- Enligt Google ökar andelen korrekta infografiker från 0,179 (Nano Banana 2) till 0,521.
- Upp till 14 referensbilder; utdata i 1K, 2K eller 4K.
- Pris i API:t: cirka 0,034 dollar per bild i 1K, 0,050 i 2K och 0,113 i 4K.
- Google varnar själv för faktafel, suddig liten text och ibland förväxlade höger och vänster.
Källor
- [2] Image generation with Gemini (aka Nano Banana) ↗Google AI for Developers Officiell sida ai.google.devPublicerad okänt datum Läst 25 okt 2026
- [3] Gemini Developer API pricing ↗Google AI for Developers Officiell sida ai.google.devPublicerad okänt datum Läst 25 okt 2026
- [4] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [5] New AI enzymes, 700+ math breakthroughs, AI for DNA mutations, room temp semiconductors: AI NEWS ↗AI Search Video youtube.comPublicerad 10 okt 2026 Läst 25 okt 2026
- [1] Nano Banana 2.1 - Model Card ↗Google DeepMind Modellkort deepmind.googlePublicerad okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-10). [5]
Placeringar i topplistor
- #4 · 1176 ± 12
- Image Edit Arenapreliminär placering (få röster)#5 · 1426 ± 6
- Text-to-Image Arenapreliminär placering (få röster)#6 · 1328 ± 9
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Google
- Gemini 4 Argon 13 okt 2026
- EmbeddingGemma 2 6 okt 2026
- AlphaProtein Novo 5 okt 2026
- SynthID Bio 30 sep 2026
- Gemini 3.8 Flash TTS / Flash-Lite TTS 23 sep 2026
- Gemini 3.8 Live 15 sep 2026
- Dream-RSI 14 sep 2026
- AlphaGenome Atlas 8 sep 2026
- WeatherNext 3 3 sep 2026
- Gemini 3.8 Flash / Flash Cyber 2 sep 2026
- TimesFM-3 31 aug 2026
- Gemini Omni 1.1 Flash 27 aug 2026
- Planetary Prediction Engine 27 aug 2026
- Gemini 3.5 Transcribe 26 aug 2026
- ORBIT 22 aug 2026
- Gemini 3.7 Flash 13 aug 2026 · inaktuell
- WeatherNext Cyclones 6 aug 2026
- Gemini Robotics ER 2 30 jul 2026
- Lyria 3.5 29 jul 2026
- Gemini 3.6 Flash 21 jul 2026 · inaktuell
- Gemini 3.5 Live Translate 9 jun 2026
- Antigravity Agent 19 maj 2026
- Vision Banana 22 apr 2026
- Gemini 3.1 Flash TTS 15 apr 2026 · inaktuell
- Gemma 4 2 apr 2026
- Gemini Embedding 2 10 mar 2026