Gemini Embedding 2
Googles första inbäddningsmodell som lägger text, bilder, video, ljud och PDF:er i samma rum av vektorer, så att man kan söka mellan olika sorters innehåll.
- Sök & kunskap
- Multimodal
 1 / 2
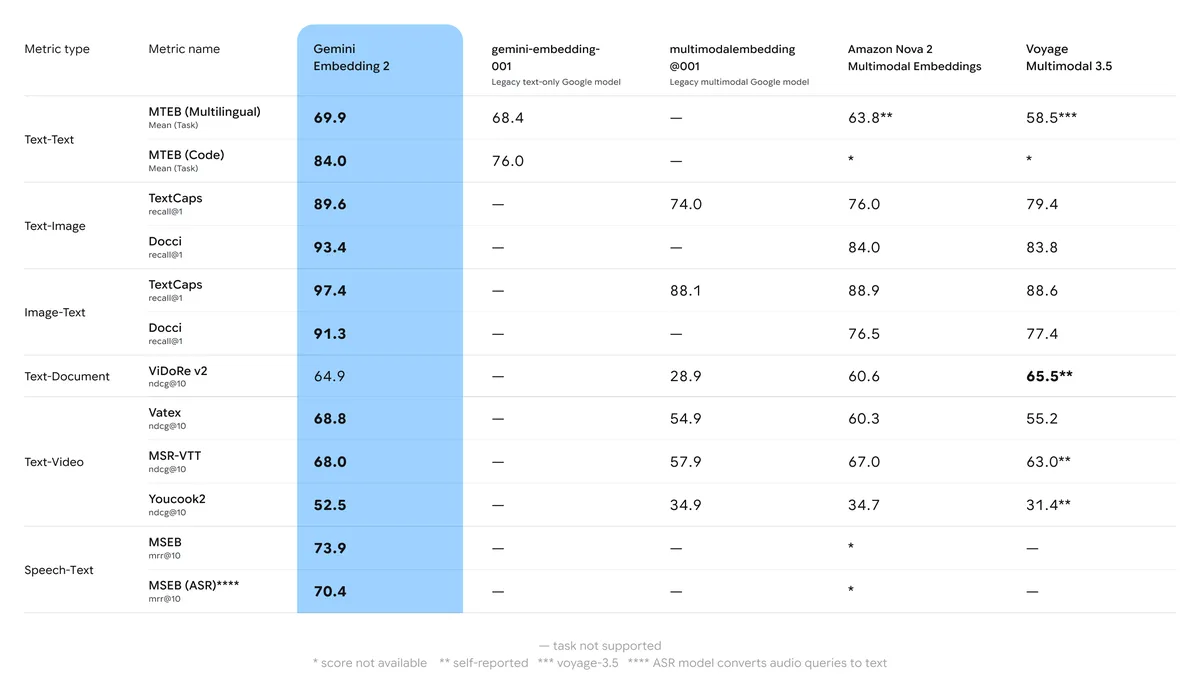
Googles jämförelse av Gemini Embedding 2 med andra inbäddningsmodeller [1]
Om Gemini Embedding 2[1][2][4][5]
Gemini Embedding 2 är Googles första inbäddningsmodell som är multimodal från grunden. En inbäddningsmodell gör om innehåll till långa talföljder (vektorer) så att liknande saker hamnar nära varandra, vilket används för sökning, rekommendationer och för att hämta rätt underlag åt en AI (RAG). Gemini Embedding 2 bygger på Gemini-arkitekturen och lägger text, bilder, video, ljud och PDF-dokument i ett och samma rum, så att man till exempel kan söka bland videor med en textfråga. Ljud bäddas in direkt, utan att först skrivas ut som text, och man kan blanda bild och text i samma anrop.
Modellen presenterades i öppen förhandsversion den 10 mars 2026 och blev allmänt tillgänglig den 22 april 2026. Enligt Google hanterar den över 100 språk. Ett anrop kan innehålla upp till 8 192 tokens text, upp till 6 bilder, video på upp till 120 sekunder och PDF:er på upp till 6 sidor. Vektorerna är som standard 3 072 tal långa men kan kortas ned till mellan 128 och 3 072; Google rekommenderar 768, 1 536 eller 3 072.
Google skriver att modellen slår ledande modeller på uppgifter med text, bild och video, men siffrorna redovisas bara i ett diagram. Bland kundexemplen uppger Paramount Skydance 85,3 % träff på första plats vid sökning från text till video. Förhandsversionen fanns i Gemini API och Vertex AI, och den färdiga versionen finns i Gemini API och på Gemini Enterprise Agent Platform. Priset är 0,20 dollar per miljon tokens text, 0,45 dollar per miljon tokens bild, 6,50 för ljud och 12 för video, med halva priset i batchläge.
Det viktigaste[1][2][4][5]
- Text, bild, video, ljud och PDF i samma vektorrum, så att man kan söka mellan olika sorters innehåll.
- Över 100 språk; upp till 8 192 tokens text, 6 bilder, 120 sekunder video eller 6 PDF-sidor per anrop.
- Vektorlängd valbar mellan 128 och 3 072.
- Allmänt tillgänglig sedan 22 april 2026 (modell-ID gemini-embedding-2).
- 0,20 dollar per miljon tokens text; bild, ljud och video kostar mer.
Källor
- [3] Building with Gemini Embedding 2: Agentic multimodal RAG and beyond ↗Google Developers Blog Officiell sida developers.googleblog.comPublicerad okänt datum Läst 25 okt 2026
- [4] Gemini Embedding 2 model ↗Google AI for Developers Officiell sida ai.google.devPublicerad okänt datum Läst 25 okt 2026
- [5] Gemini Developer API pricing ↗Google AI for Developers Officiell sida ai.google.devPublicerad okänt datum Läst 25 okt 2026
- [2] Gemini Embedding 2 is now generally available. ↗Google Officiell sida blog.googlePublicerad 22 apr 2026 Läst 25 okt 2026
- [1] Gemini Embedding 2: Our first natively multimodal embedding model ↗Google Officiell sida blog.googlePublicerad 10 mar 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan som nyare version/produkt hittad vid genomgången av AI Search-nyheter. [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Google
- Gemini 4 Argon 13 okt 2026
- EmbeddingGemma 2 6 okt 2026
- AlphaProtein Novo 5 okt 2026
- Nano Banana 2.1 okt 2026
- SynthID Bio 30 sep 2026
- Gemini 3.8 Flash TTS / Flash-Lite TTS 23 sep 2026
- Gemini 3.8 Live 15 sep 2026
- Dream-RSI 14 sep 2026
- AlphaGenome Atlas 8 sep 2026
- WeatherNext 3 3 sep 2026
- Gemini 3.8 Flash / Flash Cyber 2 sep 2026
- TimesFM-3 31 aug 2026
- Gemini Omni 1.1 Flash 27 aug 2026
- Planetary Prediction Engine 27 aug 2026
- Gemini 3.5 Transcribe 26 aug 2026
- ORBIT 22 aug 2026
- Gemini 3.7 Flash 13 aug 2026 · inaktuell
- WeatherNext Cyclones 6 aug 2026
- Gemini Robotics ER 2 30 jul 2026
- Lyria 3.5 29 jul 2026
- Gemini 3.6 Flash 21 jul 2026 · inaktuell
- Gemini 3.5 Live Translate 9 jun 2026
- Antigravity Agent 19 maj 2026
- Vision Banana 22 apr 2026
- Gemini 3.1 Flash TTS 15 apr 2026 · inaktuell
- Gemma 4 2 apr 2026