Hy-Nomas
En öppen "världsmodell" från Tencent Hunyuan som skapar en videovärld bit för bit, där man styr vad som händer med text och var kameran ska gå medan videon fortsätter.
- Världsmodeller
- Videogenerering
- 3D
- Robotik
- Kör lokalt
 1 / 5
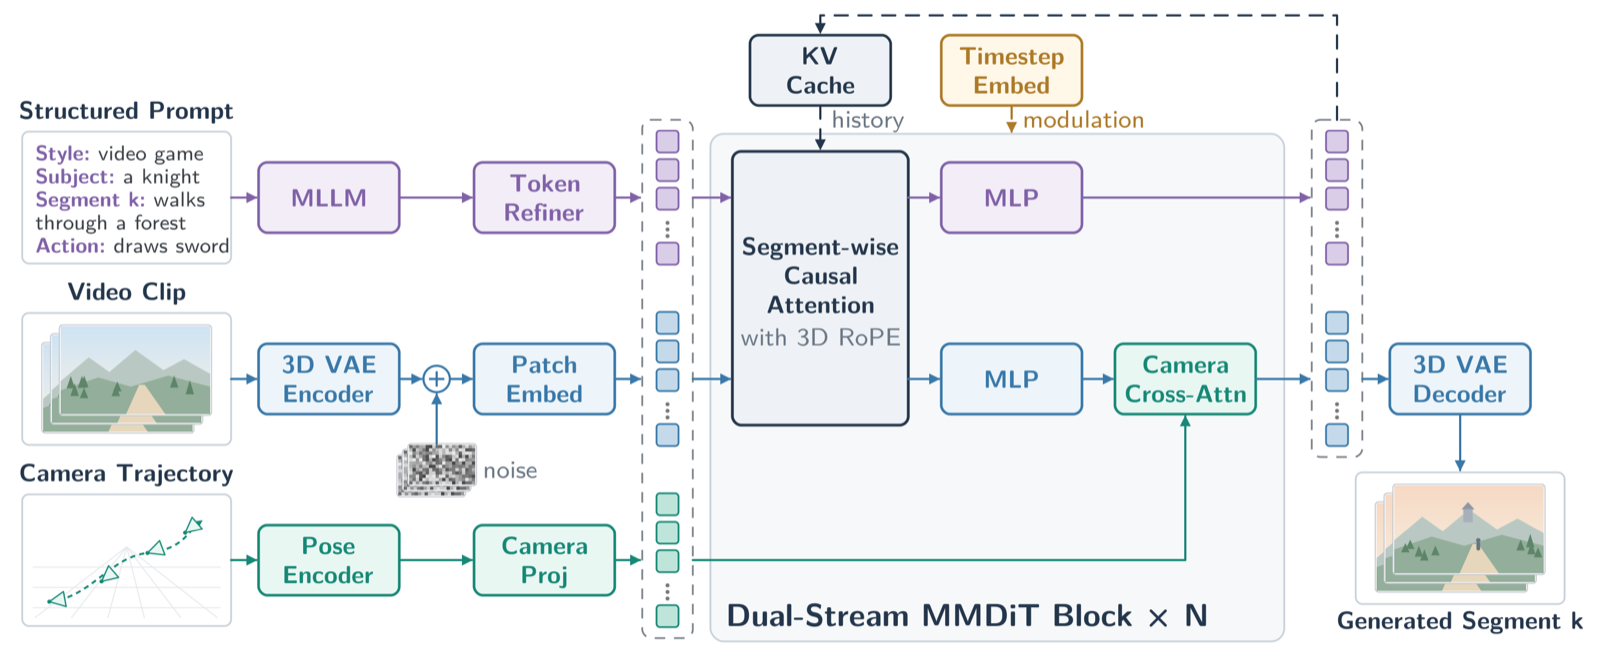
Modellens uppbyggnad: text, video och kamerabana går in i diffusionstransformern, med en KV-cache som minne mellan segmenten [2]
Om Hy-Nomas[1][2][4]
Hy-Nomas är en videomodell som genererar en värld ett videosegment i taget. Mellan segmenten kan användaren styra fortsättningen med vanliga textinstruktioner, till exempel lägga till föremål, byta stil eller miljö, beskriva vad en figur ska göra, eller ange en kamerabana. Modellen minns det som redan har genererats (via en så kallad KV-cache), så att världen ska hänga ihop även när kameran vänder tillbaka till en plats den redan visat.
Tekniskt består den av en diffusionstransformer som arbetar segment för segment, en textkodare från Qwen2.5-VL-7B, moduler för kamerastyrning och en egen videoavkodare (PixelUMM). Den destillerade versionen behöver 8 avbrusningssteg per segment och ger video i 720 × 1280 pixlar med 24 bilder per sekund. Standardinställningen kör på åtta grafikkort, men det finns även en snålare variant med komprimerade vikter som enligt Tencent fungerar på ett enda NVIDIA RTX 4090. Det finns också tilläggsvikter för en mer filmisk bild och för simulering av robotarmar.
Vikter och kod ligger öppet på Hugging Face och GitHub under Apache 2.0, och det finns en webbdemo där man kan bygga en värld och ladda ner videon. Tencent har också släppt testsviten Hy-Nomas-Bench med 280 testfall för styrning med text och kamera samt rumsligt minne. Den tekniska rapporten var vid läsningen ännu inte publicerad ("coming soon").
Det viktigaste[2]
- Styr en pågående video med text och kamerabanor, segment för segment, i flera omgångar.
- Minns tidigare segment så att platser finns kvar när kameran vänder tillbaka.
- 720 × 1280 pixlar i 24 bilder per sekund med 8 avbrusningssteg per segment.
- Enligt Tencent räcker ett enda RTX 4090 med den komprimerade varianten; standardläget använder åtta grafikkort.
- Öppna vikter under Apache 2.0, plus testsviten Hy-Nomas-Bench med 280 testfall.
Källor
- [1] Hy-Nomas — Interactive World Modeling ↗Tencent Hunyuan Officiell sida hy-nomas.hy.tencent.comPublicerad okänt datum Läst 25 okt 2026
- [4] Cybersecurity chaos, AI for DNA, Kimi K3.1, Claude Duet, Dessa, Fibo 2, Minimax 3.1: AI NEWS ↗AI Search Video youtube.comPublicerad 24 okt 2026 Läst 25 okt 2026
- [2] Hy-Nomas: Towards Free-Form Interactive World Generation ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 21 okt 2026 Läst 25 okt 2026
- [3] Hy-Nomas: Towards Free-form Interactive World Generation ↗Tencent Hunyuan (GitHub) Officiell sida github.comPublicerad 21 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search-videon. [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026