Hy3 preview
Tencents effektiva MoE-språkmodell från april 2026 med 295 miljarder parametrar (21 miljarder aktiva), byggd för kod och agentuppgifter och med justerbar tankenivå.
- Språkmodell
- Resonemang
- Kod
- Agenter
 1 / 2
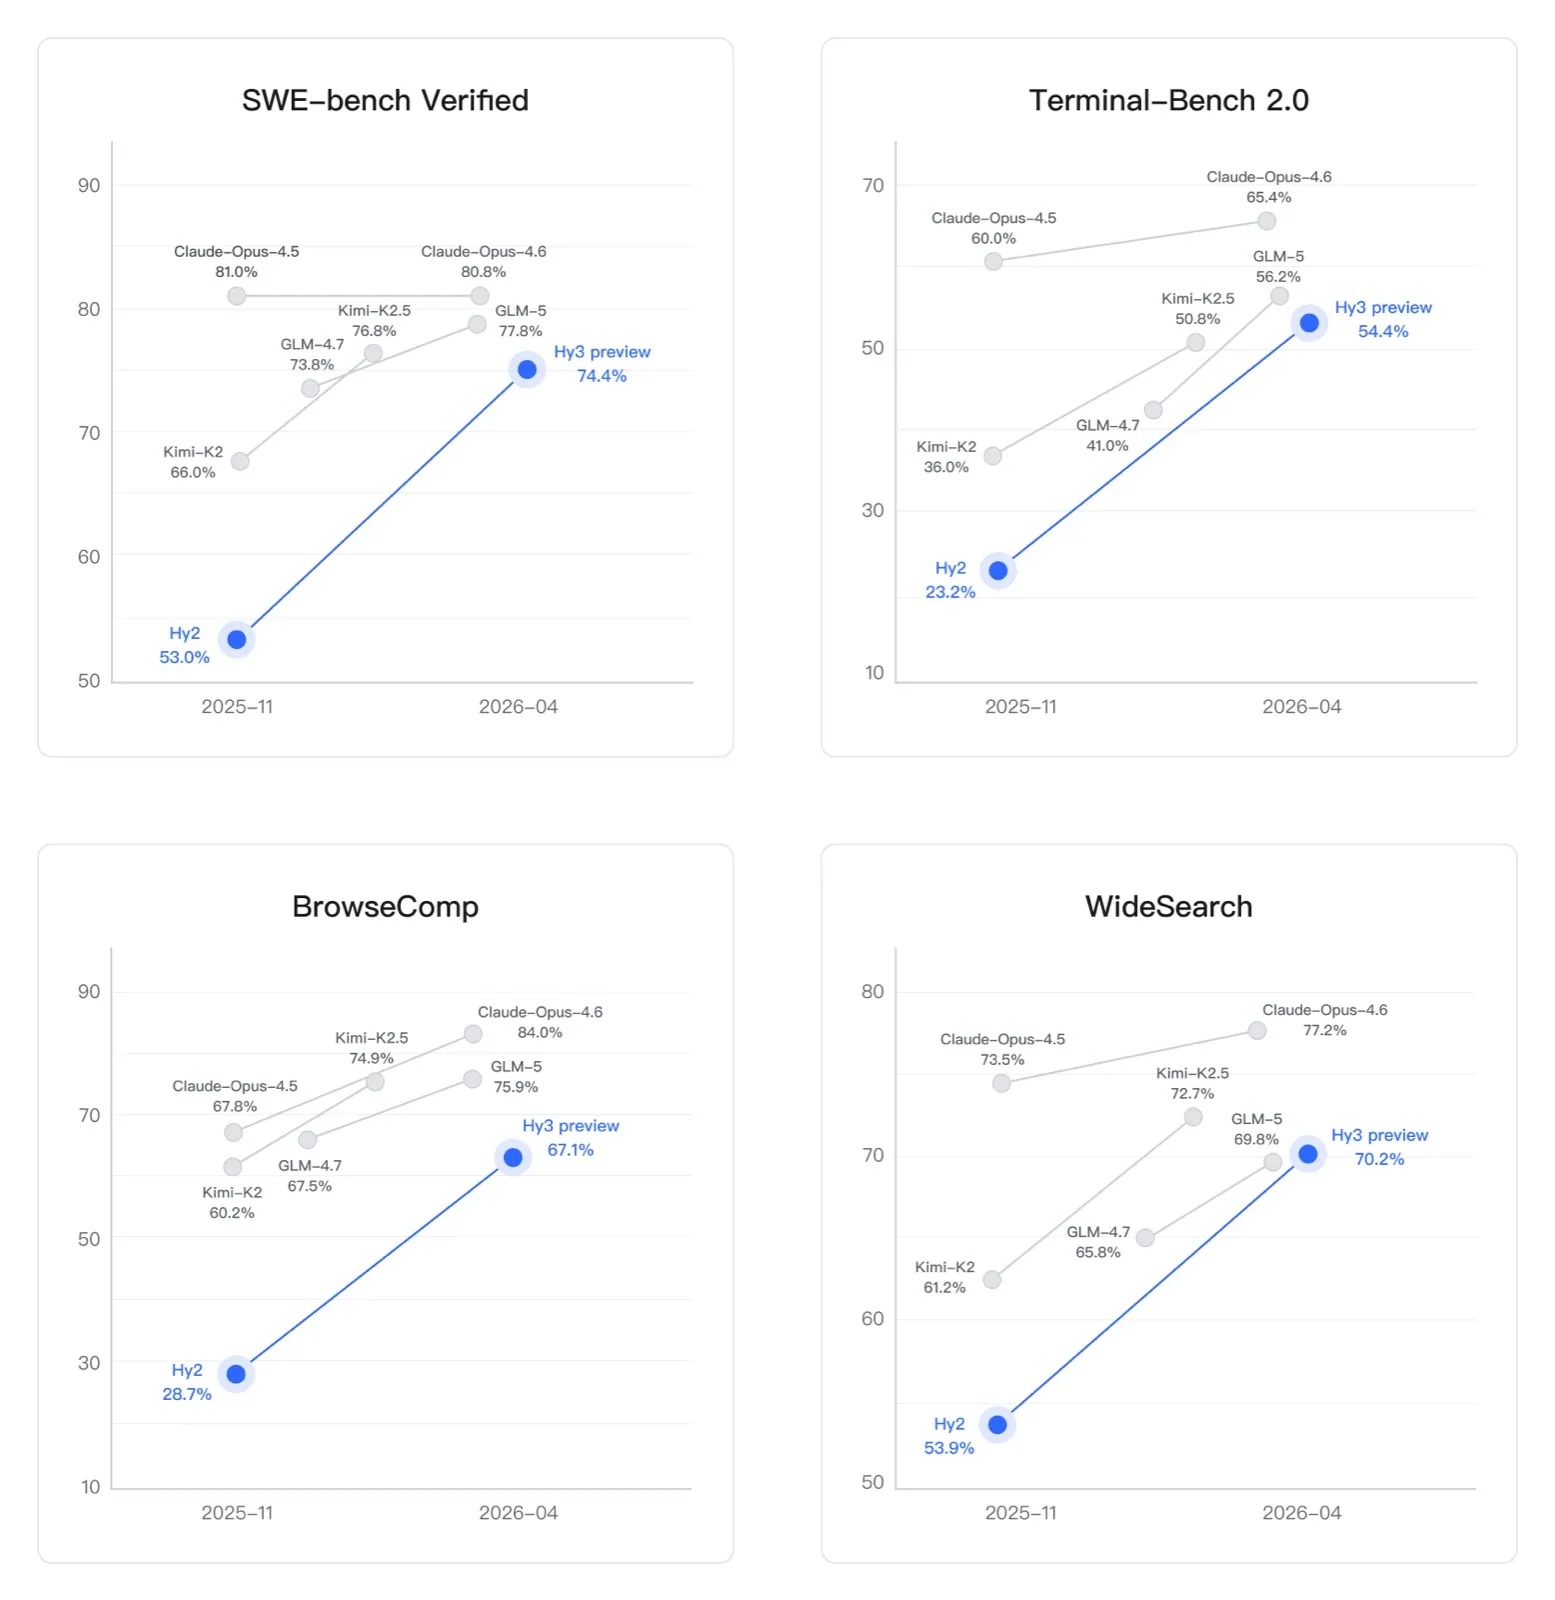
Tencents resultat för kod- och agenttester [1]
Om Hy3 preview[1][2][3][4]
Hy3 preview är en språkmodell från Tencent Hy-teamet (tidigare Hunyuan) som släpptes med öppna vikter i april 2026. Det är en Mixture-of-Experts-modell med 295 miljarder parametrar totalt, varav 21 miljarder används per token, och den kan läsa 256 000 tokens. Det var enligt Tencent den första modellen som tränades på deras ombyggda infrastruktur.
Tencent lyfte fram förbättringar inom komplexa resonemang, att följa instruktioner, att lära sig av lång och rörig kontext samt framför allt kod och agentuppgifter. Hur mycket modellen tänker går att ställa in: inget resonemang för snabba svar, eller en låg eller hög nivå för svåra problem.
Vikterna släpptes under Tencent Hy Community License, som inte gäller i EU, Storbritannien och Sydkorea och som kräver en särskild licens för företag med över 100 miljoner användare i månaden.
I juli 2026 följdes förhandsversionen av den färdiga Hy3, med samma storlek men mer efterträning och Apache 2.0-licens. I augusti 2026 kom nästa generation, Hy4 preview.
Det viktigaste[1][2][3]
- 295 miljarder parametrar totalt och 21 miljarder aktiva, 256k tokens kontext.
- Justerbar tankenivå: inget resonemang, låg eller hög.
- Enligt Tencent störst förbättring inom kod och agentuppgifter, med konkurrenskraftiga resultat på SWE-bench Verified, Terminal-Bench 2.0 och BrowseComp.
- Licensen gäller inte i EU, Storbritannien och Sydkorea.
- Ersatt av den färdiga Hy3 (juli 2026) och sedan Hy4 preview (augusti 2026).
Källor
- [3] tencent/Hy4-preview ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 27 aug 2026 Läst 25 okt 2026
- [2] tencent/Hy3 ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 2 jul 2026 Läst 25 okt 2026
- [4] Deepseek V4, Kimi K2.6, MiMo v2.5, GPT 5.5, GPT Images 2, Qwen 3.6, HY3, Vision Banana: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 26 apr 2026 Läst 25 okt 2026
- [1] tencent/Hy3-preview ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 23 apr 2026 Läst 25 okt 2026
Historik
Placeringar i topplistor
- WebDev Arenaförhandsversionen#119 · 1357 ± 17
- LMArena TextFörhandsversion#154 · 1409 ± 7
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- Hy3 jul 2026 · inaktuell
- SCoPE 25 jun 2026
- HY-World 2.0 16 apr 2026