WeVisOne-VL
En öppen bildmodell från Tencents WeChat Vision-team som i en och samma modell hittar, räknar, läser och klipper ut saker i bilder, ända ner till enskilda hårstrån.
- Bildförståelse
- Dokument & OCR
- Bildredigering
- Kör lokalt
 1 / 6
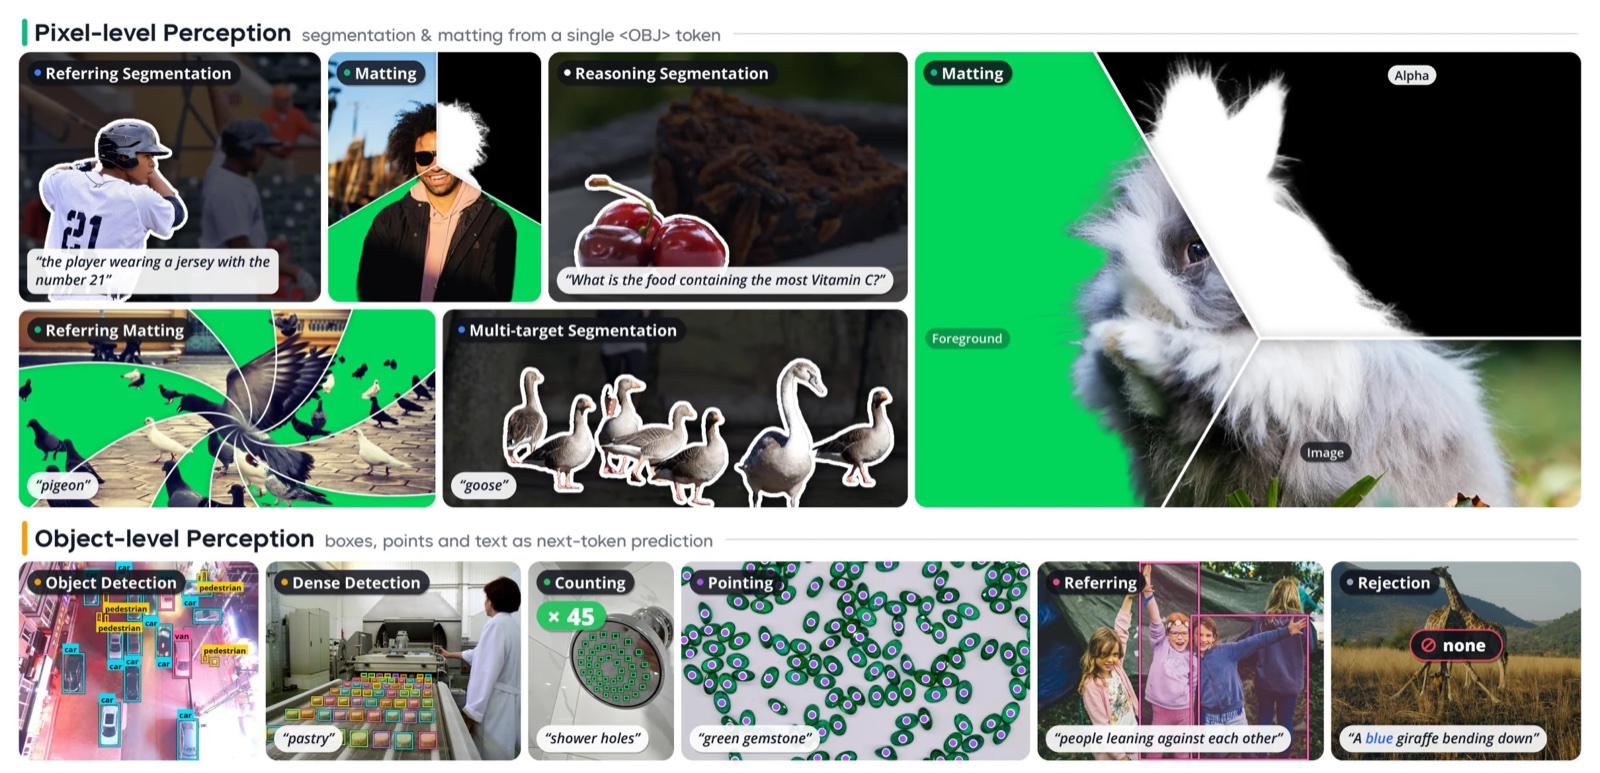
Översikt över allt modellen kan: segmentering, utklipp, detektering, räkning, pekning och att svara "none" när något saknas [1]
Om WeVisOne-VL[1][2][3][5]
WeVisOne-VL (WeChat Vision All-in-One) är en så kallad vision-language-modell, alltså en modell som tar emot en bild och en textfråga. Den är specialiserad på exakt visuell uppfattning snarare än på att prata om bilder. Samma modell kan hitta och rama in föremål, peka ut eller räkna dem, hitta det som en beskrivning syftar på (till exempel "spelaren med nummer 21 på tröjan"), läsa text i bilden (OCR), göra exakta masker och dessutom ta fram mjuka utklipp (så kallad matting) där hår och päls följer med. Om det man frågar efter inte finns i bilden ska modellen svara "None" i stället för att hitta på.
Modellen bygger på Qwen3-VL. Positioner skrivs ut som vanliga tokens (en ruta kostar fyra tokens, en punkt två), och för varje hittat föremål skickas en särskild <OBJ>-token till en liten pixelavkodare på 9,6 miljoner parametrar som ritar masken eller utklippet. Någon separat segmenteringsmodell som SAM behövs inte när modellen körs. Den tränades i tre steg med övervakad träning och sedan förstärkningsinlärning, på omkring 100 miljoner bilder som togs fram med en egen datamotor.
Tencent har släppt två storlekar, 2B och 4B, på Hugging Face tillsammans med kod, en teknisk rapport och en webbdemo. Enligt modellkortet är Tencents egen kod släppt under Apache 2.0, medan tredjepartskomponenter behåller sina egna licenser. Tencent skriver att modellen är tänkt för forskning och inte för att identifiera personer. Den hanterar en bild åt gången och har inte stöd för video i pixelavkodaren.
Det viktigaste[1][2][4]
- En enda modell för objektdetektering, räkning, pekning, OCR, segmentering och mjuka utklipp (matting).
- Svarar "None" när det efterfrågade föremålet inte finns i bilden. Enligt Tencent avvisar 4B-modellen 96,4 % av sådana frågor på WeRef-Bench, mot 73,0 % för bästa jämförda modell.
- Enligt Tencent leder modellen på över 30 testsviter, bland annat LVIS (55,3 mot 50,7) och ReasonSeg (71,2 mot 65,0) jämfört med bästa öppna alternativ.
- Liten nog att köra lokalt: 2B- och 4B-versionerna har öppna vikter på Hugging Face.
- Tränad på omkring 100 miljoner bilder framtagna med en egen, självförbättrande datamotor.
Källor
- [1] WeVisOne-VL: Unified Visual Perception from Objects to Pixels ↗WeChat Vision, Tencent Officiell sida tencent.github.ioPublicerad okänt datum Läst 25 okt 2026
- [5] Cybersecurity chaos, AI for DNA, Kimi K3.1, Claude Duet, Dessa, Fibo 2, Minimax 3.1: AI NEWS ↗AI Search Video youtube.comPublicerad 24 okt 2026 Läst 25 okt 2026
- [2] WeVisOne-VL: Unified Visual Perception from Objects to Pixels ↗arXiv Forskningsartikel arxiv.orgPublicerad 22 okt 2026 Läst 25 okt 2026
- [3] tencent/WeVisOne-VL-4B ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 22 okt 2026 Läst 25 okt 2026
- [4] Tencent/WeVisOne-VL ↗Tencent (GitHub) Officiell sida github.comPublicerad 22 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search-videon. [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026