Hy4 preview
Tencents nya flaggskeppsmodell med öppna vikter under Apache 2.0: en MoE-modell med 770 miljarder parametrar, 49 miljarder aktiva och en miljon tokens kontext, byggd för kod, kontorsarbete, spelutveckling och forskning.
- Språkmodell
- Resonemang
- Kod
- Agenter
 1 / 2
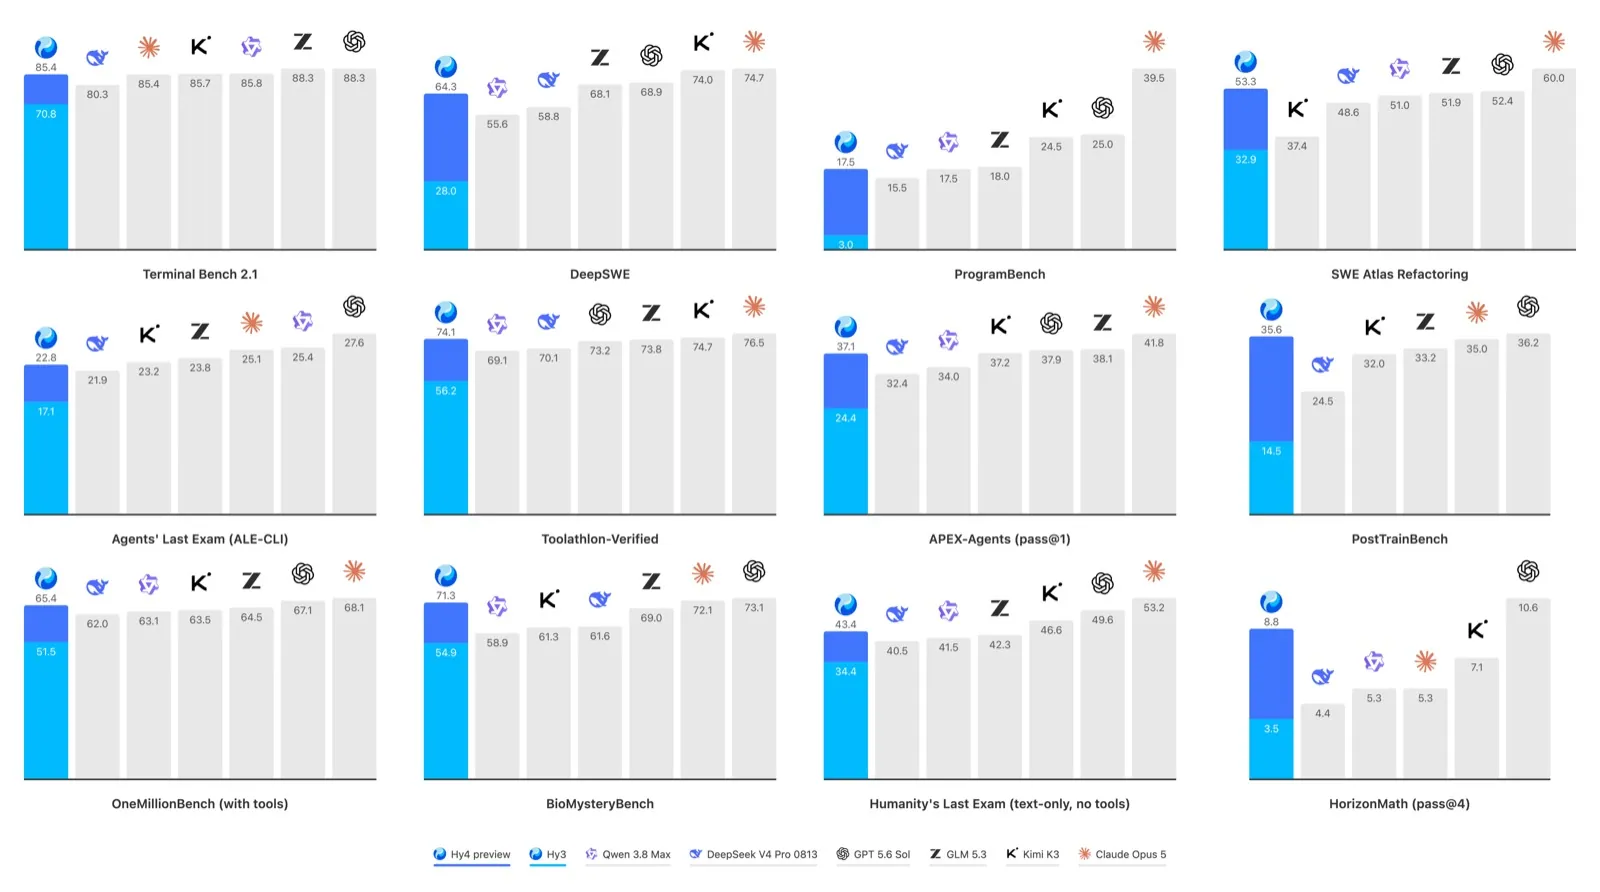
Tencents jämförelser: Hy4 preview mot Hy3, Qwen 3.8 Max, DeepSeek V4 Pro, GPT 5.6 Sol, GLM 5.3, Kimi K3 och Claude Opus 5 [1]
Om Hy4 preview[1][2]
Hy4 preview är en förhandsversion av nästa generation av Tencents språkmodell, utvecklad av Tencent Hy-teamet (tidigare Hunyuan). Det är en Mixture-of-Experts-modell med 770 miljarder parametrar totalt, varav 49 miljarder används per token. Den har 78 lager, 256 experter per lager varav åtta väljs per token plus en delad expert, och kan läsa upp till en miljon tokens. Ett extra lager för att förutsäga flera tokens i taget (10 miljarder parametrar) gör genereringen snabbare.
Tencent skriver att man har skalat upp modellstorlek, kontextlängd och träningsdata, och att steget från Hy3 är det största mellan två generationer de har mätt. Träningsdatan byggdes tillsammans med experter inom Tencent, som programmerare, spelutvecklare, finansanalytiker och säkerhetsexperter. Fokus ligger på fyra områden: programmering, kontorsarbete och analys (dokument, kalkylark och presentationer), spelutveckling (från en enda beskrivning till en spelbar prototyp) och vetenskaplig forskning. Modellen utvecklas också tillsammans med Tencents egna verktyg CodeBuddy och WorkBuddy.
I ett blindtest där 163 interna experter bedömde svar på 203 programmeringsuppgifter hamnade Hy4 preview enligt Tencent strax före både GLM 5.3 och Kimi K3. Tencent är öppna med att det är en tidig version: modellen kan resonera längre än nödvändigt och har en tendens att dubbelkontrollera sitt eget arbete för mycket.
Vikterna finns på Hugging Face, ModelScope, GitCode och CNB, även i en FP8-version, under Apache 2.0. Det finns färdiga recept för att köra modellen med vLLM och SGLang. Som standard resonerar modellen på högsta nivån, men det går att stänga av resonemanget för snabba svar.
Det viktigaste[1]
- 770 miljarder parametrar totalt och 49 miljarder aktiva per token, med en miljon tokens kontext.
- Öppna vikter under Apache 2.0, även i en FP8-version.
- Enligt Tencent det största lyftet mellan två generationer de har mätt.
- Enligt Tencent strax före GLM 5.3 och Kimi K3 i ett blindtest med 163 interna experter och 203 programmeringsuppgifter.
- Byggd för programmering, kontorsarbete, spelutveckling och forskning, tillsammans med Tencents CodeBuddy och WorkBuddy.
- Tencent varnar för att den tidiga versionen kan resonera längre än nödvändigt och dubbelkontrollera för mycket.
Källor
- [2] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [1] tencent/Hy4-preview ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 27 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [2]
Placeringar i topplistor
- #14 · 61.62% ± 2.06
- #18 · 45.19% ± 3.46
- #21 · 1631 ± 10
- #45 · 83.60% ± 2.06
- #48 · 83.76% ± 0.41
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Hy3 jul 2026
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- WorldClaw aug 2026
- Hy3 jul 2026 · inaktuell
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026