AuK
En öppen talmodell på 1,5 miljarder parametrar som både skapar och redigerar tal utifrån vanliga instruktioner, med en snabbare variant, AuK-Flash.
- Text till tal
- Röstkloning
- Kör lokalt
 1 / 3
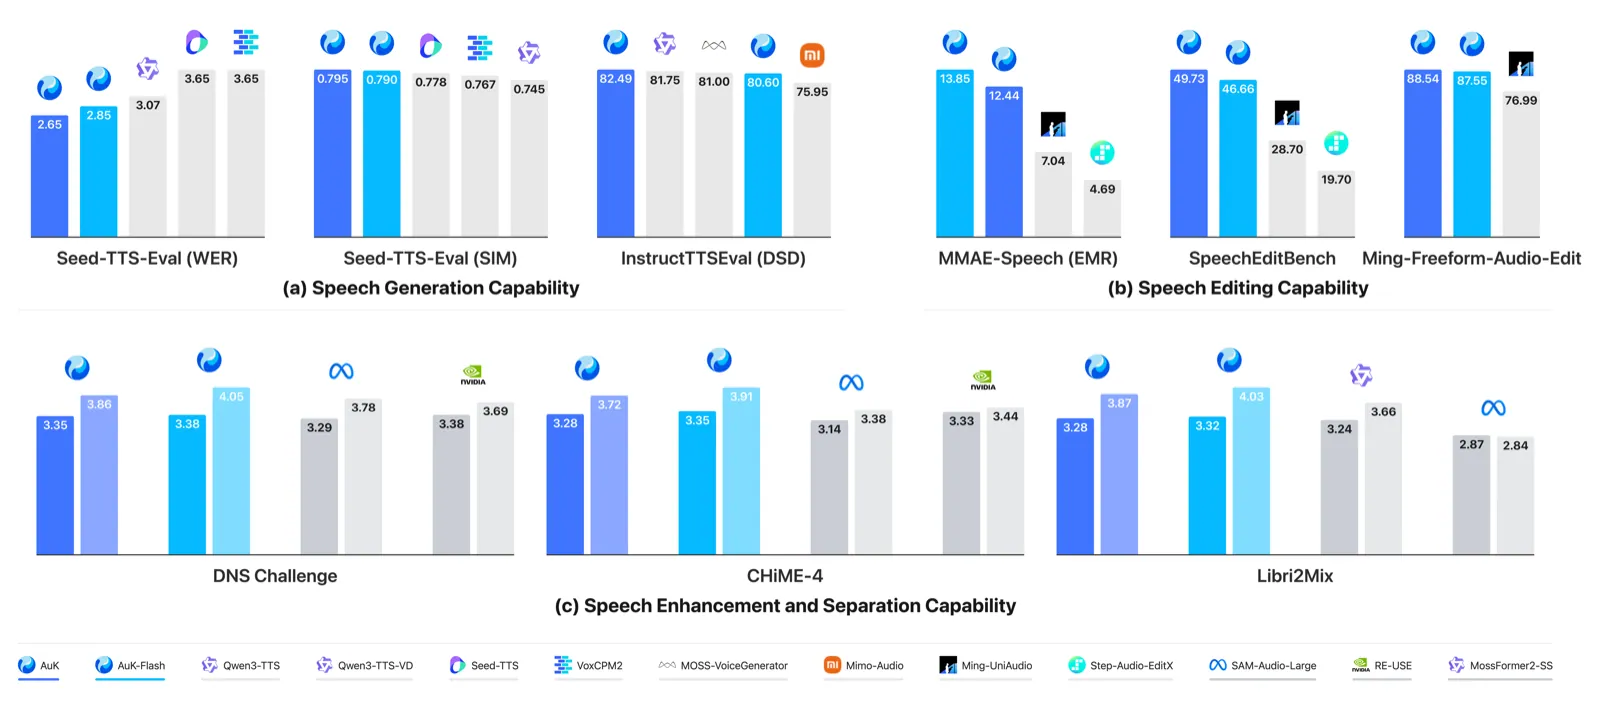
Jämförelse med andra modeller på talgenerering, redigering, brusreducering och separation (enligt Tencent) [1]
Om AuK[1][2][3][5]
AuK är en öppen grundmodell för tal som tar emot en instruktion i vanlig text, eventuellt tillsammans med en ljudfil, och svarar med nytt eller redigerat ljud. Samma modell kan läsa upp text med en given röst (röstkloning från ett exempel), skapa en röst utifrån en beskrivning, ändra vad som sägs i en inspelning, byta känsla, klangfärg eller brytning, ändra tonhöjd, tempo och volym, skriva om sångtext i en sånginspelning samt rensa brus och separera röster.
Modellen har 1,5 miljarder parametrar och kombinerar en multimodal språkmodell som tolkar instruktionen, en ljud-VAE tränad på tal, ljud och musik, och en transformer som genererar ljudet. Enligt teknikrapporten tränades den på omkring 3,03 miljarder exempel med instruktion och ljud, motsvarande 1,95 miljoner timmar. Varianten AuK-Flash är destillerad och klarar sig med fyra steg utan så kallad CFG, vilket enligt forskarna gör den 4,5 gånger snabbare med nästan samma kvalitet.
Enligt Tencent leder AuK på tester för röstkloning och instruktionsstyrd talgenerering och redigering, och är konkurrenskraftig på brusreducering och separation. Vikterna för båda varianterna finns på Hugging Face och ModelScope under MIT-licens. Efter släppet har modellen fått stöd i bland annat SGLang-Omni, vLLM-Omni och audio.cpp, kan köras med MLX på Apple Silicon, och i oktober 2026 släpptes koden för att träna egna Flash-varianter.
AuK är ett forskningsprojekt av Shanghai Jiao Tong University, Tencent Hunyuan och Shanghai Innovation Institute, och koden ligger hos Tencent Hunyuan på GitHub.
Det viktigaste[1][2][3][4]
- En modell för många taluppgifter: röstkloning, röst från beskrivning, innehållsredigering, känsla, klangfärg, tonhöjd, tempo, brusreducering och separation.
- AuK-Flash genererar i fyra steg och är enligt teknikrapporten 4,5 gånger snabbare än den fulla modellen.
- Tränad på omkring 1,95 miljoner timmar effektiv ljuddata enligt teknikrapporten.
- Vikterna är öppna under MIT-licens; AuK-Flash är märkt för kinesiska och engelska på Hugging Face.
- Kan köras lokalt, bland annat med MLX på Apple Silicon och som GGUF via audio.cpp.
- Används som baslinje i ICASSP 2027 Audio Editing Challenge.
Källor
- [1] AuK: An Open-Source Foundational Model for Speech Generation and Editing ↗Shanghai Jiao Tong University, Tencent Hunyuan och Shanghai Innovation Institute Officiell sida auk-project.github.ioPublicerad okänt datum Läst 25 okt 2026
- [4] tencent/AuK-Flash ↗Hugging Face (Tencent) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [3] AuK: An Open-Source Foundational Model for Speech Generation and Editing ↗Tencent Hunyuan Officiell sida github.comPublicerad 9 sep 2026 Läst 25 okt 2026
- [2] AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing ↗arXiv Forskningsartikel arxiv.orgPublicerad 8 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- Hy3 jul 2026 · inaktuell
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026