SCoPE
En metod som ger videogeneratorer exakt kamerastyrning genom att varje del av bilden får veta åt vilket håll kameran tittar, med under 0,1 procent nya parametrar.
- Videogenerering
- Världsmodeller
 1 / 4
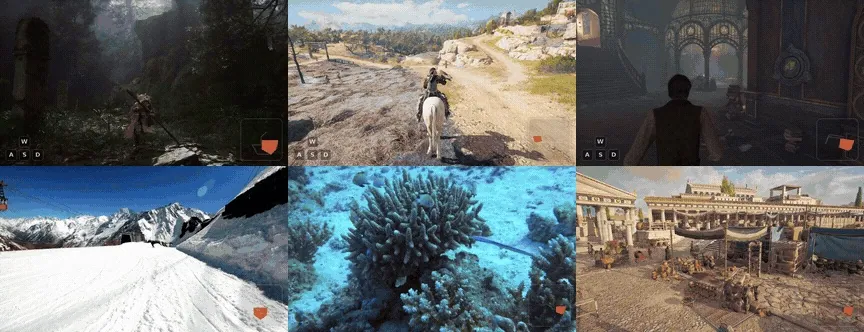
Videor skapade från en enda startbild och en vald kamerabana [1]
Om SCoPE[1][2][4][5]
SCoPE (Sightline-Coordinate Positional Encoding) är ett forskningsprojekt från ARC Lab på Tencent, University of Hong Kong och Hong Kong University of Science and Technology. Det handlar om att styra kameran i AI-genererad video: man ger modellen en startbild och en kamerabana, och videon ska följa banan exakt.
Idén är att varje liten bit av videon (en token) får sin kamerastråle, alltså linjen från kameran ut i scenen, som en andra adress utöver sin plats i bilden. Då blir kamerastyrningen en del av själva koordinatsystemet i stället för en extra styrmodul. Tillägget är litet, under 0,1 procent nya parametrar, och lämnar den förtränade modellens ursprungliga positionskodning helt orörd.
Enligt forskarna förbättrar SCoPE alla mått på kamerastyrning och bildkvalitet på Wan 2.2 i både 5B- och 14B-storlek. Vid 14B minskar rotationsfelet med 29 procent och FVD (ett mått på videokvalitet) med 43 procent jämfört med den starkaste tidigare metoden. En bieffekt är att scener hänger ihop när kameran vänder och kommer tillbaka till samma plats. Man kan också styra kameran med WASD-tangenter som i ett spel. Kod och vikter för Wan2.2-I2V-A14B finns under Apache 2.0, och det finns en webbdemo på Hugging Face.
Det viktigaste[1][2][4]
- Kamerastyrning som en del av koordinatsystemet: varje token får sin kamerastråle som andra adress.
- Under 0,1 procent nya parametrar, och den förtränade modellens positionskodning lämnas orörd.
- Enligt forskarna 29 procent lägre rotationsfel och 43 procent lägre FVD vid 14B jämfört med starkaste tidigare metod.
- Scener hänger ihop när kameran vänder tillbaka till en plats den redan visat.
- Kod och vikter under Apache 2.0, plus webbdemo på Hugging Face.
Källor
- [1] SCoPE: Sightline-Coordinate Positional Encoding for Video Diffusion Transformers ↗University of Hong Kong, HKUST och ARC Lab, Tencent Officiell sida visual-ai.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3]
- [5] Deepseek v4 0813, Qwen 3.8 27B, GLM 5.3, Grok 4.6, LTX 2.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 16 aug 2026 Läst 25 okt 2026
- [4] TencentARC/SCoPE ↗Hugging Face (TencentARC) Modellkort huggingface.coPublicerad 12 aug 2026 Läst 25 okt 2026
- [2] SCoPE: Sightline-Coordinate Positional Encoding for Video Diffusion Transformers ↗arXiv Forskningsartikel arxiv.orgPublicerad 25 jun 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-16). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- Hy3 jul 2026 · inaktuell
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026