Hunyuan3D-Buffalo 1.0
Tencent Hunyuan3D:s samlade 3D-modell som i ett och samma system kan svara på frågor om 3D-objekt, skapa 3D-modeller från text, redigera dem med vanliga instruktioner och plocka ut delar ur dem.
- 3D
- Multimodal
 1 / 3
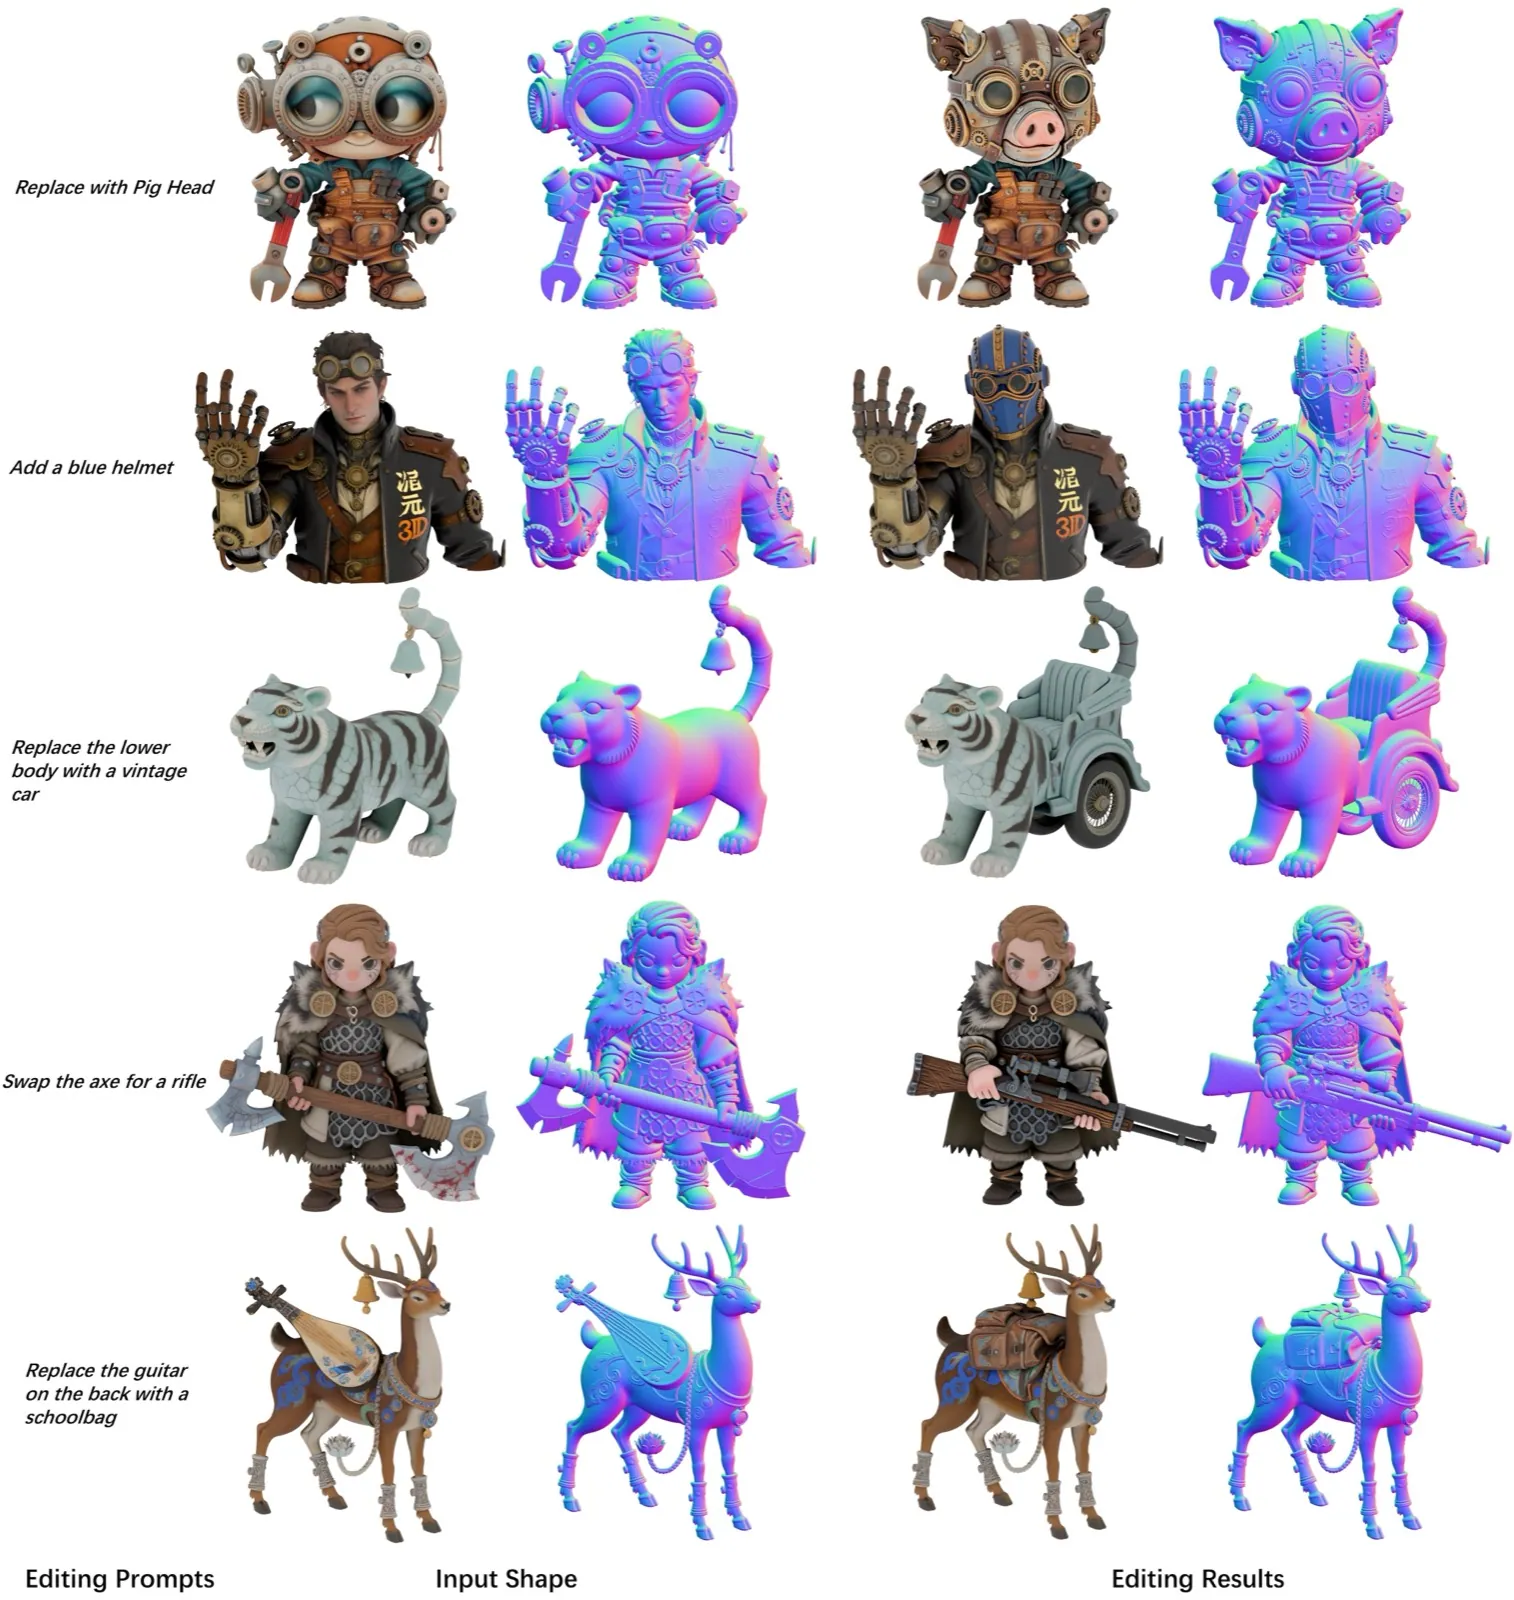
Redigering med instruktioner: originalmodellen till vänster, den redigerade till höger (till exempel "byt yxan mot ett gevär") [3]
Om Hunyuan3D-Buffalo 1.0[1][2][3][4]
Hunyuan3D-Buffalo 1.0 är ett ramverk från Tencents Hunyuan3D-team som samlar flera 3D-uppgifter i en enda modell: att förstå 3D-objekt (frågor och svar samt att peka ut delar), att skapa 3D-modeller från en textbeskrivning, att redigera en befintlig 3D-modell med instruktioner i vanligt språk och att dela upp ett objekt i delar utifrån en beskrivning.
Systemet består av två huvuddelar. En språk- och bildmodell för 3D, Hunyuan3D-VLM, står för förståelsen och kopplar ihop språket med 3D-representationen. Själva 3D-skapandet sköts av diffusionsmodeller av typen Hunyuan3D DiT. Vid redigering och uppdelning i delar utgår modellen också från originalobjektet, så att formen och de delar som inte ska ändras bevaras.
Enligt forskarna är bristen på data den stora flaskhalsen för 3D-modeller, särskilt redigeringsdata. De byggde därför en datamängd på omkring 87 miljoner exempel: 25 miljoner för förståelse, 50 miljoner text-till-3D-par och 12 miljoner redigeringspar som skapats med Nano3D-v2. Enligt forskarna når modellen toppresultat på tester för text-till-3D och redigering, och träning på både skapande och förståelse gör redigeringen bättre.
Artikeln och projektsidan släpptes i början av augusti 2026. Koden är märkt "Stay Tuned" på projektsidan, och vikter, licens och storlek framgår inte ännu.
Det viktigaste[1][2]
- En enda modell för 3D-förståelse, text till 3D, instruktionsstyrd 3D-redigering och uppdelning av objekt i delar.
- Bygger på en språk- och bildmodell för 3D (Hunyuan3D-VLM) kopplad till diffusionsmodeller (Hunyuan3D DiT).
- Tränad på omkring 87 miljoner exempel, varav 12 miljoner redigeringspar skapade med Nano3D-v2.
- Enligt forskarna toppresultat på tester för text-till-3D och 3D-redigering.
- Kod och vikter är ännu inte släppta ("Stay Tuned" på projektsidan).
Källor
- [4] WeatherNext, Xiaomi Robotics, Qwen 3.8, Wan Animate 2, SymphonyGen: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 9 aug 2026 Läst 25 okt 2026
- [1] Hunyuan3D-Buffalo 1.0: A Unified Multimodal Model for Scalable 3D Generation, Understanding, and Editing ↗Tencent Hunyuan3D Officiell sida tencent-hunyuan.github.ioPublicerad 5 aug 2026 Läst 25 okt 2026
- [3] Hunyuan3D-Buffalo 1.0 ↗Tencent Hunyuan (GitHub) Officiell sida github.comPublicerad 5 aug 2026 Läst 25 okt 2026
- [2] Hunyuan3D-Buffalo 1.0: A Unified Multimodal Model for Scalable 3D Generation, Understanding, and Editing ↗arXiv Forskningsartikel arxiv.orgPublicerad 3 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-09). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- Hy3 jul 2026 · inaktuell
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026