GAE
En forskningsmodell som skapar en världs utseende och 3D-struktur tillsammans i samma interna representation, så att genererade scener håller ihop när kameran rör sig.
- Världsmodeller
- 3D
- Videogenerering
 1 / 6
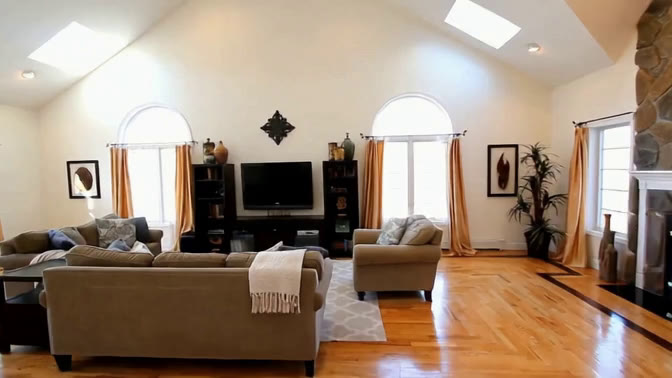
En vy ur en genererad sekvens från en enda bild [1]
Om GAE[1][2][3][4][5]
GAE (Geometry-Native Autoencoder, i artikeln "Learning a Geometry-Native Latent Space for 3D-Consistent World Generation") angriper ett vanligt problem i video- och världsgenerering: när kameran rör sig ändras ofta rummet på ett sätt som inte stämmer i 3D. Vanliga modeller genererar bara utseendet och försöker i efterhand räkna ut geometrin.
GAE lägger geometrin i själva det inre format som modellen genererar i. Forskarna tar egenskaper från 3D-modellen Depth Anything 3 (3 072 kanaler) och komprimerar dem till ett litet, välbalanserat tillstånd på 64 eller 128 kanaler. Generatorn skapar direkt i det formatet, och varje resultat kan avkodas till både färgbild, djup, kamerapositioner och ett 3D-punktmoln.
Från en enda bild och en kamerabana skapar GAE en sekvens på 81 vyer i 672 × 378 pixlar tillsammans med geometrin. Enligt forskarna ger det bäst generering (FVD 256,4) bland de jämförda formaten och bättre 3D-konsekvens. Den släppta modellen, GAE-D64-1B, har cirka en miljard parametrar och kan också skapa bilder från text.
Arbetet kommer från Hong Kong University of Science and Technology, Tencents ARC Lab, University of Hong Kong och University of Texas at Austin. Kod och vikter är släppta av Tencent ARC men får enligt licensen bara användas för akademiska ändamål, inte kommersiellt.
Det viktigaste[1][4]
- Skapar utseende och 3D-geometri tillsammans i samma interna format.
- Varje resultat ger färgbild, djup, kamerapositioner och 3D-punktmoln.
- Från en bild och en kamerabana skapas 81 vyer i 672 × 378 pixlar.
- Enligt forskarna bäst generering (FVD 256,4) bland de jämförda formaten.
- Vikterna (cirka 1 miljard parametrar) är släppta men bara för akademiskt bruk.
Källor
- [1] GAE · Geometry-Native World Generation ↗HKUST, Tencent ARC Lab, HKU och UT Austin Officiell sida jiah-cloud.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] GAE-GeometricAutoEncoder ↗Tencent ARC Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [5] GPT 6 Sol, Gemini 3.8 TTS, Grok 4.7, Opus 5.5, Mimo 2.6, WorldCrafter: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 27 sep 2026 Läst 25 okt 2026
- [6] Waifus incoming, GPT 6 Sol, Grok 4.7, Opus 5.5, Mimo 2.6, Step 5, OpenMuse: AI NEWS ↗AI Search Video youtube.comPublicerad 26 sep 2026 Läst 25 okt 2026
- [2] GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 21 sep 2026 Läst 25 okt 2026
- [4] TencentARC/GAE-D64-1B ↗Hugging Face (Tencent ARC) Modellkort huggingface.coPublicerad 17 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-09-26). [6]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- Hy3 jul 2026 · inaktuell
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026