Hy3
Den färdiga versionen av Tencents öppna språkmodell Hy3 från juli 2026, med 295 miljarder parametrar och Apache 2.0-licens, som enligt Tencent hallucinerar mindre än förhandsversionen; numera ersatt av Hy4 preview.
- Språkmodell
- Resonemang
- Kod
- Agenter
 1 / 2
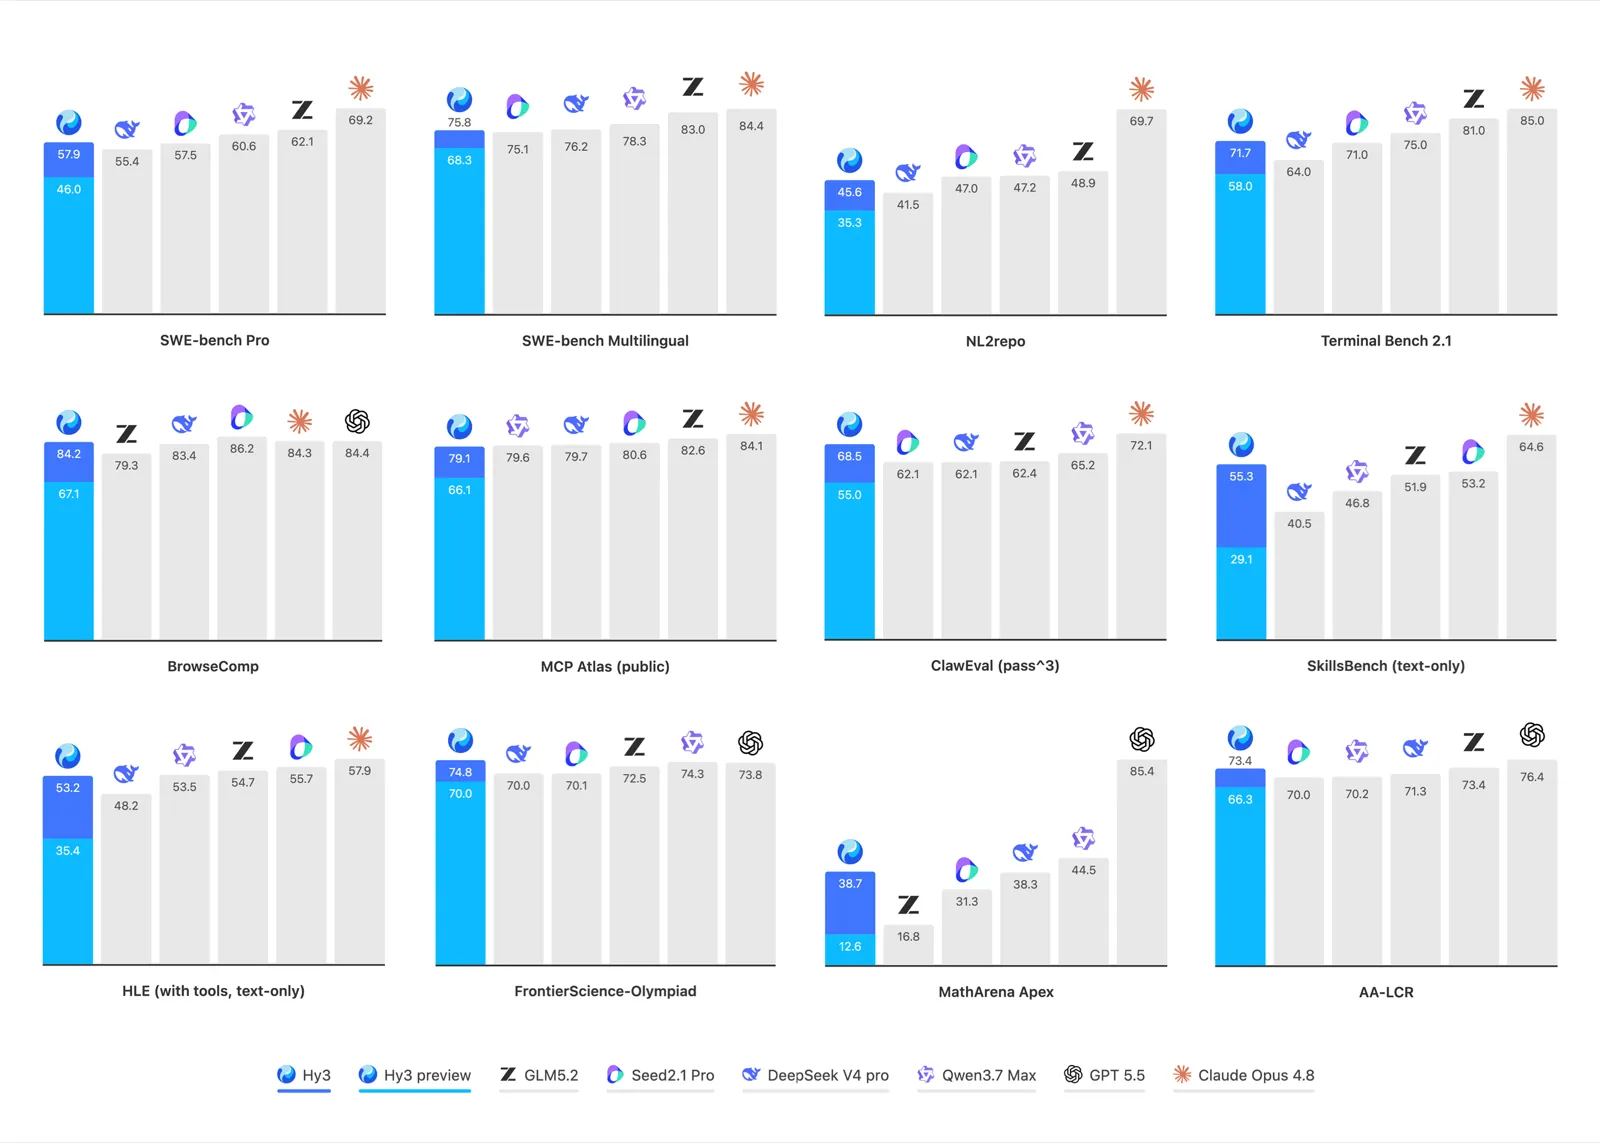
Tencents jämförelse av Hy3 och Hy3 preview mot GLM-5.2, Seed 2.1 Pro, DeepSeek V4 Pro, Qwen 3.7 Max, GPT-5.5 och Claude Opus 4.8 [1]
Om Hy3[1][2][3]
Hy3 är den färdiga versionen av språkmodellen från Tencents Hy-team (tidigare Hunyuan), och kom i juli 2026 efter förhandsversionen Hy3 preview i slutet av april. Arkitekturen är densamma: en Mixture-of-Experts-modell med 295 miljarder parametrar totalt, varav 21 miljarder används per token, 192 experter varav åtta väljs per token, 80 lager och ett kontextfönster på 256 000 tokens. Ett extra lager för att förutsäga flera tokens i taget (3,8 miljarder parametrar) gör genereringen snabbare.
Tencent skriver att man samlat in återkoppling från över 50 produkter som använt förhandsversionen, förbättrat kvaliteten och bredden på efterträningsdatan och skalat upp förstärkningsinlärningen. Verktygsanropen och utdataformaten ska ha blivit stabilare, så att resultatet på SWE-bench Verified skiljer högst 4 % mellan olika kodagenter som CodeBuddy, Cline och KiloCode. Enligt Tencents interna tester sjönk andelen hallucinationer från 12,5 % till 5,4 %, felen i allmänkunskap från 25,4 % till 12,7 % och problemen i långa konversationer från 17,4 % till 7,9 %. I en blind bedömning av 270 experter fick Hy3 2,67 av 4 mot 2,51 för GLM-5.1.
Hur mycket modellen tänker går att välja: inget resonemang (standard), lågt eller högt. Vikterna finns under Apache 2.0-licensen på Hugging Face, ModelScope, GitCode och CNB, även i en FP8-version, och modellen kan köras med vLLM och SGLang på åtta GPU:er. I slutet av augusti 2026 släppte Tencent förhandsversionen av nästa generation, Hy4 preview.
Det viktigaste[1]
- Färdig version av Hy3 preview, nu under Apache 2.0-licens.
- Enligt Tencent sjönk andelen hallucinationer från 12,5 % till 5,4 % jämfört med förhandsversionen.
- Enligt Tencent 90,4 på GPQA Diamond, 57,9 på SWE-bench Pro och 71,7 på Terminal-Bench 2.1.
- MoE med 295 miljarder parametrar, 21 miljarder aktiva, och 256 000 tokens kontext.
- Valbar tankenivå: inget, lågt eller högt resonemang.
Källor
- [2] Tencent-Hunyuan/Hy3 ↗Tencent (GitHub) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [3] tencent/Hy4-preview ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 27 aug 2026 Läst 25 okt 2026
- [1] tencent/Hy3 ↗Tencent (Hugging Face) Modellkort huggingface.coPublicerad 4 jul 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan eftersom den finns med i topplistorna. [1]
Placeringar i topplistor
- WebDev Arenaslutlig version (katalogen beskriver förhandsversionen)#62 · 1506 ± 8
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Hy3 preview 23 apr 2026
Mer från Tencent
- WeVisOne-VL 22 okt 2026
- Hy-Nomas 21 okt 2026
- Multics 12 okt 2026
- WorldPlay2 6 okt 2026
- GAE 21 sep 2026
- WorldCrafter 21 sep 2026
- AuK 9 sep 2026
- H3-World 1 sep 2026
- Hunyuan3D-Buffalo 1.0 aug 2026
- Hy4 preview aug 2026
- WorldClaw aug 2026
- SCoPE 25 jun 2026
- Hy3 preview 23 apr 2026 · inaktuell
- HY-World 2.0 16 apr 2026